Gemma 4 31B en local sur RTX 4090 : performances et VRAM
Test complet de Gemma 4 31B sur RTX 4090 avec Ollama : débit de 42 tok/s, 19 Go de VRAM occupés, gestion multilingue et pièges au chargement.
👁 123 lectures
Gemma 4 31B de Google est le modèle dense à poids ouverts le plus puissant capable de tourner intégralement sur une seule carte RTX 4090. Nous l’avons déployé via Ollama : il débite environ 42 tokens par seconde et obtient une excellente note de 9,5/10 sur nos bancs d’essai linguistiques. En contrepartie, il occupe la quasi-totalité des 24 Go de VRAM et se montre impitoyable avec les disques durs lents. Voici notre banc d’essai complet.
Données mesurées au 8 octobre 2026
- Modèle :
gemma4:31b-it-qatsous Ollama 0.40.1 (version post-entraînement quantifiée, fichier de 17,65 Go + 1,2 Go pour le module vision). - Licence : Apache 2.0 (usage commercial autorisé sans restriction).
- Vitesse : 40,7 à 43,4 tok/s en génération, environ 870 à 1 240 tok/s en traitement du prompt.
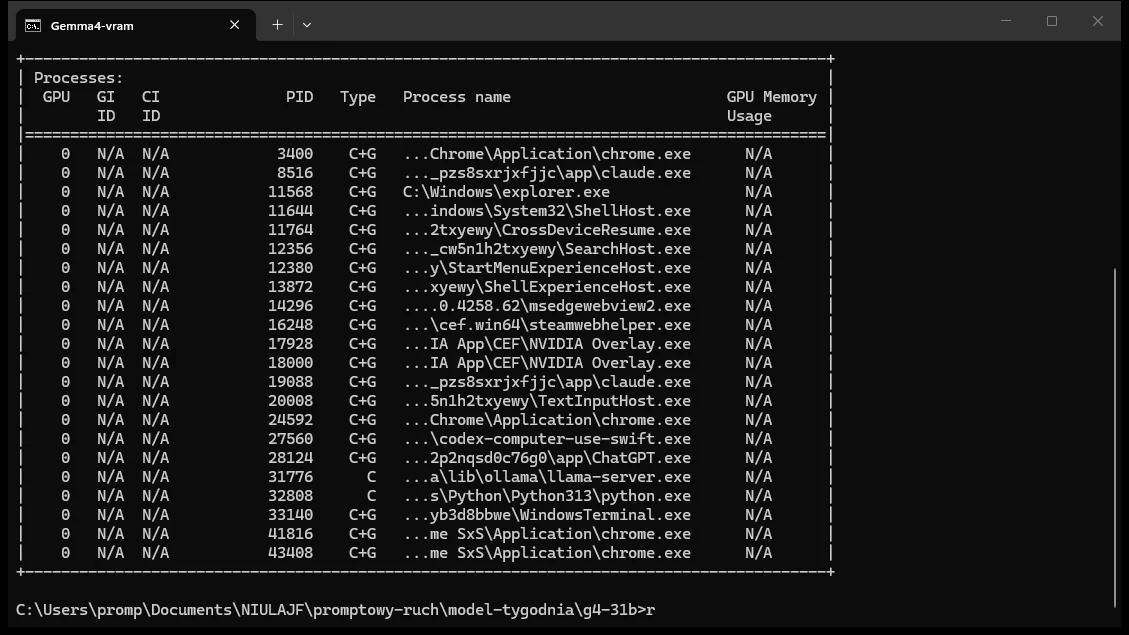
- Mémoire graphique : 19,2 Go selon Ollama, carte saturée à 24,0 Go en pic (nvidia-smi).
- Banc d’essai multilingue (testé en polonais) : 9,5/10 sur nos 5 épreuves.
- Téléchargement : 40 min 41 s. Chargement depuis un disque USB : de 1 min 53 s à 14 min 33 s.
Pourquoi tester Gemma 4 31B en priorité
Chaque semaine, nous installons un modèle ouvert sur une RTX 4090 (24 Go de VRAM, Windows 11) pour évaluer les mêmes critères : installation, vitesse de chargement, débit de génération, empreinte mémoire, qualité linguistique et conditions de licence. Les autres nouveautés récentes ne répondaient pas aux contraintes d’une exécution locale sur un seul GPU grand public :
- Ling 3.1 Flash : avec ses 560 milliards de paramètres, ses poids ne sont pas disponibles en open source (détaillé dans notre article sur Ling 3.1 Flash).
- Mistral Small 4 : malgré son appellation, il embarque 119 milliards de paramètres et reste trop lourd pour 24 Go, même fortement quantifié.
- GLM 5.3 : aucune variante allégée n’existe, et la version GLM-5.3 Flash affiche 320 milliards de paramètres.
- Hy Image 3.5 : Tencent le propose uniquement via une API, sans publier les poids.
- Qwen 3.8 27B : déjà évalué dans notre comparatif de modèles locaux.
Disponible depuis le printemps, Gemma 4 31B n’avait pas encore fait l’objet d’un banc d’essai complet sur notre machine. C’est pourtant la déclinaison la plus imposante de la gamme Gemma 4, et le seul modèle dense de ce niveau qui tourne sur une carte graphique grand public de 24 Go.
Fiche technique du modèle
| Caractéristique | Gemma 4 31B |
|---|---|
| Concepteur | Google DeepMind |
| Paramètres | 30,7 milliards (modèle dense, tous les paramètres sont actifs à chaque token) |
| Fenêtre de contexte | Jusqu’à 256 000 tokens |
| Modalités | Entrée texte et image, sortie texte uniquement |
| Langues prises en charge | Plus de 140 langues d’entraînement, environ 35 parfaitement maîtrisées selon Google |
| Licence | Apache 2.0 |
| Versions disponibles sur Ollama | gemma4:31b-it-qat (Q4_0, 19 Go), gemma4:31b-it-q8, gemma4:31b-it-bf16 (63 Go) |
| Paramètres recommandés | temperature 1.0, top_p 0.95, top_k 64 |
La variante QAT a été directement entraînée en intégrant la quantification 4 bits (Quantization-Aware Training), ce qui limite la perte de précision par rapport à une quantification classique. Avec 24 Go de mémoire graphique, c’est le seul format adapté : la version Q8 dépasse déjà les 30 Go.
Nos mesures de performances sur RTX 4090
| Métrique | Résultat | Observations |
|---|---|---|
| Téléchargement (18,2 Go) | 40 min 41 s | Débit oscillant entre 4 et 29 Mo/s |
| Premier chargement | Échec après 5 min | Erreur de délai dépassé (voir explications plus bas) |
| Chargement sur disque externe USB | 8 min 32 s et 14 min 33 s | Disque USB externe, débit moyen de 44 à 66 Mo/s |
| Chargement depuis le cache système | 1 min 53 s | Fichier déjà présent dans la mémoire vive de l’ordinateur |
| Génération de texte (5 tâches) | 40,7 à 43,4 tok/s | Contexte de 8 192 tokens, sans raisonnement long |
| Génération de texte long (1 438 tokens) | 41,3 tok/s | Environ 800 mots produits en 35 secondes |
| Génération avec contexte de 32 768 tokens | 42,2 tok/s | Aucun ralentissement constaté |
| Traitement de la requête (prompt) | 870 à 1 240 tok/s | Première requête plus lente (24 tok/s pour l’initialisation) |
| VRAM allouée selon Ollama | 19,2 Go (contexte 8k) / 19,3 Go (contexte 32k) | 100 % pris en charge par le GPU |
| VRAM globale mesurée par nvidia-smi | 21,8 Go au chargement, 24,0 Go en pic | Inclut l’affichage Windows et le navigateur (environ 0,8 Go au repos) |
Atteindre 41 à 43 tokens par seconde permet un affichage bien plus rapide que la vitesse de lecture humaine. Dans notre précédent comparatif de modèles locaux, Gemma 4 12B atteignait 104 tok/s sur 8 Go de VRAM, tandis que Qwen 3.8 27B tournait deux fois moins vite en occupant 17 Go. La version 31B est donc la plus lourde du groupe, mais conserve une fluidité remarquable pour un usage conversationnel quotidien.
La leçon du test : ne partagez pas votre carte graphique
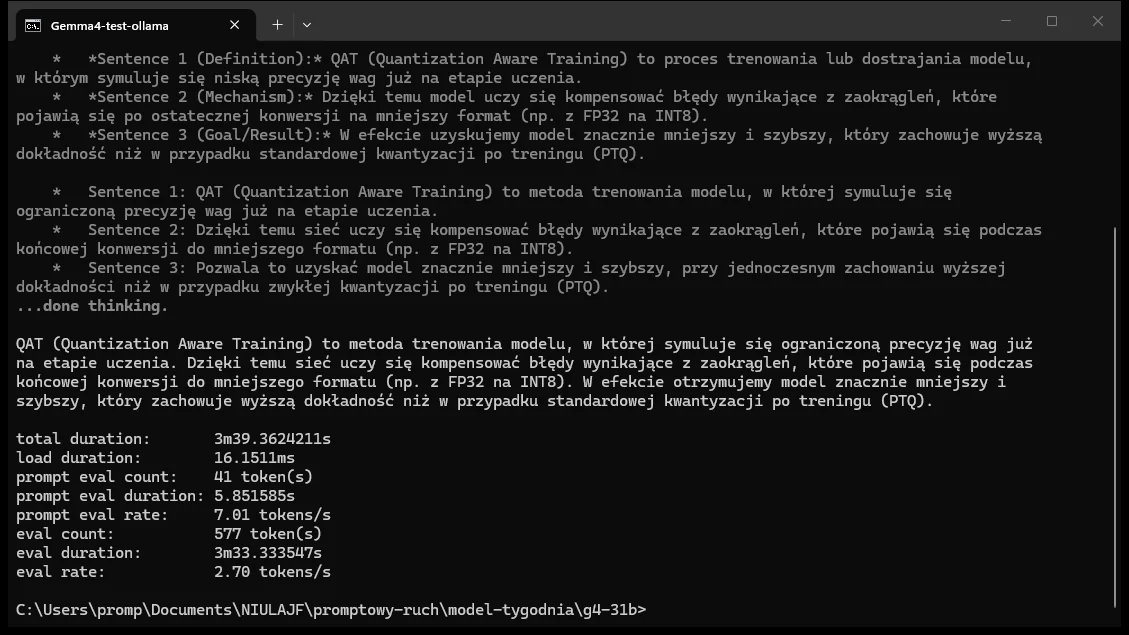
Pendant la capture de nos mesures, une génération d’images via ComfyUI s’est lancée en arrière-plan sur la même RTX 4090. La mémoire de la carte s’est retrouvée saturée (23,9 sur 24 Go). Windows a immédiatement transféré des données vers la RAM classique du PC : le débit s’est effondré de 42 à 2,7 tok/s, puis à 0,5 tok/s lors du test suivant. Ce modèle 31B ne laisse aucune marge : impossible de lancer simultanément un générateur d’images, et un simple navigateur web chargé de nombreux onglets peut suffire à saturer la mémoire restante.
Banc d’essai linguistique : 5 tâches complexes
Pour mesurer la tenue du modèle hors de l’anglais, nous lui avons soumis une série de 5 épreuves exigeantes (que nous avons testées en polonais pour éprouver sa gestion des déclinaisons, de l’orthographe complexe et de la culture locale). Chaque exercice est noté sur 2 points.
| Tâche | Score | Résultat observé |
|---|---|---|
| Courriel d’excuses avec déclinaisons complexes | 1,5/2 | Déclinaison de la ville impeccable, proposition commerciale correcte, mais omission du nom de famille du destinataire. |
| Correction de plus de 8 fautes pièges | 2/2 | Détection parfaite : accords grammaticaux, ponctuation et homophones tous corrigés. |
| Calcul de facture (3 lignes, TVA 23 % et 5 %) | 2/2 | TVA de 1 314,00 et total TTC de 7 073,90 : calcul rigoureux et exact au centime près. |
| 5 questions de culture générale et géographie | 2/2 | Excellente exactitude factuelle sur les chefs-lieux, auteurs classiques et altitudes. |
| 3 expressions idiomatiques expliquées | 2/2 | Significations limpides et exemples d’utilisation naturels. |
| Total | 9,5/10 |
Nous avons uniquement noté deux légers défauts de forme : le modèle abuse de la syntaxe Markdown et a inséré des flèches au format LaTeX ($rightarrow$) peu adaptées à une interface de messagerie standard. De plus, lors de l’exécution avec raisonnement (activé par défaut sous ollama run), sa réflexion interne s’élabore en anglais avant de produire sa réponse dans la langue demandée.
Courriel d’excuses - réponse complète du modèle (185 tokens, 42,5 tok/s)
Consigne : Rédigez un court e-mail (moins de 120 mots) à un client, M. Grzegorz Brzęczyszczykiewicz de Szczebrzeszyn, pour vous excuser d’un retard de 5 jours sur la livraison d’une chaise de bureau. Proposez une remise de 10 % sur la prochaine commande avec un ton courtois. (Test réalisé avec le texte source suivant : „Napisz krótki e-mail do klienta, pana Grzegorza Brzęczyszczykiewicza ze Szczebrzeszyna…”).
Temat: Przeprosiny za opóźnienie w dostawie zamówienia

Szanowny Panie Grzegorzu,

chciałbym najmocniej przeprosić za 5-dniowe opóźnienie w dostawie Pana krzesła biurowego do Szczebrzeszyna. Bardzo nam przykro z powodu zaistniałej sytuacji.

W ramach rekompensaty przygotowaliśmy dla Pana kod rabatowy o wartości 10% na kolejne zamówienie w naszym sklepie: RABAT10.

Mamy nadzieję, że produkt spełni Pana oczekiwania, a ten gest pozwoli nam zachować Pana zaufanie. W razie dodatkowych pytań pozostaję do dyspozycji.

Z poważaniem,

[Twoje Imię i Nazwisko]
[Nazwa Firmy]
Correction de texte - réponse complète du modèle (306 tokens, 40,7 tok/s)
Consigne : Corriger les fautes d’un texte truffé de pièges grammaticaux et fournir la liste des modifications sous forme de points clés.
Oto poprawiony tekst:

„Wczoraj poszedłem do sklepu, żeby kupić chleb, ale okazało się, że był zamknięty. W poniedziałek na pewno pójdę jeszcze raz, bo mam nadzieję, że będzie otwarty. Moja koleżanka, która tam pracuje, mówiła, że w ogóle nie zamykają przed 18.”

Lista poprawek:
* poszłem $rightarrow$ poszedłem (błąd fleksyjny)
* sklepu żeby $rightarrow$ sklepu, żeby (brak przecinka przed spójnikiem)
* okazało się że $rightarrow$ okazało się, że (brak przecinka przed spójnikiem)
* napewno $rightarrow$ na pewno (pisownia rozdzielna)
* pójde $rightarrow$ pójdę (brak polskiego znaku)
* nadzieje $rightarrow$ nadzieję (brak polskiego znaku)
* że będzie otwarte $rightarrow$ że będzie otwarty (błąd składniowy - sklep jest rodzaju męskiego)
* koleżanka która $rightarrow$ koleżanka, która (brak przecinka przed zdaniem podrzędnym)
* pracuje mówiła $rightarrow$ pracuje, mówiła (brak przecinka zamykającego zdanie podrzędne)
* wogóle $rightarrow$ w ogóle (pisownia rozdzielna)
Calcul d’une facture avec TVA - réponse complète du modèle (176 tokens, 41,4 tok/s)
Consigne : Calculer la TVA pour chaque article (ordinateur portable 4200,00 avec TVA 23 %, livre 59,90 avec TVA 5 %, formation 1500,00 avec TVA 23 %), puis afficher le total hors taxe, la TVA globale et le montant TTC arrondi au centime.
Oto wyliczenia dla poszczególnych pozycji:

*   Laptop: netto 4200,00 $rightarrow$ VAT (23%): 966,00
*   Książka: netto 59,90 $rightarrow$ VAT (5%): 3,00
*   Usługa szkolenia: netto 1500,00 $rightarrow$ VAT (23%): 345,00

Suma netto: 5759,90
Suma VAT: 1314,00
Suma brutto: 7073,90

BRUTTO = 7073,90
Questions de culture générale - réponse complète du modèle (60 tokens, 43,4 tok/s)
Consigne : Répondre brièvement à 5 questions géographiques et historiques (villes sièges régionaux, auteur littéraire, sommet culminant, date historique, découpage administratif).
1) Zielona Góra i Gorzów Wielkopolski.
2) Bolesław Prus.
3) 2499 m n.p.m., Rysy.
4) 1410.
5) 16.
Expressions idiomatiques - réponse complète du modèle (303 tokens, 42,0 tok/s)
Consigne : Expliquer en langage courant trois expressions imagées et fournir un exemple pour chacune.
Oto wyjaśnienia tych frazeologizmów napisane prostym językiem:

1. Wyjść jak Zabłocki na mydle
*   Znaczenie: Oznacza ponieść klęskę, sromotnie przegrać lub zostać z niczym, mimo że miało być inaczej (często po tym, jak ktoś wierzył w łatwy zysk).
*   Przykład: *Kupiłem ten tani telefon przez internet, ale okazał się zepsuty i sprzedawca nie chce oddać pieniędzy - wyszedłem jak Zabłocki na mydle.*

2. Rzucać grochem o ścianę
*   Znaczenie: Mówić do kogoś, kto zupełnie nie słucha, nie rozumie lub ignoruje nasze argumenty i prośby.
*   Przykład: *Tłumaczę synowi już godzinę, że musi posprzątać pokój, ale to jak rzucanie grochem o ścianę.*

3. Mieć muchy w nosie
*   Znaczenie: Być w złym humorze bez wyraźnego powodu, być marudnym lub poirytowanym.
*   Przykład: *Nie podchodź teraz do Anny, bo od samego rana ma muchy w nosie i na wszystko się gniewa.*
Licence : ce qui est autorisé
Gemma 4 est distribué sous licence Apache 2.0. Il s’agit d’une nette évolution par rapport à Gemma 3, qui imposait des conditions d’utilisation propriétaires édictées par Google. Concrètement :
- Vous avez le droit de l’exploiter dans des projets commerciaux, y compris dans une solution vendue à des tiers.
- Vous pouvez ajuster le modèle (fine-tuning) et redistribuer vos versions modifiées en mentionnant la licence d’origine.
- Vous ne payez aucune redevance à Google : vos seuls coûts sont le matériel et l’électricité.
Guide étape par étape pour l’installer sur votre machine
- Téléchargez et installez Ollama depuis le site officiel ollama.com (nous utilisons la version 0.40.1). Si vous stockez vos modèles sur un second disque de stockage, configurez la variable système
OLLAMA_MODELS(par exempleD:AIollama). Retrouvez tous les réglages détaillés dans notre guide pratique d’Ollama. - Téléchargez le modèle (environ 18 Go) :
ollama pull gemma4:31b-it-qat
- Augmentez le délai d’attente si vous utilisez un disque externe. Par défaut, Ollama abandonne après 5 minutes. Avec notre support USB, le transfert en mémoire a réclamé entre 8 et 14 minutes, déclenchant l’erreur « timed out waiting for llama-server to start ». Sous PowerShell (après avoir fermé Ollama dans la barre des tâches) :
$env:OLLAMA_LOAD_TIMEOUT = "30m"
ollama serve
La méthode idéale reste évidemment d’installer vos modèles sur un SSD NVMe rapide.
- Lancez le modèle avec mesure des performances dans une seconde console :
ollama run gemma4:31b-it-qat --verbose "Explique en 3 phrases le principe de la quantification QAT."
L’option
--verbosecalcule automatiquement l’« eval rate » (votre débit en tokens par seconde). Pour désactiver les étapes de réflexion intermédiaire, ajoutez l’argument--think=false. - Contrôlez l’allocation mémoire sur le GPU :
ollama ps
nvidia-smi
La colonne PROCESSOR doit afficher « 100% GPU ». Si une répartition CPU/GPU apparaît, réduisez la taille du contexte ou fermez les logiciels tiers qui mobilisent la VRAM.
- Personnalisez la fenêtre de contexte via l’API (méthode employée pour nos tests de charge) :
curl http://127.0.0.1:11434/api/chat -d "{"model":"gemma4:31b-it-qat","messages":[{"role":"user","content":"Bonjour"}],"think":false,"options":{"num_ctx":32768}}" - Libérez la mémoire vidéo une fois votre session terminée :
ollama stop gemma4:31b-it-qat
À qui s’adresse Gemma 4 31B en exécution locale ?
- Recommandé si vous possédez une carte de 24 Go (RTX 4090, RTX 3090 ou future RTX 5090) et recherchez un niveau linguistique irréprochable sans transmettre vos données à un serveur distant.
- Recommandé pour traiter des documents sensibles, relire des textes ou rédiger des résumés professionnels : 42 tok/s offrent un confort de travail parfait.
- Déconseillé si votre configuration dispose de 16 Go de VRAM ou moins : optez pour Gemma 4 12B, qui s’était révélé excellent lors de nos benchmarks tout en fonctionnant 2,5 fois plus vite.
- Déconseillé si vous souhaitez générer simultanément des images ou des animations vidéo sur la même carte graphique.
Pour explorer les autres solutions open source (génération de texte, d’images et de vidéo), consultez notre panorama sur l’IA en local. Pour calibrer votre matériel selon la taille des architectures, référez-vous à notre synthèse sur la VRAM nécessaire pour l’IA.
Foire aux questions
Combien de VRAM réclame Gemma 4 31B ?
En déclinaison QAT (4 bits), Ollama réserve 19,2 Go de mémoire avec un contexte de 8 000 tokens et 19,3 Go pour 32 000 tokens. La consommation globale de la carte atteignant 24 Go en pic, un GPU équipé de 24 Go de VRAM dédié exclusivement à cette tâche est indispensable.
Gemma 4 31B tourne-t-il correctement sur une RTX 4090 ?
Oui, l’intégralité du modèle tient sur le processeur graphique, avec un débit mesuré entre 40 et 43 tokens par seconde. Seule obligation : ne lancer aucun autre logiciel gourmand en GPU en parallèle, sous peine de voir la cadence s’effondrer entre 0,5 et 2,7 tok/s.
Quelle est la qualité rédactionnelle de Gemma 4 31B hors de l’anglais ?
Les résultats sont remarquables : nous avons relevé une note de 9,5 sur 10 sur des tâches complexes de grammaire, de logique et de calcul, sans aucune erreur factuelle.
Peut-on utiliser Gemma 4 dans un cadre commercial ?
Oui. La licence Apache 2.0 permet une exploitation commerciale libre, ainsi que la modification et la diffusion du modèle sans redevance.
Pourquoi Ollama échoue-t-il à charger Gemma 4 31B ?
Le problème provient généralement d’un disque de stockage trop lent : le temps d’attente par défaut d’Ollama est limité à 5 minutes. Définissez la variable OLLAMA_LOAD_TIMEOUT=30m ou basculez vos fichiers sur un SSD plus performant. Veillez également à fermer les applications occupant votre mémoire graphique.
Vaut-il mieux choisir Gemma 4 31B ou la version 12B ?
Sur une carte de 24 Go, privilégiez le 31B pour une qualité de raisonnement maximale. Avec une carte plus modeste ou si vous cherchez avant tout la vitesse brute, Gemma 4 12B reste le meilleur compromis (104 tok/s sur 8 Go de mémoire dans nos tests).
Sources et protocole de test
- Fiche technique officielle de Gemma 4 31B sur Hugging Face (spécifications, licence et paramètres recommandés).
- Catalogue des versions de gemma4 sur Ollama.
- Relevés techniques : machine de test équipée d’une RTX 4090 24 Go, Windows 11, Ollama 0.40.1, relevés effectués le 8 octobre 2026.
More on this from PROMPTIF

 benchmarks·Test de Wan 3.0 d’Alibaba : le modèle vidéo n°1 à l’épreuveWan 3.0 d'Alibaba génère 30 s de vidéo avec audio à 0,10 $/s. Nous avons testé dialogue, texte à l'écran, plan-séquence et création depuis un PDF.