Modèles de décision IA : benchmark Decision Index
Cloudflare Clef et AWS Strands Decider : découvrez le fonctionnement des modèles de décision IA, leurs prix et notre banc d'essai complet sur GPU.
👁 137 lectures
Un modèle de décision est un modèle d’IA qui ne rédige aucun texte libre : il sélectionne une réponse dans une liste prédéfinie et indique son niveau de confiance exact. Au lieu d’une phrase approximative comme « ce message concerne probablement les paiements », vous obtenez directement paiements: 0,97, permettant à votre code d’agir immédiatement. Le 1er octobre 2026, Cloudflare a dévoilé ses modèles ouverts Clef et Clef-flash, tandis qu’AWS publiait le même jour Strands Decider 2B. J’ai évalué ces deux solutions sur une carte RTX 4090 avec 30 tickets d’assistance (testés en polonais).
Artificial Analysis Decision Index : premier classement indépendant des modèles de décision (13 octobre 2026)
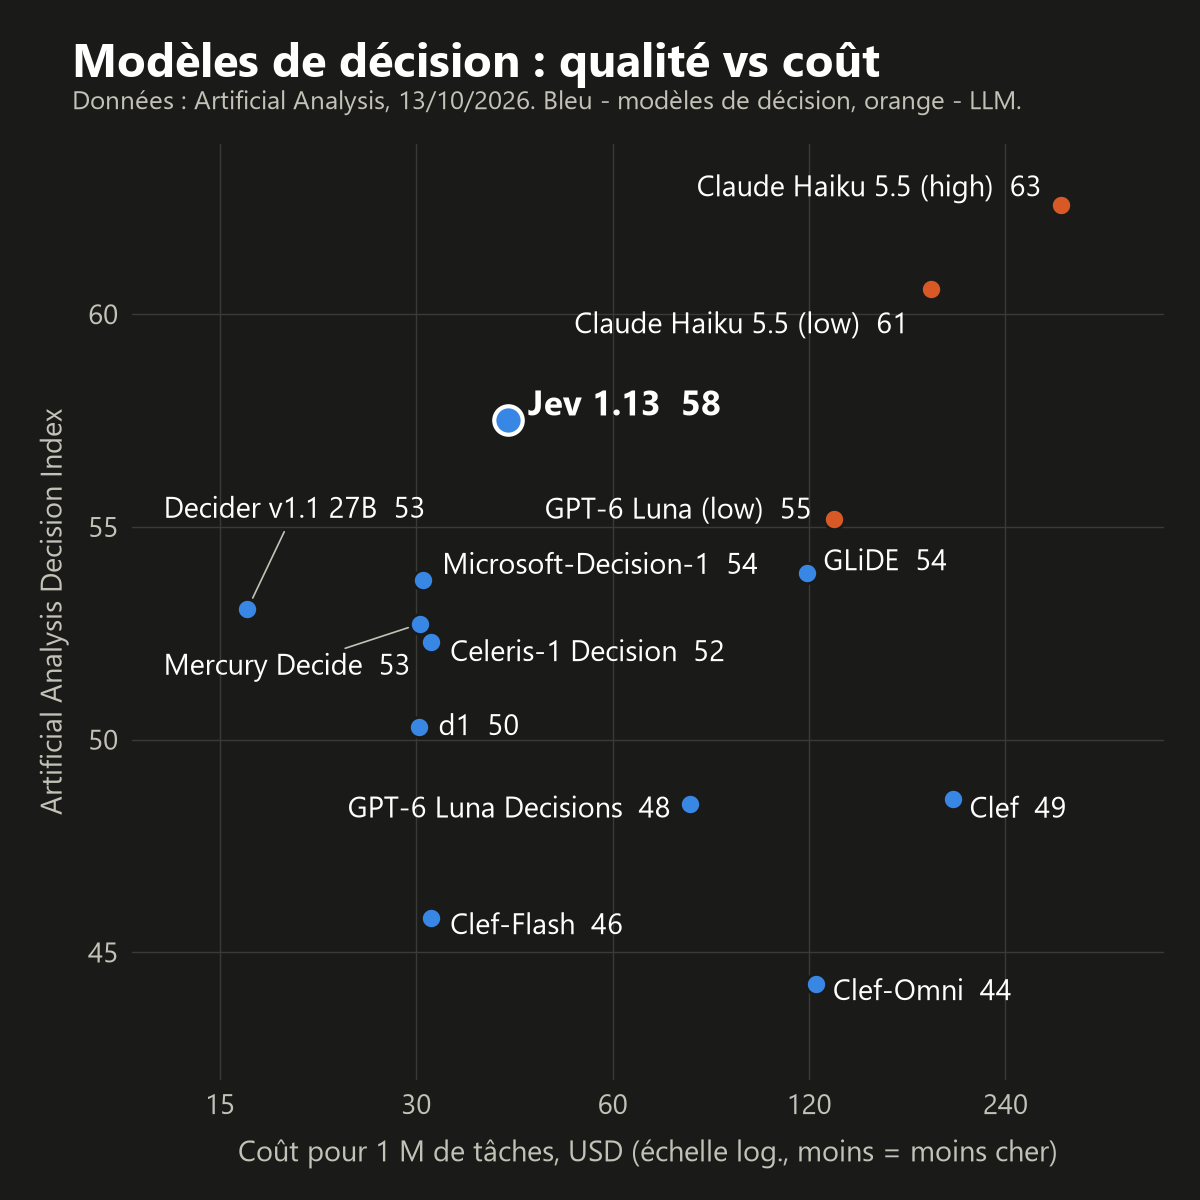
Un modèle de décision ne rédige pas de texte. Il reçoit une question structurée - choisir une option, oui ou non, une note - et renvoie une probabilité pour chaque option autorisée en un seul appel. Le 13 octobre 2026, Artificial Analysis (AA) a publié le Decision Index v1.0, qui compare 11 modèles de ce type entre eux et avec des LLM classiques répondant aux mêmes tâches via des sorties structurées. Tous les chiffres ci-dessous proviennent du classement AA au 13 octobre 2026 ; le tableau en direct peut évoluer.
Classement des 11 modèles de décision
| Modèle (entreprise) | Index | Coût pour 1M de tâches | Temps médian |
|---|---|---|---|
| Jev 1.13 (TypeSafe) | 57,5 | 41,5 USD | 127 ms |
| GLiDE (Fastino Labs) | 53,9 | 119,0 USD | 217 ms |
| Microsoft-Decision-1 (Microsoft) | 53,8 | 30,7 USD | 207 ms |
| Decider v1.1 27B (Perplexity) | 53,1 | 16,5 USD | 170 ms |
| Mercury Decide (Inception) | 52,7 | 30,4 USD | 500 ms |
| Celeris-1 Decision (Celeris) | 52.3 | 31,6 USD | 63 ms |
| d1 (Liquid AI) | 50,3 | 30,3 USD | 299 ms |
| Clef (Cloudflare) | 48,6 | 199,4 USD | 309 ms |
| GPT-6 Luna Decisions (OpenAI) | 48,5 | 78,9 USD | 168 ms |
| Clef-Flash (Cloudflare) | 45,8 | 31,6 USD | 298 ms |
| Clef-Omni (Cloudflare) | 44,3 | 123,1 USD | 172 ms |
À titre de comparaison, les LLM sur les mêmes tâches : Claude Haiku 5.5 (low reasoning) 60,6 à 184 USD pour 1M de tâches et 1 434 ms, GPT-6 Luna (low) 55,2 à 131 USD et 1 500 ms, Claude Opus 5.5 (max) 79,0 à 51 295 USD et 3 571 ms.
Ce que mesurent les quatre tests
Chaque test représente 25 % de l’indice :
- AA-Omniscience-Decision - 500 questions de connaissances privées avec 5 options (4 réponses plus « Je ne sais pas ») ; moitié pour l’exactitude, moitié pour le taux de non-hallucination, c’est-à-dire la fréquence à laquelle un modèle qui ignore la réponse choisit « Je ne sais pas ».
- HLE-MultiChoice - 513 questions à choix multiples exclusivement textuelles issues de Humanity’s Last Exam (raisonnement complexe).
- When2Call (NVIDIA) - répondre directement, appeler un outil, demander plus d’informations ou indiquer qu’il ne peut pas aider.
- WildGuardTest (Ai2) - la requête est-elle nuisible, s’agit-il d’un refus, la réponse est-elle nuisible (score F1 moyen).
Pour les modèles de décision, AA retient l’option avec la probabilité la plus élevée (pour oui/non : oui lorsque p est supérieur ou égal à 0,5). Les LLM reçoivent un prompt système fixe et répondent en JSON. Les modèles de décision sont facturés uniquement sur l’entrée, les LLM sur l’entrée et la sortie.
Points forts et faiblesses par test
- La connaissance est le point faible de tous les modèles de décision : 28 à 41 % d’exactitude contre 52 % pour Claude Haiku 5.5 (low) et 66 % pour GPT-6 Luna (low). Jev 1.13 obtient 34,6 %, Microsoft-Decision-1 28,2 %, le meilleur étant d1 avec 41,0 % - mais d1 ne répond presque jamais « Je ne sais pas » (1,7).
- Dire « Je ne sais pas » : Microsoft-Decision-1 39,8, Jev 1.13 35,2, Mercury Decide 32,0 ; aucun autre modèle de décision ne dépasse 17, Celeris-1 obtient 0.
- Raisonnement (HLE-MultiChoice) : Jev 1.13 20,9, tous les autres modèles de décision atteignent 15,4 ou moins.
- Appel d’outils (When2Call) : GLiDE et Celeris-1 83,7 - devant Claude Haiku 5.5 low (72,6) et GPT-6 Luna low (77,0).
- Classification de sécurité (WildGuardTest) : GLiDE 95,1, le meilleur résultat de tout le tableau, y compris les LLM ; Decider 93,8, Jev 93,6, Claude Haiku 5.5 low 92,6. Le plus faible : GPT-6 Luna Decisions 82,8.
- Selon AA, tous les modèles de décision présentent un excès de confiance, principalement sur les connaissances et le raisonnement ; le calibrage sur When2Call et WildGuardTest est relativement bon.
Coût par rapport à la qualité
- Sur la frontière de Pareto coût-qualité, AA retient trois modèles : Decider v1.1 27B (16,5 USD pour 1M de tâches), Microsoft-Decision-1 (30,7 USD) et Jev 1.13 (41,5 USD).
- Claude Haiku 5.5 (low) devance Jev 1.13 de 3 points, mais d’après AA, il est 11 fois plus lent et 4,4 fois plus cher.
- Classification seule (WildGuardTest, pour 1M de tâches) : Decider 12,1 USD, Microsoft-Decision-1 12,5 USD, Mercury Decide 12,6 USD, Celeris-1 16,0 USD, Jev 22,8 USD, GLiDE 84,3 USD - contre 91,5 USD pour Claude Haiku 5.5 (low) et 3 774 USD pour Claude Opus 5.5 (low).
Prix (USD pour 1M de jetons d’entrée, sortie gratuite, relevé au 13 octobre 2026)
| Modèle | Producteur | OpenRouter |
|---|---|---|
| Jev 1.13 | 0,042 | 0,042 |
| GLiDE | 0,15 (toutes les étapes internes facturées) | - |
| Microsoft-Decision-1 | 0,042 (Microsoft Foundry) | 0,042 |
| Decider v1.1 27B | 0,02 | 0,02 |
| Mercury Decide | 0,04 (promo 0,02) | 0,02 |
| Celeris-1 Decision | 0,04 | - |
| d1 | 0,04 | 0,04 |
| Clef | 0,24 (Workers AI) | à partir de 0,042 |
| Clef-Flash | 0,038 | à partir de 0,021 |
| Clef-Omni | 0,15 | 0,15 |
| GPT-6 Luna Decisions | 0,10 (+10 % pour le traitement UE/EEE) | 0,10 |
Quand choisir un modèle de décision plutôt qu’un LLM
- La réponse appartient à un ensemble fini d’options : aiguillage de tickets vers un département, indicateurs oui/non, modération, choix d’appeler un outil ou non. C’est ce que mesurent trois des quatre tests d’AA, et où les modèles de décision égalent ou surpassent les petits LLM.
- Le volume et la latence sont critiques : les modèles de décision répondent en environ 60 à 500 ms (médiane AA) et coûtent quelques dizaines de dollars pour 1M de tâches, tandis que les LLM prennent 1,4 à 3,6 s sur les mêmes tâches et coûtent à partir d’environ 130 USD pour 1M de tâches.
- Vous recherchez une probabilité, pas seulement un label - par exemple pour transférer les cas à faible confiance à un humain ou à un modèle plus robuste.
- Un LLM reste le meilleur choix pour les questions de connaissances générales (les modèles de décision plafonnent à 28-41 % sur le test de connaissances d’AA) et pour toute tâche nécessitant une réponse rédigée.
Notre test sur 50 tickets de support dans une langue autre que l’anglais
Le 13 octobre 2026, nous avons évalué 9 modèles de décision via OpenRouter et deux LLM (Claude Haiku 5.5 et GPT-6 Luna, raisonnement faible) sur 50 tickets de support e-commerce rédigés en polonais (département parmi 7 options plus un indicateur d’urgence) et 10 échanges de type When2Call. Les réponses de référence ont été établies avant le test. L’échantillon étant restreint, ces résultats sont indicatifs.
- Département sur 47 tickets sans ambiguïté : 41 à 44 réponses correctes pour les modèles de décision, 45 pour les deux LLM. Jev 1.13 a obtenu le résultat le plus bas (41) ; Microsoft-Decision-1, Decider, Mercury Decide et Clef 44.
- Urgence : Decider et GPT-6 Luna Decisions 48 sur 50 ; Microsoft-Decision-1 42 sur 50 (8 fausses alertes avec un seuil à 0,5).
- Décision d’outil : 7 modèles de décision et les deux LLM à 10 sur 10, Mercury Decide 9, Clef-Flash et Clef-Omni 6.
- Latence médiane mesurée depuis l’Europe via OpenRouter : modèles de décision 310 à 619 ms, Claude Haiku 5.5 1 689 ms, GPT-6 Luna 1 371 ms.
- Coût mesuré pour 1M de tâches comparables : Mercury Decide 4,4 USD (prix promo), Decider 7,8 USD, Microsoft-Decision-1 11,5 USD, Jev 1.13 26,8 USD (ayant consommé environ 640 jetons d’entrée par tâche sur ce texte contre environ 275 pour Microsoft-Decision-1), Claude Haiku 5.5 96,7 USD.
- La confiance sert de filtre : avec une confiance supérieure ou égale à 0,9, Jev a vu juste sur 37 tickets sur 39, Decider sur 39 sur 41. Une cascade - Microsoft-Decision-1 en premier, Claude Haiku 5.5 uniquement sous 0,8 de confiance - a obtenu 45 sur 47, soit le même score que Haiku seul, pour environ 18 USD au lieu d’environ 101 USD pour 1M de classifications.
Comment y accéder
OpenRouter propose 9 des 11 modèles classés via un point de terminaison distinct, POST https://openrouter.ai/api/alpha/decisions (champs state et questions) - les modèles de décision ne fonctionnent pas via /chat/completions. GLiDE et Celeris-1 Decision sont accessibles uniquement via les API de leurs concepteurs. Decider v1.1 27B (Apache-2.0, environ 49 Gio de mémoire GPU), d1-3B (LFM Open License, gratuit en dessous de 10 millions USD de chiffre d’affaires annuel) et les modèles Clef de Cloudflare (Apache-2.0) sont en poids ouverts.
Articles sur les modèles de décision
- Decision Index v1.0 : le benchmark d’Artificial Analysis
- Modèles de décision ou LLM : quel choix pour vos flux
- Prix des modèles de décision : comparatif des coûts 2026
- Quel modèle de décision choisir selon vos besoins réels
Sources
- Artificial Analysis - Decision Index announcement
- Artificial Analysis - Decision Index leaderboard
- Artificial Analysis - Decision Index methodology
- OpenRouter - Decisions API
- TypeSafe - Jev models
- Fastino - GLiDE
- Microsoft - Microsoft-Decision-1 in Foundry
- Perplexity - Decisions API
- Inception - Mercury Decide
- Celeris - Celeris-1 Decision
- Liquid AI - d1
- Cloudflare - Clef
- OpenAI - Decisions guide
Point de situation au 7 octobre 2026
- Cloudflare Clef (27B, fondé sur Qwen3.8-27B) et Clef-flash (9B, fondé sur Qwen3.5-9B) : licence Apache-2.0, poids hébergés sur Hugging Face, déploiement sur Workers AI à environ 0,21 EUR (0,24 USD) et 0,08 EUR (0,09 USD) par million de tokens d’entrée. (Taux BCE du 12/10/2026 : 1 EUR = 1,1181 USD ; source : https://www.ecb.europa.eu/stats/eurofxref/eurofxref-daily.xml).
- Strands Decider 2B d’AWS : licence Apache-2.0, poids, jeux d’entraînement et scripts publics, fonctionne même sur CPU.
- Kev 1.0 (Jared Palmer) : suite de modèles ouverts de 0,8B à 27B, uniquement en anglais.
- Aplomb 1 d’EmpirioLabs (lancé le 29.09) : 5,3B, gère texte, JSON, image, vidéo et audio avec un contexte de 1 million de tokens, licence propriétaire, API à environ 0,018 EUR (0,02 USD) par million de tokens d’entrée. En savoir plus.
- Ces solutions partagent l’interface d’API introduite par Jev de TypeSafe (System One), qui a inauguré cette catégorie le 15 septembre.
- Notre test : Clef-flash et Strands Decider ont classé sans faute 30 tickets sur 30 (testés en polonais), avec des temps médians de traitement respectifs de 112 et 135 ms par décision.
Qu’est-ce qu’un modèle de décision ?
Un grand modèle linguistique traditionnel (LLM) produit du texte mot par mot. Même en le contraignant à répondre par un seul terme ou un objet JSON, il poursuit un processus génératif standard. Un modèle décisionnel fonctionne sur un tout autre principe :
- Il reçoit un état : texte d’un message, charge utile JSON, ou image dans le cas de Clef.
- Il reçoit une série de questions associées à une liste close de choix : par exemple « quel département ? » avec les options
paiements,livraison,retours… - Il traite cet état en une seule passe et retourne directement une probabilité mathématique pour chaque option autorisée. Aucune génération libre, aucun décodage textuel instable, et aucune possibilité d’obtenir une réponse hors liste.
L’ensemble de ces architectures adopte les trois formats de requêtes formalisés par Jev de TypeSafe :
| Type | Structure de la demande | Résultat obtenu |
|---|---|---|
choice |
Sélection d’une option dans une liste | Option retenue, indice de certitude et répartition des probabilités |
noul |
Question binaire (oui / non) | Probabilité de l’option « oui » entre 0 et 1 |
score |
Évaluation graduée (ex. aucun impact, faible, fort, critique) | Niveau estimé, indice de certitude et distribution |
L’avantage opérationnel déterminant réside dans la nature du résultat : la valeur reçue est une probabilité calculée par le réseau de neurones, et non une simple assertion textuelle formulée au hasard par un modèle génératif. Vous pouvez ainsi définir un seuil d’automatisation rigoureux : validation automatique au-delà de 0,8, ou bascule vers un opérateur humain en deçà.
Domaines d’application et limites opérationnelles
Cas d’usage recommandés :
- Aiguillage de tickets d’assistance : identification du pôle compétent, urgence, langue, risque de résiliation.
- Modération de contenu : détection d’infractions aux règles, filtrage du spam, conformité d’une image (Clef gérant l’entrée visuelle).
- Catégorisation documentaire : nature d’une facture, imputations comptables, détection d’une clause contractuelle spécifique.
- Sélection d’outils pour agents : au lieu de confier le choix d’une fonction à un modèle volumineux, le modèle décisionnel cible l’outil idoine dans une liste finie (pour approfondir ce sujet, consultez notre guide sur le function calling).
- Contrôles d’étapes (guardrails) : vérification de la conformité d’une réponse d’agent, escalade humaine, sélection du moteur adapté.
Usages déconseillés :
- Rédaction, résumés, traduction, dialogue ou programmation : le modèle est structurellement incapable d’écrire une phrase.
- Interrogations ouvertes (« quelle est l’intention du client ? ») : une nomenclature de choix prédéfinie est indispensable.
- Raisonnement complexe à étapes multiples : les créateurs de Strands Decider précisent qu’il est nettement moins performant que les modèles de raisonnement sur des problématiques intriquées.
En pratique, le modèle décisionnel opère aux côtés d’un LLM classique : il traite instantanément des centaines d’arbitrages élémentaires, tandis que le LLM prend le relais uniquement pour produire du texte. Pour architecturer ce type d’assemblage, reportez-vous à notre ressource Créer des agents IA de zéro.
Panorama des modèles de décision en octobre 2026
| Modèle | Auteur | Taille et base | Licence | Disponibilité |
|---|---|---|---|---|
| Jev | TypeSafe | Non précisée | Poids propriétaires | API TypeSafe (System One) |
| Clef | Cloudflare | 27B, Qwen3.8-27B + tête conjointe de schéma | Apache-2.0 | Workers AI, Hugging Face (55 Go) |
| Clef-flash | Cloudflare | 9B, Qwen3.5-9B + tête conjointe de schéma | Apache-2.0 | Workers AI, Hugging Face (19 Go) |
| Strands Decider 2B | AWS (Strands Labs) | 2B, Qwen3.5-2B-Base + LoRA + tête de pointage | Apache-2.0 | Hugging Face, GitHub, pip install strands-decider |
| Kev 1.0 | Jared Palmer | 0,8B, 4B, 9B, 27B (Qwen3.5/3.8) | Apache-2.0 | Hugging Face, GitHub |
| Aplomb 1 | EmpirioLabs | 5,3B, Qwen3.5-4B | Licence EmpirioLabs Model 1.0 (gratuite en usage interne si CA < 1 M$ [~894 374 EUR]) | Hugging Face (accès restreint), API EmpirioLabs |
| Decisions API | OpenAI | Modèle Luna | Propriétaire | Aperçu limité, grille tarifaire non publiée |
Clef, Clef-flash, Strands Decider et Kev respectent l’API System One issue de Jev (requêtes en POST /v1/systemone, champs state et questions). Le même connecteur client fonctionne sur tous ces moteurs en modifiant simplement le point d’accès et le nom de modèle. Aplomb 1 propose un point de terminaison dédié POST /v1/decisions compatible avec les formats de messagerie d’OpenAI, Anthropic et Gemini. Le fonctionnement de l’API Decisions d’OpenAI a également été détaillé dans notre article sur l’Agents API.
Cloudflare Clef et Clef-flash
Clef s’appuie sur une base Qwen gelée, exécute la passe d’encodage initiale (la phase de pré-remplissage ou « prefill », sans génération autorégressive) et transmet les états cachés à une sous-couche appelée joint schema head. Ce composant analyse l’ensemble des réponses pour toutes les questions de manière simultanée. D’après Cloudflare, il s’agit du premier modèle décisionnel intégrant un encodeur visuel et une fenêtre de contexte de 64 000 tokens. Les benchmarks et spécifications sont accessibles dans notre actualité Cloudflare Clef : modèle de décision open source, et les services d’infrastructure dans notre synthèse Cloudflare.
Amazon Strands Decider 2B
C’est l’option la plus compacte parmi les modèles ouverts. AWS a conservé le tronc de Qwen3.5-2B-Base en supprimant la tête de vocabulaire pour lui adjoindre une tête de pointage (pointer head) d’environ un million de paramètres, complétée par un adaptateur LoRA de rang 16. Le point de contrôle strands-decider-2B-hobson-v19 est accessible sur Hugging Face avec son jeu d’entraînement et ses scripts. AWS indique une latence médiane d’environ 115 ms sur RTX 3090 et 153 ms sur Apple Silicon M3. Son score sur le banc public JevBench atteint 167 réussites sur 231 épreuves (72,3 %).
Kev 1.0
Développé par Jared Palmer, Kev propose quatre déclinaisons (de 0,8B à 27B) fondées sur Qwen3.5/Qwen3.8 avec LoRA et tête de pointage sous licence Apache-2.0. Il intègre l’API System One, garantissant une compatibilité native avec les kits de développement de TypeSafe. Kev a été entraîné et évalué exclusivement sur des données en langue anglaise. La mouture 9B requiert environ 22 Go de mémoire vidéo selon sa fiche technique, raison pour laquelle elle a été écartée de notre banc d’essai.
EmpirioLabs Aplomb 1
Dévoilé fin septembre 2026, Aplomb 1 traite au sein d’un contexte de 1 million de tokens du texte, du JSON, jusqu’à 16 images, 8 pistes audio et 4 flux vidéo par requête. Bâti sur Qwen3.5-4B (5,3 milliards de paramètres), il demande environ 12 Go de mémoire vidéo en format bf16 d’après ses auteurs. En sus des formats noul, choice et score, il introduit le type tool pour orienter l’appel de fonctions et estimer les probabilités des paramètres.
- Performances déclarées : score de 44,86 sur Decision Index 0.2.1 (mesuré en interne le 5 octobre, hors classement officiel), scores visuels POPE de 89,0, MMStar de 68,6 et AI2D de 87,0.
- Capacités audio : seul modèle de sa catégorie acceptant des données sonores (notamment 91,9 % sur l’identification d’émissions vocales).
- Régime de licence : licence propriétaire gratuite pour la recherche, l’enseignement, l’usage individuel et les entreprises générant moins de 1 M$ de chiffre d’affaires annuel (~894 374 EUR au taux BCE de 1 EUR = 1,1181 USD). Licence commerciale requise au-delà.
- Tarification d’API : environ 0,018 EUR (0,02 USD) par million de tokens d’entrée, sortie sans surcoût.
Ce modèle n’a pas été intégré à notre banc de test en raison de restrictions d’accès aux poids et de la nécessité d’un compte API dédié. Retrouvez l’analyse exhaustive dans notre article consacré à Aplomb 1 d’EmpirioLabs.
Tarification et ressources matérielles
| Modèle | Déploiement | Coût d’usage | Exécution locale |
|---|---|---|---|
| Clef | Workers AI @cf/cloudflare/clef |
~0,21 EUR / M tokens d’entrée (0,24 USD) | 55 Go en bf16 ; requiert une quantification pour tourner sur 24 Go (non fournie officiellement) |
| Clef-flash | Workers AI @cf/cloudflare/clef-flash |
~0,08 EUR / M tokens d’entrée (0,09 USD) | 19 Go de poids, pic observé à 18,3 Go de VRAM |
| Strands Decider 2B | Hébergement personnel | 0 EUR (coûts matériel et énergie) | 4,4 Go à télécharger, 3,8 Go de VRAM relevés ; compatible CPU et macOS |
| Kev-9B | Hébergement personnel | 0 EUR | Environ 22 Go annoncés par l’auteur |
| Aplomb 1 | API EmpirioLabs | ~0,018 EUR / M tokens d’entrée (0,02 USD), sortie gratuite | Environ 12 Go en bf16 selon l’éditeur (non testé) |
| Jev | API TypeSafe | ~0,038 EUR / M tokens d’entrée (0,042 USD), sortie gratuite | Non disponible en local |
Note de change : conversions estimées au taux de référence de la Banque centrale européenne du 12/10/2026 (1 EUR = 1,1181 USD ; source : https://www.ecb.europa.eu/stats/eurofxref/eurofxref-daily.xml).
Sur Workers AI, le quota journalier sans frais s’élève à 10 000 « neurones ». L’exécution de Clef consomme 21 818 neurones par million de tokens d’entrée, contre 8 182 pour Clef-flash. Cela représente un traitement gratuit quotidien d’environ 458 000 tokens sur Clef et 1,2 million sur Clef-flash. Une requête type comportant deux questions mobilisant 150 à 250 tokens, vous pouvez traiter plusieurs milliers de décisions par jour sans frais.
Notre banc d’essai : 30 tickets clients sur RTX 4090
Pour cette évaluation, nous avons conçu 30 cas concrets représentatifs d’un commerce en ligne ou d’une plateforme SaaS : paiements, livraisons, retours, gestion de compte, incidents techniques et ventes (5 cas par pôle). Les invites ont été soumises dans leur langue d’origine, le polonais, en intégrant volontairement des fautes de frappe et des formulations ambiguës (par exemple, déterminer si l’attente d’un remboursement relève du pôle retours ou paiements). Chaque système devait déterminer le service concerné (6 options) et le niveau d’urgence pour le jour même. Les modèles de décision ont été interrogés via leur API dédiée, tandis que les LLM généralistes ont tourné sous Ollama ou OpenRouter avec un schéma JSON strict et une température de 0.
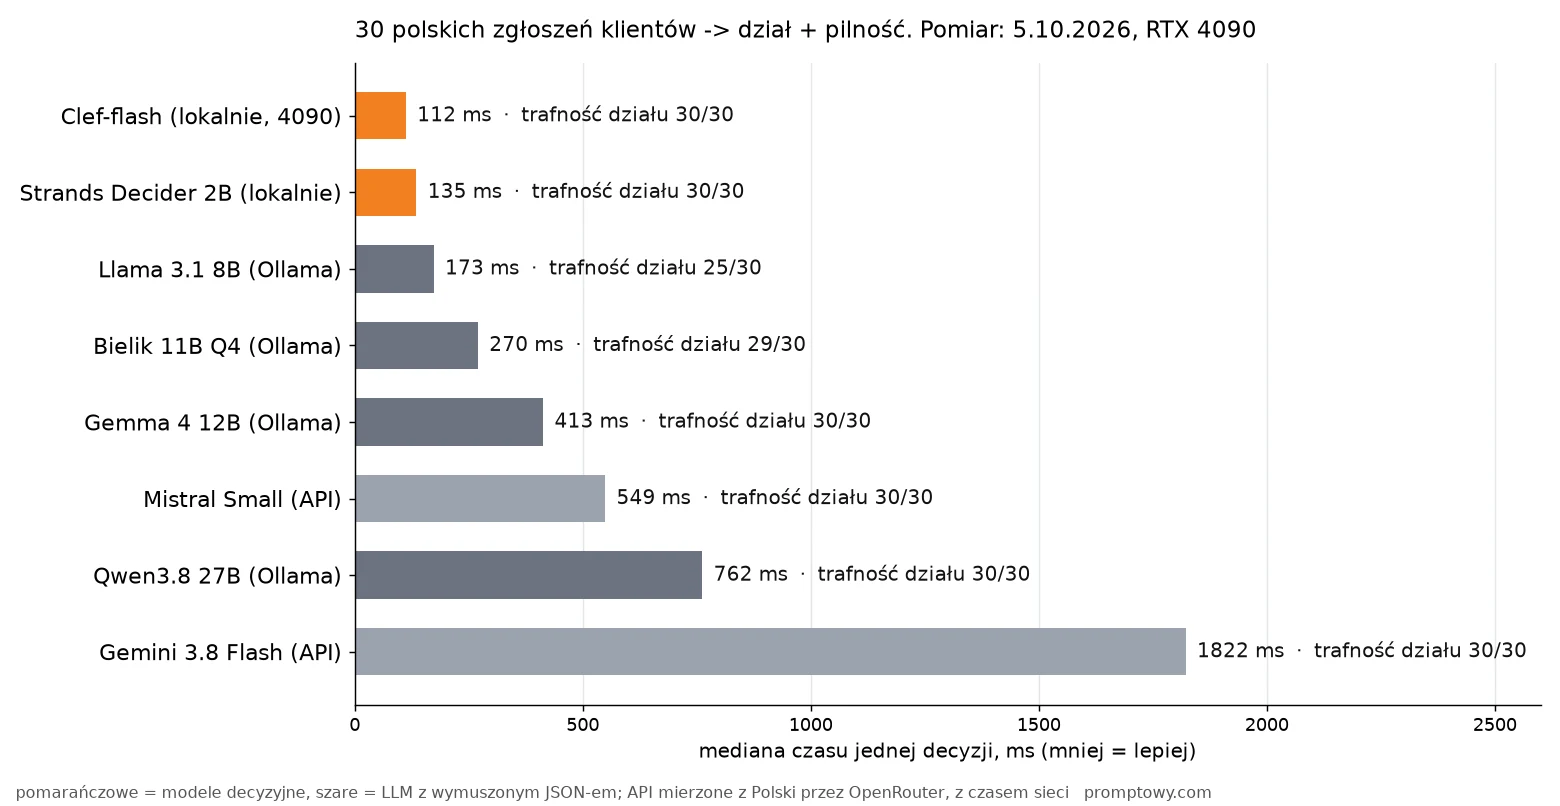
| Modèle | Département | Urgence | Temps médian | Mémoire requise |
|---|---|---|---|---|
| Clef-flash (local) | 30/30 | 26/30 (28/30 avec seuil à 0,95) | 112 ms | 18,3 Go de VRAM |
| Strands Decider 2B (local) | 30/30 | 24/30 (26/30 avec seuil à 0,4) | 135 ms | 3,8 Go de VRAM |
| Llama 3.1 8B (Ollama) | 25/30 | 23/30 | 173 ms | Fichier de 4,9 Go |
| Bielik 11B Q4 (Ollama) | 29/30 | 21/30 | 270 ms | Fichier de 6,7 Go |
| Gemma 4 12B (Ollama) | 30/30 | 26/30 | 413 ms | Fichier de 7,0 Go |
| Qwen3.8 27B (Ollama) | 30/30 | 27/30 | 762 ms | Fichier de 16 Go |
| Mistral Small 2603 (API) | 30/30 | 19/30 | 549 ms | - |
| Gemini 3.8 Flash (API) | 30/30 | 26/30 | 1822 ms | - |
Enseignements majeurs de ce comparatif :
- L’attribution du département s’avère trop élémentaire pour départager le haut du panier. Six des huit modèles ont obtenu un score parfait de 30/30. Seul Llama 3.1 8B s’est fait distancer (25/30), confondant notamment une demande de facture avec un acte de vente, ou une réclamation matérielle avec un problème d’infrastructure.
- La vitesse d’exécution constitue un atout décisif. Sur la même carte graphique, Clef-flash s’est montré 3,7 fois plus rapide que Gemma 4 12B et près de 7 fois plus véloce que Qwen3.8 27B. Ce résultat a été mesuré sans recourir aux bibliothèques optimisées flash-linear-attention et causal-conv1d, dont l’installation sous Windows pose problème, contraignant la bibliothèque transformers à calculer l’attention linéaire via sa routine standard.
- L’étalonnage des seuils doit être ajusté sur vos jeux de données. Sur notre banc en polonais, Strands Decider sous-estimait les probabilités d’urgence : aucun score n’ayant dépassé 0,5, aucun cas n’était signalé comme prioritaire avec le seuil par défaut. En réajustant le seuil à 0,4, le modèle a atteint un score de 26/30. À l’inverse, Clef-flash générait 4 faux positifs à 0,5, mais seulement 2 erreurs avec un seuil relevé à 0,95.
- Bonne polyvalence linguistique. Bien qu’entraînés principalement en anglais, ces modèles ont correctement géré nos requêtes. En traduisant ces mêmes tickets en anglais à titre de vérification, les scores étaient comparables : 29/30 pour Clef-flash et 29/30 pour Strands Decider (l’erreur portant sur une modification d’abonnement en cours de cycle).
- La notion d’urgence conserve une part de subjectivité. Nous avions qualifié d’urgents 6 tickets critiques (erreurs serveur 502, compromissions d’accès, double prélèvement bancaire). La quasi-totalité des modèles a également classé comme prioritaire un paiement instantané non crédité sur l’espace client, ce qui constitue un choix tout à fait défendable.
Coût global de notre banc d’essai : 0 EUR pour les charges locales, et environ 0,036 EUR (0,04 USD) sur OpenRouter pour acheminer 180 appels vers Mistral et Gemini. Gemini 3.8 Flash imposant son mécanisme de réflexion même au niveau minimal, son temps de réponse s’est stabilisé autour de 1,8 seconde.
Pourquoi Clef 27B et Kev n’ont pas été évalués localement
- Clef 27B représente 55 Go de mémoire en précision bf16. Il est impossible de le charger sur 24 Go de VRAM sans quantification, et Cloudflare n’en propose pas d’officielle. Exploitant un fichier d’architecture personnalisé (
joint_schema_model.py), il ne peut être exécuté sous Ollama ou llama.cpp via un conteneur GGUF. - Kev-9B exige le téléchargement préalable de Qwen3.5-9B-Base (soit 19 Go additionnels), dépassant notre limite fixée à 40 Go de téléchargements pour ce test, sans compter sa spécialisation exclusive sur l’anglais.
- Workers AI nécessite la création d’un compte de plateforme, démarche non retenue pour notre phase de mesures locales.
Modèle de décision ou LLM avec sortie structurée ?
Le même traitement peut être accompli par un LLM traditionnel contraint de retourner un format JSON strict (technique abordée dans notre guide sur le structured output). Voici les critères pour choisir la bonne approche :
| Critère | Modèle de décision | LLM avec sortie structurée |
|---|---|---|
| Réponse hors nomenclature | Impossible de par sa structure mathématique | Écartée par le schéma, mais le parseur reste exposé aux erreurs (voir notre analyse sur les problèmes de JSON invalide) |
| Mesure de confiance | Probabilité réelle calculée sur chaque option | Absente ou formulée arbitrairement par le LLM |
| Multiples questions simultanées | Aucun impact notable sur la latence | Chaque champ génère des tokens supplémentaires et ralentit la réponse |
| Explication / justification | Impossible (aucune génération textuelle) | Possible par génération de texte explicatif |
| Raisonnement intriqué | Moins adapté | Plus performant, notamment avec des modèles orientés raisonnement |
| Coût d’API dans le cloud | Facturation appliquée uniquement aux tokens d’entrée | Facturation des entrées, des sorties et des tokens de raisonnement |
Règle pratique : lorsque la réponse fait partie d’une nomenclature fermée et que vos volumes dépassent plusieurs centaines d’opérations par jour, privilégiez un modèle de décision. Si vous devez obtenir une argumentation ou résoudre un problème logique complexe, orientez-vous vers un LLM. L’architecture la plus efficiente reste hybride : le modèle décisionnel traite le flux massif des cas évidents et délègue les situations incertaines (sous le seuil de confiance) à un LLM plus puissant ou à un conseiller humain.
Mise en œuvre en 10 minutes
- Vérifiez la présence de Python 3.10+ et de PyTorch configuré avec CUDA (le calcul reste possible sur CPU, à vitesse réduite).
- Installez le paquet :
pip install strands-decider(environ 4,4 Go à récupérer). - Exécutez votre première requête en ligne de commande (exemple traduit de notre jeu de test polonais) :
strands-decider ask StrandsAgents/strands-decider-2B-hobson-v19 \ --state "Vous m'avez prélevé deux fois pour le même abonnement" \ --choice "Quel département ?=paiements,livraison,retours,compte,panne,ventes" \ --noul "Ce dossier est-il urgent ?" - Démarrez ensuite le serveur applicatif (
strands-decider serve ... --port 8000) pour émettre vos requêtes selon les spécifications System One. Ce serveur écoute exclusivement sur l’adresse 127.0.0.1 sans mécanisme d’authentification : prévoyez un proxy inverse en environnement de production. - Si vous bénéficiez de 24 Go de VRAM, chargez Clef-flash via
snapshot_download("Cloudflare/clef-flash")en appelant la méthodesystemone()fournie. La structure des requêtes demeure strictement identique.
Sans carte graphique dédiée, tournez-vous vers l’API Workers AI ou TypeSafe. Les outils de virtualisation comme Ollama conviennent aux modèles génératifs, mais ne prennent pas en charge les têtes spécifiques de ces modèles décisionnels, qui requièrent l’écosystème Python transformers.
À qui s’adresse cette technologie ?
- Cas pertinents : services support et plateformes e-commerce cherchant à trier automatiquement leurs sollicitations ; développeurs d’architectures agentiques confrontés à une multitude de micro-décisions ; équipes de modération ; toute organisation payant un grand LLM uniquement pour obtenir des arbitrages binaires.
- Cas inadaptés : besoins de rédaction, de conversation ou de code ; flux modestes ne représentant que quelques arbitrages quotidiens (la flexibilité d’un LLM généraliste l’emporte alors) ; absence d’un échantillon de données annotées pour calibrer précisément vos seuils.
Foire aux questions
Qu’est-ce qu’un modèle de décision en IA ?
Il s’agit d’un réseau neuronal qui, au lieu de formuler des phrases, sélectionne des éléments dans une liste imposée en associant une probabilité à chaque choix. Il gère trois modes d’interrogation : le choix multiple (choice), la décision binaire (noul) et l’évaluation graduée (score).
Qu’est-ce que Cloudflare Clef ?
C’est une série de modèles décisionnels ouverts publiée le 1er octobre 2026 par Cloudflare, comprenant Clef (27B, dérivé de Qwen3.8-27B) et Clef-flash (9B, basé sur Qwen3.5-9B). Distribués sous licence Apache-2.0 sur Hugging Face et disponibles sur Workers AI, ils acceptent le texte, le JSON, les images et les vidéos sur un contexte de 64 000 tokens.
L’usage de Clef est-il gratuit ?
Les fichiers de poids sont totalement libres d’accès sous licence Apache-2.0, y compris pour des besoins commerciaux. Sur Workers AI, la tarification s’élève à environ 0,21 EUR (0,24 USD) pour Clef et 0,08 EUR (0,09 USD) pour Clef-flash par million de tokens d’entrée, assortie d’une franchise quotidienne de 10 000 neurones (soit environ 458 000 à 1,2 million de tokens offerts par jour).
Ces modèles fonctionnent-ils sur des langues autres que l’anglais ?
Notre banc d’essai mené sur des textes en polonais a démontré une parfaite identification des départements (30/30 pour Clef-flash et Strands Decider 2B). La calibration des probabilités nécessite cependant d’ajuster les seuils de décision sur vos propres données métier. Le projet Kev, en revanche, se limite à l’anglais.
Quelle configuration matérielle faut-il pour exécuter Clef en local ?
Clef-flash mobilise 18,3 Go de VRAM lors de nos mesures, ce qui le rend exploitable sur des cartes graphiques grand public dotées de 24 Go (RTX 3090, 4090 ou 5090). Le modèle complet Clef (55 Go en bf16) nécessite du matériel pour centre de données (H100/H200) ou une quantification personnalisée. Strands Decider 2B tourne avec moins de 4 Go de mémoire sur GPU, Mac ou CPU. Pour aller plus loin, consultez notre guide sur la mémoire VRAM nécessaire pour l’IA en local.
Quelle différence y a-t-il entre un modèle décisionnel et le function calling ?
Le function calling est un procédé par lequel un LLM rédige un appel de fonction et ses paramètres textuels. Un modèle de décision sélectionne l’outil adéquat sans en générer le corps d’argumentation textuel. En pratique, le modèle décisionnel cible la fonction à déclencher, puis le LLM en renseigne les paramètres détaillés.
Qu’est-ce qu’Aplomb 1 ?
C’est un modèle décisionnel multimodal dévoilé le 29 septembre 2026 par EmpirioLabs. Doté de 5,3 milliards de paramètres, il traite texte, JSON, image, vidéo et son sur 1 million de tokens de contexte, en intégrant un quatrième mode dédié aux outils (tool). Ses poids sont disponibles sous licence spécifique sur Hugging Face, et son API facture environ 0,018 EUR (0,02 USD) par million de tokens d’entrée.
Peut-on exploiter Strands Decider dans un cadre commercial ?
Absolument. Le modèle, son code source et les données d’apprentissage sont publiés sous licence Apache-2.0, tout comme sa fondation Qwen3.5-2B-Base. Le composant serveur natif ne gérant pas la sécurité des accès, il convient de le déployer derrière une passerelle d’API en production.
Que représentent Jev et System One ?
Jev est le modèle pionnier déployé le 15 septembre 2026 par TypeSafe, et System One désigne le standard d’interface qu’il a établi (état initial + questions indexées + formats stricts de retours). Clef, Kev et Strands Decider reprennent ce format. Retrouvez notre décryptage complet sur TypeSafe et le modèle Jev.
Google · Vos sourcesPromptif plus haut dans Google - en un clicAjouter aux sources préférées →Sources
- Cloudflare: Introducing Clef (01/10/2026)
- Cloudflare/clef et Cloudflare/clef-flash sur Hugging Face
- Grille tarifaire Cloudflare Workers AI
- Strands Agents: Introducing Strands Decider 2B (01/10/2026) et fiche de modèle
- Kev sur GitHub et jaredpalmer/kev-9b
- empiriolabsai/aplomb-1 et documentation technique d’Aplomb 1 (consultées le 07/10/2026)
- Mesures sur banc d’essai : 5 octobre 2026, configuration RTX 4090, Windows 11, PyTorch 2.11, transformers 5.18, Ollama.
Article vérifié le 5 octobre 2026 ; section relative à Aplomb 1 mise à jour le 7 octobre 2026.
More on this from PROMPTIF