25 prompts pour Claude Opus 5.5 : exploiter ses points forts
25 prompts pour Claude Opus 5.5 : code, documents longs, contrats, SVG et jeux. Cinq tests réels avec coûts, temps d'exécution et réglages d'effort.
Mise à jour (9 novembre 2026) : Claude Fable 5.2 et Mythos 5.2 sont sortis - prix, accès et benchmarks dans mon guide Claude Fable 5.2.
👁 120 lectures
Les prompts pour Claude Opus 5.5 donnent les meilleurs résultats là où le modèle excelle : un contexte étendu jusqu’à 1 million de tokens, le code, l’analyse approfondie, la rédaction nuancée et la génération graphique à partir de code. J’ai rassemblé 25 instructions concrètes, réparties par cas d’usage. Cinq d’entre elles ont été testées le 26 septembre 2026 via l’API, avec les extraits obtenus, le temps d’exécution et le coût précis à la clé. Pour chaque catégorie, j’indique également le niveau d’effort de raisonnement recommandé pour débuter.
En résumé
Les cinq prompts testés ont coûté au total 0,18 USD (environ 0,16 EUR selon le taux BCE du 12/10/2026). Le moins cher (simplification d’un paragraphe avec un effort faible) n’a coûté que 0,003 USD (environ 0,0027 EUR) et a répondu en 3,4 secondes sans consommer un seul token de réflexion. Le code généré pour la validation d’un identifiant avec tests a réussi ses 33 cas d’évaluation du premier coup. Une seule limite est apparue : un plan de projet avec un effort faible a été coupé net par ma propre limite de sortie fixée à 3 000 tokens, car un faible niveau d’effort ne garantit pas une réponse courte.
Comment ajuster le niveau d’effort selon la tâche
Opus 5.5 applique toujours un raisonnement, et son niveau d’effort par défaut est réglé sur medium. Dans l’API, vous le définissez via un paramètre, par exemple sur OpenRouter avec "reasoning": {"effort": "low"}. Lors de mon test des niveaux d’effort sur une tâche de complexité intermédiaire, ce paramètre n’a modifié ni le résultat final ni le coût, car le modèle dose lui-même sa quantité de réflexion. Le tableau suivant offre un repère de départ. Ceci reflète mon analyse personnelle.
| Type de tâche | Effort de départ recommandé | Mesures observées |
|---|---|---|
| Rédaction, résumés, courriels | low | 0 token de réflexion, 3,4 s |
| Code, SVG, analyse de contrat | medium | 407-889 tokens de réflexion, 16-24 s |
| Documents longs, grands dépôts, jeux, débogage complexe | high | non mesuré, à augmenter si medium échoue |
Documents longs (contexte de 1 million de tokens)
- « Je colle 14 documents de projet. Trouve toutes les contradictions entre eux. Pour chacune, cite les deux passages textuellement, avec le nom du fichier et la section concernée. En cas de doute, indique « à vérifier ». »
- « Voici l’ensemble du dépôt de code. Génère une cartographie des dépendances entre les modules en syntaxe Mermaid et liste 5 points sensibles où modifier un fichier risque d’en casser trois autres. »
- « Voici la transcription de 3 heures de réunions. Liste les décisions prises, les responsables et les dates limites. Justifie chaque point par une citation horodatée. N’ajoute aucune décision qui n’a pas été formulée explicitement. »
- « Compare ces deux versions de conditions générales. Présente un tableau : article, ancienne version, nouvelle version, conséquence pratique pour le client en une phrase. Ignore les modifications purement typographiques. »
Rédaction et simplification de texte
- Testé : simplification d’un paragraphe administratif (niveau d’effort : low). Remarque : le test a été réalisé en polonais pour évaluer le traitement de phrases denses ; en voici la traduction fidèle :
Réécris le paragraphe ci-dessous dans un style simple et naturel pour un client de boutique en ligne. Règles : 3 phrases au maximum, 15 mots par phrase maximum, aucun jargon, voix active, information principale dans la première phrase. N'ajoute aucun fait absent du texte. Renvoie uniquement le nouveau paragraphe.

Texte d'origine : « En raison de la nécessité d'adapter les processus logistiques à l'augmentation du volume des commandes durant la période précédant les fêtes, nous vous informons que le traitement des commandes passées après le 15 décembre est susceptible d'être prolongé jusqu'à 5 jours ouvrés, étant précisé que les commandes réglées à l'avance seront traitées en priorité. »
Résultat obtenu dans le test en polonais : l’équivalent parfait de « Si vous commandez après le 15 décembre, le délai peut atteindre 5 jours ouvrés. Avant les fêtes, nos commandes augmentent. Les commandes payées d’avance sont traitées en priorité. » Toutes les contraintes ont été scrupuleusement respectées, sans aucune hallucination. 3,4 s, 96 tokens de sortie, 0,003 USD (environ 0,0027 EUR). Retrouvez une analyse plus détaillée sur la gestion linguistique dans le test Claude Opus 5.5 et le polonais.
- « Révise ce texte en appliquant ces règles : [règles]. Fournis en dessous la liste des modifications sous la forme : avant, après, règle appliquée. »
- « Rédige un refus poli de collaboration à destination d’un client qui présente 45 jours de retard de paiement. Reste courtois, ne t’excuse pas, limite-toi à 5 phrases et fixe une échéance ferme. »
- « Propose 10 titres pour cet article, chacun sous la barre des 60 caractères, sans questions rhétoriques et sans promesses non tenues dans le contenu. »
Génération et revue de code
- Testé : validation d’identifiant fiscal (NIP polonais) avec tests unitaires (niveau d’effort : medium). Le prompt ci-dessous est la traduction du test exécuté :
Écris en Python 3 une fonction `waliduj_nip(nip: str) -> bool` pour le numéro fiscal NIP. Elle doit accepter les tirets et les espaces (« 123-456-32-18 »), rejeter tout ce qui ne compte pas exactement 10 chiffres et vérifier la clé de contrôle (poids 6,5,7,2,3,4,5,6,7 ; somme modulo 11 ; un résultat de 10 invalide le NIP). Inclus 5 tests pytest couvrant les cas limites. Aucun commentaire hors docstring. Renvoie uniquement le bloc de code.Le modèle a produit 79 lignes contenant la fonction et 5 fonctions de test paramétrées sur 33 cas d’évaluation, incluant des chiffres arabo-indiens, des tabulations et des entiers au lieu de chaînes. Résultat après exécution : 33 tests sur 33 validés. 21,3 s, 889 tokens de réflexion, 0,039 USD (environ 0,035 EUR).
cyfry = nip.replace("-", "").replace(" ", "")
if not re.fullmatch(r"[0-9]{10}", cyfry):
return False- « Voici un diff de code. Fais une revue ciblée : uniquement les anomalies qui modifient le comportement de l’application, par ordre de gravité. Pour chacune, indique le numéro de ligne et un test capable de la mettre en évidence. »
- « Voici une erreur et sa trace d’exécution. Propose 3 hypothèses classées par probabilité, accompagnées chacune d’une commande unique permettant de la valider ou de l’écarter. Ne propose pas encore de correctif. »
- « Migre ce module JavaScript vers TypeScript sans altérer son comportement. Écris d’abord les tests qui figent le comportement actuel. »
Analyse stratégique et planification
- Testé : plan de lancement de projet (niveau d’effort : low). Traduction du prompt exécuté :
Je gère une entreprise individuelle et je veux lancer en 4 semaines une newsletter payante sur les outils d'IA destinée aux experts-comptables. J'ai 1 200 inscrits sur ma liste gratuite. Détaille un plan semaine par semaine : maximum 4 tâches par semaine avec un livrable mesurable pour chacune. Conclus par les 3 risques majeurs et une méthode économique pour les tester avant le lancement. Sans introduction ni conclusion.Le plan s’est avéré très concret : un sondage en semaine 1 avec un objectif de « min. 120 réponses (10 % de la liste) », puis des préventes en semaine 3 visant 20 abonnements payants. Toutefois, la réponse a été coupée en plein milieu de la dernière phrase en raison d’un plafond de sortie de 3 000 tokens configuré de mon côté. 37 s, 0,061 USD (environ 0,055 EUR). Conclusion : prévoyez une marge suffisante sur la limite de tokens de sortie lors de plans détaillés, même avec un effort réglé sur low.
- « Voici un export CSV de ventes. Identifie 3 anomalies. S’il manque des données pour étayer une conclusion, précise lesquelles au lieu d’extrapoler. » C’est un aspect que j’avais analysé dans l’article sur l’invention de chiffres par les modèles.
- « Effectue un pre-mortem : nous sommes dans un an et le projet a échoué. Détaille les 5 causes les plus probables et un indicateur précurseur pour chacune. »
- « Compare ces 3 devis sous forme de tableau : coût total sur 12 mois, coûts cachés potentiels et conditions de résiliation. Précise en note les données manquantes. »
Examen de contrats (sans conseil juridique)
- Testé : préparation d’une liste de questions pour un avocat (niveau d’effort : medium). Les clauses contractuelles utilisées sont purement fictives. Traduction du prompt testé :
Tu n'es pas avocat et tu ne fournis aucun conseil juridique. Lis cet extrait de contrat B2B de prestations logicielles et prépare une liste de points à aborder avec un avocat.

Format : tableau Markdown avec les colonnes : Clause | Dispositions (1 phrase) | Risque potentiel pour le prestataire | Question pour l'avocat. Maximum 5 lignes, en s'appuyant uniquement sur le texte. Conclus par une phrase sur les manques notables dans cet extrait.

§3 al. 2. Le Prestataire cède au Client les droits patrimoniaux d'auteur sur les créations dès leur livraison, sur l'ensemble des modes d'exploitation connus.
§4 al. 1. La rémunération est payable dans un délai de 60 jours à compter de la validation de la facture par le Client.
§4 al. 3. Le Client peut suspendre le paiement jusqu'à la levée de l'ensemble des anomalies signalées.
§6 al. 1. Pour chaque jour de retard, le Prestataire versera une pénalité contractuelle de 1 % de la rémunération totale.
§7. Le Prestataire s'interdit, pendant 24 mois suivant la fin du contrat, de collaborer avec les clients du Client.
Le modèle a judicieusement croisé deux clauses : la cession des droits intervenant à la livraison alors que le paiement peut être suspendu, le client pourrait détenir les droits d’un code sans l’avoir réglé. Il a aussi calculé qu’une pénalité journalière de 1 % sans plafond dépasse le montant total du contrat en une centaine de jours. Le modèle a rappelé de lui-même qu’il ne s’agissait pas d’un conseil juridique. 24,1 s, 0,041 USD (environ 0,037 EUR).
- « Extrais de ce contrat l’ensemble des délais et montants sous forme de tableau : article, objet, valeur, point de départ du calcul. Reste strictement descriptif sans interpréter. »
Rendus graphiques et animations via le code
- Testé : génération d’un graphique en SVG pur (niveau d’effort : medium). Traduction du prompt d’origine :
Génère en SVG pur (viewBox 0 0 800 450) un graphique à barres horizontales intitulé « Scores du banc d'essai : résultat sur 100 pts » pour cinq modèles : Claude Opus 5.5 - 90,1 ; Modèle B - 84,6 ; Modèle C - 81,2 ; Modèle D - 77,9 ; Modèle E - 72,4. Style : arrière-plan #0e0d0c, barres sans arrondis, vainqueur en #c46a3c, autres barres en #5a534c, texte #f2ede6, typographie sans-serif, valeurs indiquées au bout des barres avec virgule décimale, échelle de 0 à 100. Aucun script ni ressource externe. Renvoie uniquement le code SVG.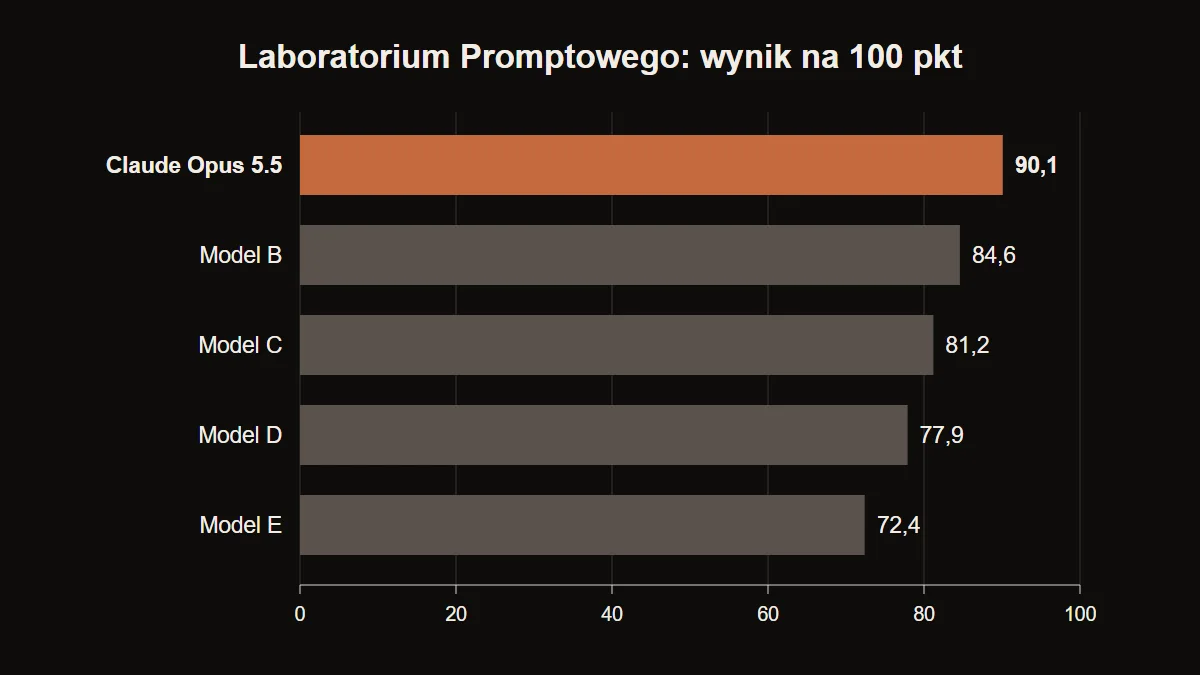
Après vérification, la longueur de chaque barre correspond exactement à l’échelle au pixel près. 16,1 s, 0,037 USD (environ 0,033 EUR).
- « Génère une icône de chargement animée en SVG utilisant 3 couleurs de marque. Utilise uniquement SMIL ou du CSS intégré, boucle de 1,2 s, poids maximal 2 ko. »
- « Crée une composition Remotion en 1280×720, 30 fps, d’une durée de 9 s : [liste des séquences, codes hexadécimaux, textes]. Utilise uniquement le package remotion et gère les animations via useCurrentFrame(). »
- « À partir de ces données, conçois une infographie SVG au format 1080×1350 pour les réseaux sociaux : 1 chiffre clé, 3 indicateurs secondaires et la mention de la source en pied de page. »
Prototypes web et mini-jeux
- « Programme un jeu complet dans un fichier HTML unique : [mécanique en 2 phrases]. Contrôles au clavier et au toucher tactile, score sauvegardé dans localStorage, aucune bibliothèque externe. »
- « Développe une page de destination dans un seul fichier HTML pour [produit] : section hero, 3 bénéfices chiffrés, grille tarifaire, FAQ. Conception mobile-first, sans images externes. »
- « Développe un prototype cliquable d’espace client sur 3 écrans avec des données fictives, afin de valider l’expérience avant le développement du backend. »
Pour les jeux et le prototypage web, commencez avec le réglage medium, et basculez vers high si le modèle perd la cohérence logique entre plusieurs portions de code. Vous pouvez consulter les coûts unitaires dans le guide des tarifs de Claude Opus 5.5, ainsi que la présentation complète du système dans le dossier Opus 5.5.
Questions fréquentes
Faut-il obligatoirement rédiger ses prompts en anglais avec Claude Opus 5.5 ?
Non. Les cinq requêtes testées ont été soumises en polonais et le modèle a produit des réponses d’une excellente rigueur linguistique avec tous les signes diacritiques appropriés. Il traite le français avec la même fluidité.
Combien coûte l’exécution d’un prompt ?
Lors de mes tests via l’API, les requêtes ont coûté entre 0,003 et 0,061 USD (soit environ 0,0027 à 0,055 EUR selon le taux de référence de la BCE du 12/10/2026). La composante la plus onéreuse reste les tokens de sortie, facturés à 20 USD par million de tokens.
Quel niveau d’effort de raisonnement privilégier ?
Choisissez low pour la révision de texte et les réponses courtes, medium pour la génération de code et l’analyse, et high pour les volumineux ensembles de documents ou la résolution de bugs complexes. Avec l’effort réglé sur low, mon paragraphe simplifié a été rédigé sans consommer de tokens de réflexion.
Claude Opus 5.5 peut-il remplacer un conseil juridique ?
Non. Le modèle s’avère pertinent pour relever des clauses déséquilibrées et préparer un échange structuré, mais la validation définitive d’un contrat relève exclusivement de la compétence d’un professionnel du droit.
Sources et protocole de test
Tests réalisés par l’auteur
- 5 requêtes exécutées sur Claude Opus 5.5 via OpenRouter (
anthropic/claude-opus-5.5) - coûts relevés d’après les métadonnées de facturation des réponses de l’API. Les conversions en euros sont calculées sur la base du taux de référence de la Banque centrale européenne de 1 EUR = 1,1181 USD au 12/10/2026 (source BCE). Caractéristiques du modèle (fenêtre de contexte de 1 million de tokens
- sortie maximale de 128 000 tokens
- effort par défaut fixé à medium) issues de la documentation des modèles Anthropic
- tarifs d’après le communiqué d’Anthropic. Données vérifiées le 26 septembre 2026
À lire également : Comment rédiger une annonce de vente efficace avec l’IA
More on this from PROMPTIF



 benchmarks·Meilleure voix IA TTS : comparatif et test de 14 modèlesComparatif de 14 modèles TTS testés sur des pièges complexes, chiffres et abréviations. Eleven v4 et Gemini 3.1 Flash en tête : résultats, audio et prix.