Détecteurs d’IA et langue seconde : quels biais ?
Stanford 2023, recherches de 2026 et limites pour le français : comprendre les biais des détecteurs IA envers les étudiants et auteurs allophones.
👁 121 lectures
Votre texte est clair, structuré et rédigé avec des mots que vous maîtrisez. Un détecteur le classe pourtant comme généré par IA. Si vous écrivez dans une langue seconde, les travaux sur les biais linguistiques méritent votre attention. Ils ne permettent cependant pas de conclure que tous les outils pénalisent systématiquement toutes les personnes non natives.
L’étude de Stanford de 2023 a documenté un problème important en anglais. Des recherches plus récentes montrent que le résultat dépend aussi de la langue et du détecteur. Pour les étudiants internationaux en France, les auteurs francophones et les enseignants de FLE, cette nuance change la manière de lire les chiffres.
Sources consultées le 14 octobre 2026 par la rédaction de promptif.fr. Nous ne présentons pas de test maison. L’actualité du roman français fait l’objet de notre dossier sur C’était ça ou mourir et les accusations liées à l’IA.
Ce que Stanford a réellement mesuré en 2023
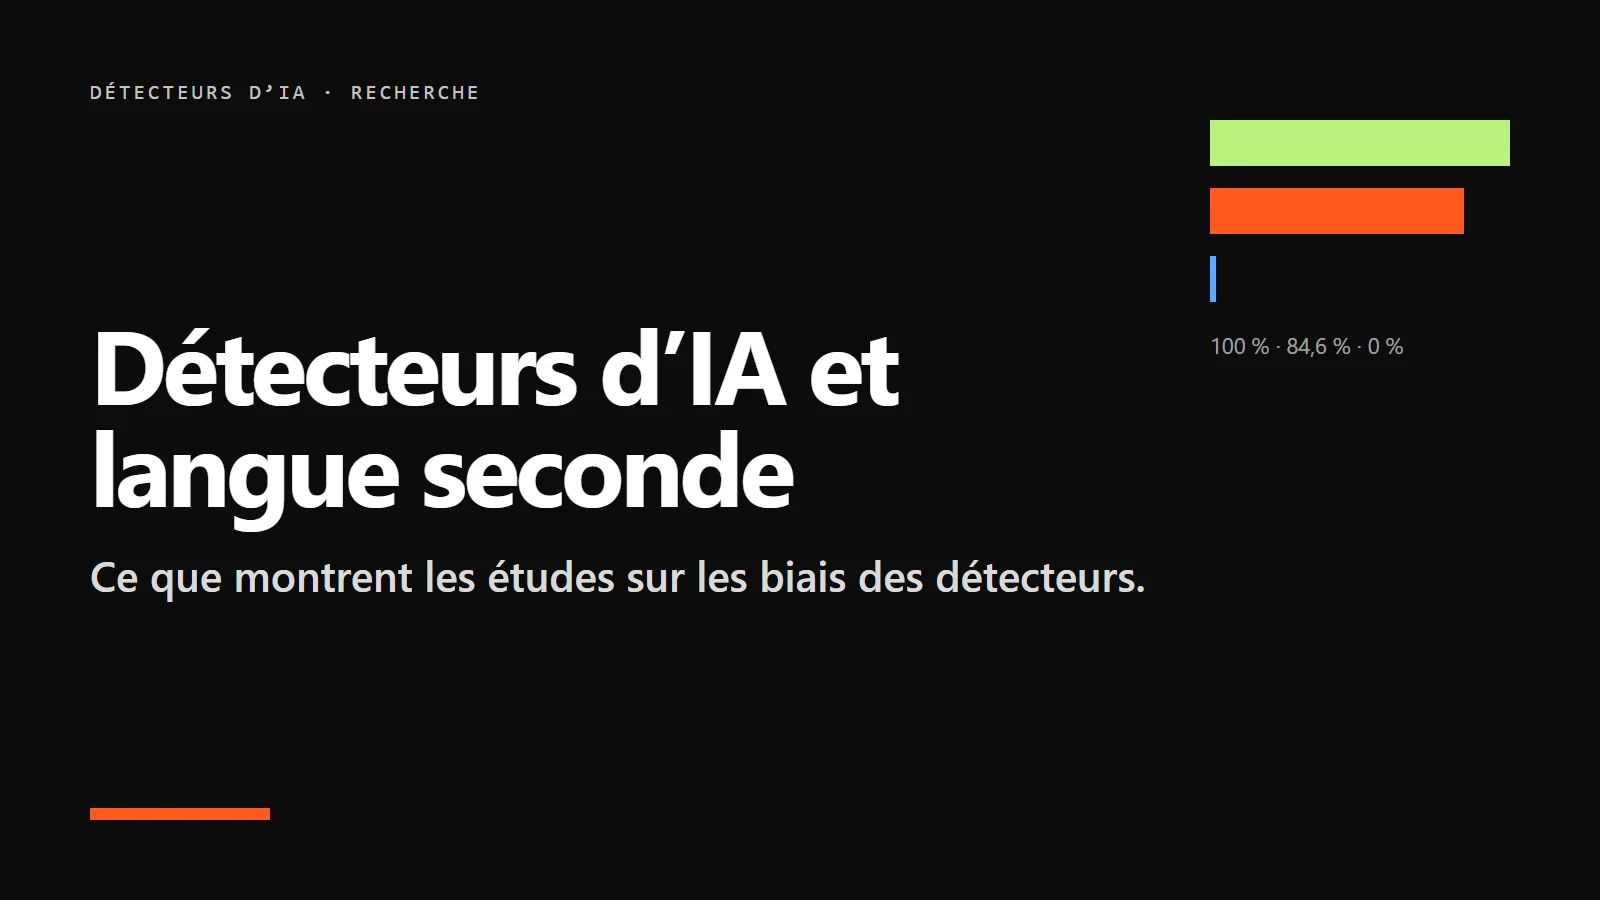
Weixin Liang et ses collègues, prépublication du 6 avril 2023, ont comparé sept détecteurs sur 91 textes TOEFL et 88 rédactions d’élèves américains. Les textes TOEFL étaient classés à tort comme générés à un taux moyen de 61,22 %. Les résultats étaient nettement meilleurs pour le corpus de comparaison.
Cette moyenne décrit les outils et les textes de l’expérience. Elle n’est ni un taux actuel pour tous les services ni la probabilité personnelle qu’un étudiant étranger soit accusé à tort. Le type d’exercice et la composition des corpus limitent les extrapolations.
Pourquoi une expression prévisible peut déclencher un signalement
L’explication publiée par Stanford HAI le 15 mai 2023 met notamment en avant la prévisibilité du langage, associée à la perplexité. Un vocabulaire moins varié et des structures répétées peuvent ressembler à certains signaux utilisés pour classer des textes. Cela ne transforme pas la régularité stylistique en preuve d’une origine automatique.
Pour comprendre l’idée, imaginez une personne qui choisit une construction simple afin d’éviter un contresens. Elle peut avoir un raisonnement original tout en l’exprimant avec des formulations habituelles. Inversement, une phrase surprenante ne garantit pas que tout le texte a été écrit sans assistance.
La perplexité dépend du modèle qui sert de référence. Elle n’est pas une note de créativité ou de compétence linguistique. Surtout, il serait excessif de décrire tous les détecteurs contemporains comme de simples compteurs de mots prévisibles.
Le bon réflexe consiste donc à demander ce que le score permet effectivement d’inférer. Une caractéristique observée dans un corpus ne donne pas accès aux intentions d’un individu. Pour évaluer une copie, il faut encore examiner le contenu, le processus et les règles.
Une étude européenne de 2026 limite les généralisations
Dans Different Time, Different Language, publié en mars 2026, Adnan Al Ali et ses collègues ont réexaminé la question en tchèque. Ils n’ont pas constaté de biais systématique contre les personnes non natives dans les conditions étudiées et ont montré que les méthodes évaluées pouvaient fonctionner sans dépendre de la perplexité.
Ce résultat invite à distinguer une hypothèse utile d’une règle universelle. Une observation anglaise de 2023 ne décrit pas automatiquement un texte français évalué en 2026.
Il ne faut pas davantage transformer le résultat tchèque en garantie pour les étudiants francophones. Le protocole fournit une réponse dans un contexte défini. Il indique surtout les vérifications supplémentaires à demander lorsqu’un établissement utilise un outil sur un autre public.
Que sait-on pour le français et les étudiants de FLE ?
Les études présentées ici ne donnent pas un taux universel de faux positifs pour les dissertations en français langue étrangère. Nous ne reprenons donc pas le chiffre de Stanford pour annoncer que six copies françaises sur dix seraient mal classées.
Le benchmark MULTITuDE, publié en décembre 2023, rassemble 74 081 textes dans onze langues pour étudier la détection multilingue. Le français ne figure pas dans ce jeu de données. Cette absence limite l’usage qu’on peut en faire pour chiffrer le risque sur une copie française.
Il faut également distinguer trois situations : une personne francophone qui écrit un article en anglais, une personne allophone qui prépare un mémoire en français et une personne qui traduit son propre texte. Les enjeux linguistiques se recoupent, mais les documents produits ne sont pas équivalents.
La nationalité n’est pas non plus une description suffisante du parcours linguistique. Dans un dossier individuel, demandez quelle langue a servi à la rédaction et quelles aides ont été utilisées, plutôt que de déduire ces informations du nom de famille ou du pays d’origine.
Un score ne tranche pas la question de la correction linguistique
Supposons qu’une étudiante prépare elle-même l’argumentation de son mémoire, puis demande une correction de langue. Pour examiner le travail, il faudrait identifier les modifications : accords rectifiés, phrases remplacées, idées ajoutées ou passages traduits. L’exemple est fictif et sert à distinguer les tâches.
Une formule comme « assistance linguistique » peut couvrir des interventions très différentes. Si le système a proposé de nouveaux arguments, cela mérite une description distincte. Si seules quelques erreurs ont été repérées, ne décrivez pas non plus tout le mémoire comme une production automatique.
Le travail de synthèse de Victor Angelier du 18 septembre 2026 distingue les faux positifs proprement dits des cas limites impliquant traduction ou révision par IA. Cette distinction aide à poser la question réglementaire : quel usage était autorisé pour ce devoir ou cette publication ?
Pour les manuscrits, consultez notre guide des règles des concours littéraires et des éditeurs sur l’IA. Une exception prévue par un destinataire ne vaut pas automatiquement chez un autre.
Comment documenter son travail sans écrire pour le détecteur
Nous recommandons une méthode légère : garder les documents qui jalonnent réellement la rédaction, sans constituer artificiellement un dossier de défense à chaque phrase. Le but est de pouvoir expliquer une progression, pas de produire un historique spectaculaire.
- Avant la rédaction : conservez le sujet, les consignes et votre premier plan.
- Pendant la recherche : distinguez citations, références et commentaires personnels.
- Avant une correction importante : gardez la version antérieure.
- Après la correction : notez ce qui a été modifié et par qui.
- Au moment de remettre le texte : conservez le fichier exact et l’éventuelle déclaration demandée.
Demandez les limites autorisées avant d’utiliser une fonction ambiguë. Une question précise pourrait être : « Puis-je demander à l’outil de signaler les accords incorrects sans accepter ses reformulations ? » L’interlocuteur peut ainsi répondre sur un procédé identifiable.
N’ajoutez pas volontairement des erreurs pour paraître plus humain. Ne remplacez pas non plus des mots précis par des formulations compliquées afin de modifier un score. Votre objectif reste de transmettre votre pensée et de respecter les consignes de l’exercice.
Comment répondre à une accusation lorsqu’on écrit dans une langue seconde
Commencez par demander le rapport et la version analysée. Puis préparez une réponse courte qui relie les passages signalés à votre travail. Si une correction extérieure a eu lieu, précisez son périmètre et montrez, lorsque vous les avez, les versions avant et après.
Vous pouvez aussi expliquer pourquoi vous avez conservé une formulation simple : terme technique appris en cours, consigne de concision ou besoin de lever une ambiguïté. Il ne s’agit pas de prouver votre innocence par votre niveau de langue, mais de donner du contexte aux choix observés.
Lors d’un entretien, demandez ce qui doit être clarifié et préparez les documents correspondants. Une difficulté à improviser dans une langue seconde ne devrait pas être assimilée à une impossibilité d’avoir rédigé le texte. Notre article sur les faux positifs et les contestations détaille les autres éléments à conserver.
Ce que les enseignants peuvent changer dans l’évaluation
Nous proposons de séparer la qualité du raisonnement, la maîtrise linguistique et le respect des conditions de réalisation. Selon l’exercice, ces dimensions peuvent avoir des poids différents. Les expliciter aide l’étudiant à comprendre ce qu’il doit accomplir seul et ce qu’il peut faire corriger.
- Définir les fonctions autorisées plutôt que citer uniquement des marques.
- Prévoir un format simple de déclaration de l’aide reçue.
- Demander des étapes intermédiaires lorsqu’elles servent l’apprentissage.
- Examiner les explications de l’étudiant avant de conclure à une fraude.
- Ne pas traiter l’accent ou la fluidité orale comme une mesure de l’auteur réel.
Cette approche ne suppose pas que toute déclaration soit exacte. Elle permet de vérifier un cas avec des questions portant sur le travail, plutôt que de transformer un profil linguistique en soupçon. L’incertitude doit rester visible tant que les éléments disponibles ne permettent pas de la lever.
À lire aussi : mon test du roman d’Orélien dans trois détecteurs, que faire en cas de fausse accusation d’IA, Détecteurs d’IA : faux positifs et accusations injustifiées.
Questions fréquentes
Les détecteurs pénalisent-ils toujours les personnes non natives ?
Non. Des écarts ont été mesurés dans certains corpus anglais. L’étude tchèque présentée ici montre que leur généralisation à toutes les langues serait excessive.
Le chiffre de Stanford s’applique-t-il au français ?
Non. Il décrit une expérience sur des textes anglais. Il ne fournit pas un pourcentage d’erreurs pour les mémoires ou dissertations en français.
Écrire simplement augmente-t-il automatiquement mon score ?
On ne peut pas le prédire pour un texte individuel à partir des études citées. Aucun conseil stylistique universel ne permet d’en déduire le résultat d’un outil propriétaire.
Puis-je faire corriger mon mémoire par une IA ?
Vérifiez les consignes de votre formation et la fonction envisagée. Repérage d’erreurs, reformulation et génération doivent être distingués dans la demande d’autorisation.
Dois-je mentionner mon parcours linguistique dans ma réponse ?
Vous pouvez l’expliquer s’il éclaire un choix de rédaction ou une aide autorisée. Il doit servir de contexte, pas remplacer les éléments relatifs au travail remis.
Sources
- Liang et al., GPT detectors are biased against non-native English writers - 2023-04-06; v3: 2023-07-10 ; consulté le 14 octobre 2026.
- Stanford HAI, AI-Detectors Biased Against Non-Native English Writers - 2023-05-15 ; consulté le 14 octobre 2026.
- Al Ali, Helcl & Libovický, Different Time, Different Language - mars 2026 ; consulté le 14 octobre 2026.
- Macko et al., MULTITuDE - décembre 2023 ; consulté le 14 octobre 2026.
- Victor Angelier, The pitfalls of AI detection in academic writing - 2026-09-18 ; consulté le 14 octobre 2026.

More on this from PROMPTIF

 magazine·Détecteurs d’IA : faux positifs et accusations injustifiéesMémoire signalé comme IA ? Cas français et internationaux, limites des scores et démarches pour expliquer ou contester un résultat.