ACE-Step 1.5 : générateur de musique IA local sur RTX 4090
ACE-Step 1.5 produit des morceaux complets avec voix directement sur votre carte graphique sous licence MIT. Voici mon banc d'essai complet sur RTX 4090 face à trois autres modèles locaux.
👁 130 lectures
ACE-Step 1.5 s’impose comme un générateur de musique IA local open source sous licence MIT capable de créer une piste stéréo complète avec voix et paroles sur sa propre carte graphique. Lors de mes benchmarks du 17 octobre 2026 sur ma RTX 4090, le modèle a restitué en moyenne 95,6% des mots dans un test multilingue exigeant, générant deux minutes d’audio en 34 à 91 secondes. Pour situer ces capacités dans un cadre plus large, vous pouvez explorer mon guide sur l’IA locale pour les modèles texte, image et vidéo.
Au 17 octobre 2026
- ACE-Step 1.5 (ACE Studio et StepFun, poids publiés en janvier 2026, licence MIT libre y compris pour un usage commercial) : architecture de diffusion 2B déclinée en Turbo, Base et SFT, complétée par une variante XL (4B) depuis le 2 avril 2026.
- Planificateur linguistique (dérivé de Qwen3) disponible en trois échelles : 0,6B, 1,7B et 4B.
- Intégration native dans ComfyUI : modèle prêt à l’emploi accessible via le menu Templates avec les fichiers distribués par l’organisation Comfy-Org.
- Conditions de mon banc d’essai : machine équipée d’une RTX 4090 24 Go, ComfyUI 0.41, ACE-Step 1.5 Turbo couplé au planificateur 1.7B, évaluation de la clarté vocale par Whisper large-v3.
Qu’est-ce qu’ACE-Step 1.5 et comment fonctionne son architecture
Le système transforme une description textuelle de style musical ainsi que des paroles balisées en un fichier audio stéréo prêt à l’écoute. La version 1.5 combine deux modules complémentaires : d’une part, un petit modèle de langage (le planificateur textuel) qui décompose la structure et organise les codes acoustiques ; d’autre part, un modèle de diffusion de 2 milliards de paramètres (2B) qui synthétise la matière sonore à partir de ce séquençage. D’après la documentation officielle des concepteurs, l’outil gère aussi bien des boucles de quelques secondes que des compositions atteignant 10 minutes, prend en charge plus de 50 langues et peut tourner sur des GPU disposant de moins de 4 Go de mémoire grâce au déchargement vers la mémoire vive.
Au-delà de la composition text-to-music intégrale, la structure prend en charge les reprises (covers), la retouche de segments spécifiques (repainting) et l’ajout d’une orchestration complète sur une piste vocale isolée. L’un des attraits majeurs réside dans sa licence MIT, qui autorise librement une exploitation commerciale directe de vos pistes. Cette ouverture tranche avec d’autres options locales : YuE2 reste restreint par une licence CC BY-NC 4.0 à visée non commerciale, tandis que le modèle décrit dans mon analyse de MiniMax Music 3 impose des critères particuliers aux entreprises selon leur chiffre d’affaires.
Comment exécuter ce générateur de musique IA local dans ComfyUI
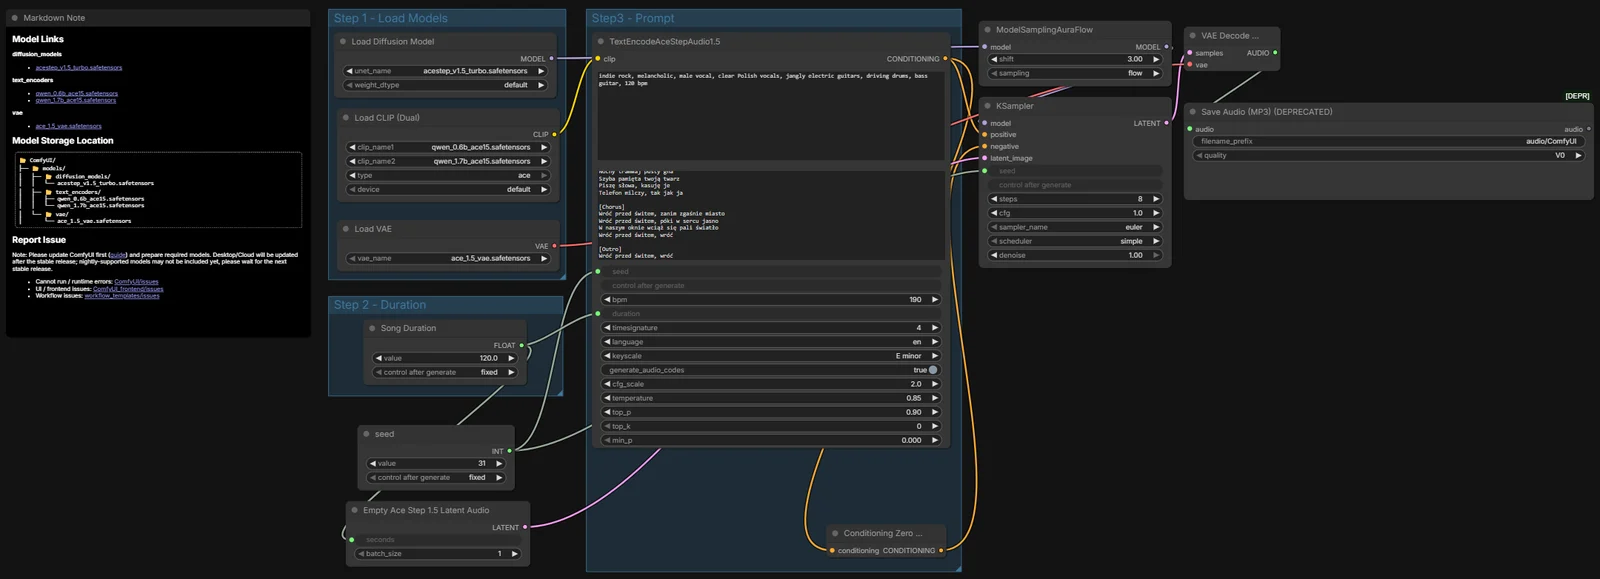
L’intégration d’ACE-Step 1.5 dans ComfyUI s’effectue sans difficulté particulière grâce aux configurations préparées par l’équipe officielle. Voici les étapes détaillées pour le configurer sur votre poste de travail :
- Assurez-vous de disposer d’une version opérationnelle de ComfyUI (version 0.41 ou plus récente).
- Ouvrez le menu Templates, recherchez « ACE-Step 1.5 » et sélectionnez le gabarit basé sur les fichiers séparés (split).
- Téléchargez les quatre fichiers nécessaires depuis le dépôt Hugging Face
Comfy-Org/ace_step_1.5_ComfyUI_files: placezacestep_v1.5_turbo.safetensors(4,8 Go) dans le sous-dossiermodels/diffusion_models, les encodeursqwen_0.6b_ace15.safetensors(1,2 Go) etqwen_1.7b_ace15.safetensors(3,7 Go) dansmodels/text_encoders, puis le décodeurace_1.5_vae.safetensors(0,3 Go) dansmodels/vae. L’ensemble occupe environ 10 Go d’espace disque. - Dans le nœud TextEncodeAceStepAudio1.5, saisissez vos descripteurs d’ambiance sonore (tags), vos paroles segmentées par des sections
[verse]et[chorus], le tempo, la tonalité ainsi que la durée. Pensez à ajuster le paramètre de langue (la valeur par défaut étant configurée sur « en »). - Définissez la durée souhaitée à la fois dans le champ texte (duration) et dans le bloc EmptyAceStep1.5LatentAudio (seconds). Dans le template d’origine, ces paramètres sont synchronisés par un nœud unique nommé « Song Duration ».
- Lancez le traitement en cliquant sur Run. La piste finale est enregistrée directement dans le répertoire
ComfyUI/output/audio.
Les concepteurs signalent qu’une variante XL (4B) fournit une définition sonore plus fine. Toutefois, le fichier du modèle Turbo XL pèse à lui seul 10 Go en bf16 et réclame un planificateur 4B de 8,4 Go supplémentaires. Bien qu’une carte de 24 Go encaisse cette charge, un GPU doté de 12 Go nécessitera un déchargement partiel vers la RAM système.
Performances sur RTX 4090 : résultats de mes tests
Pour évaluer rigoureusement la précision de diction et la tenue de la structure, j’ai soumis ACE-Step 1.5 Turbo (8 étapes d’échantillonnage, planificateur 1.7B) à deux exercices distincts. Le premier test repose sur un morceau synthpop en anglais. Le second test constitue une épreuve multilingue complexe : une ballade vocale féminine avec des paroles rédigées en polonais (83 mots, incluant des spécificités phonétiques dures) avec l’instruction de style « Polish pop ballad, warm female vocals, piano and soft synth pads » et une cible de 120 secondes. Chaque piste générée a ensuite été retranscrite mot à mot par l’intermédiaire de Whisper large-v3 afin de calculer le taux exact de mots fidèlement chantés dans l’ordre du texte.
| Essai | Mots chantés reconnus | Temps global | Pic VRAM |
|---|---|---|---|
| Anglais (synthpop) | 96,1% (73/76) | 8,0 s | 15,2 Go |
| Test multilingue (graine 11) | 94,0% (78/83) | 35,2 s | 20,0 Go |
| Test multilingue (graine 22) | 94,0% (78/83) | 91,4 s | 14,0 Go |
| Test multilingue (graine 33) | 98,8% (82/83) | 34,1 s | 10,7 Go |
Les enseignements tirés de ces sessions d’écoute confirment les points suivants :
- Vitesse brute impressionnante : lorsque le modèle réside déjà dans la mémoire vidéo, la production d’un morceau de 2 minutes en anglais n’a demandé que 8 secondes sur ma RTX 4090. Les durées supérieures relevées sur les autres itérations proviennent principalement du chargement initial des fichiers par ComfyUI lors des changements de routine.
- Régularité et clarté phonétique : sur le test multilingue, le modèle maintient une régularité remarquable entre 94% et 98,8%, sans décrochage instrumental ni hallucination de phrases parasites. Les rares imperfections portent sur de petites confusions de phonèmes isolés ou des noms propres géographiques.
- Respect strict du minutage : contrairement à d’autres architectures qui interrompent arbitrairement leur génération, ACE-Step applique rigoureusement la valeur temporelle configurée et délivre l’intégralité des 2 minutes demandées.
Comparatif : ACE-Step 1.5 face à YuE2, MiniMax Music 3 et DiffRhythm 2
Afin de mesurer la valeur d’ACE-Step 1.5, j’ai soumis exactement les mêmes paroles et paramètres stylistiques à trois autres générateurs exécutés localement sous ComfyUI 0.41 : YuE2 (3B), MiniMax Music 3 et DiffRhythm 2. Le tableau suivant synthétise les résultats enregistrés le 17 octobre 2026 pour le test en langue anglaise (une passe par modèle) :
| Modèle | Mots reconnus (anglais) | Durée produite | Temps sur RTX 4090 |
|---|---|---|---|
| YuE2 (3B) | 100% | 1:57 min | 32 s |
| DiffRhythm 2 | 100% | 1:58 min | env. 60 s |
| ACE-Step 1.5 Turbo | 96,1% | 2:00 min | 8 s |
| MiniMax Music 3 | 92,1% | 2:30 min | 305 s |
Sur le texte en anglais, YuE2 et DiffRhythm 2 atteignent un score sans faute de 100%, mais ACE-Step 1.5 se montre radicalement plus rapide avec seulement 8 secondes de calcul. MiniMax Music 3, quant à lui, s’avère particulièrement lourd avec plus de 5 minutes de traitement sur 24 Go de VRAM.
Le comportement de ces outils varie nettement dès qu’on sort de l’anglais. Sur le banc d’essai multilingue (3 graines par modèle avec des paroles non anglophones), la hiérarchie bascule :
| Modèle | Moyenne multilingue | Licence | Usage commercial |
|---|---|---|---|
| ACE-Step 1.5 Turbo | 95,6% | MIT | Oui |
| YuE2 (3B) | 91,2% | CC BY-NC 4.0 | Non |
| MiniMax Music 3 | 89,2% (morceaux écourtés) | MiniMax Community | Oui (sous conditions) |
| DiffRhythm 2 | 4,8% (1 seul essai) | Apache 2.0 | Oui (anglais/chinois uniquement) |
Sur ce banc multilingue, ACE-Step 1.5 Turbo arrive en tête avec 95,6% de moyenne (94,0%, 94,0% et 98,8%). YuE2 atteint un pic remarquable à 98,8% mais montre une variabilité plus prononcée (descente à 84,3%), ce qui oblige souvent à produire deux ou trois variantes pour retenir la meilleure prise. MiniMax Music 3 a tendance à écourter les compositions (arrêts constatés à 73, 92 et 111 secondes au lieu des 150 secondes allouées) tout en mobilisant l’intégralité des 24 Go de mémoire. Enfin, DiffRhythm 2 ne prend pas en charge cette typologie linguistique et transforme le texte en bouillie sonore, sa phonétique étant réservée à l’anglais et au chinois.
Côté ressources matérielles, les profils d’exécution présentent des écarts notables lors du traitement complet :
- ACE-Step 1.5 Turbo : 34 à 91 secondes par composition, occupation VRAM crête oscillant entre 10,7 et 20,0 Go selon les données temporairement maintenues en mémoire par ComfyUI.
- YuE2 (bf16) : 61 à 108 secondes, avec un pic mémoire mesuré entre 13,3 et 16,3 Go.
- MiniMax Music 3 : 113 à 178 secondes sur le test multilingue (et jusqu’à 305 secondes en anglais), avec une empreinte montant entre 18,4 et 24,1 Go.
- DiffRhythm 2 : environ 60 secondes par génération.
Si votre objectif consiste uniquement à produire des arrière-plans musicaux sans chant, notez qu’une solution dédiée comme celle détaillée dans mon banc d’essai de Stable Audio 3 offre une approche complémentaire adaptée à l’instrumental sous licence Stability Community.
Quel modèle choisir selon vos besoins
- Pour des créations commerciales multilingues : choisissez ACE-Step 1.5. C’est le plus régulier dans la prononciation hors anglais, le plus rapide en version Turbo et sa licence MIT écarte tout blocage contractuel.
- Pour un rendu anglophone optimal à usage privé : YuE2 offre une excellente articulation à 100% sur l’anglais, à condition de respecter sa licence CC BY-NC 4.0 interdisant toute monétisation.
- Pour des maquettes rapides en masse : ACE-Step 1.5 s’impose dès que vous souhaitez itérer par dizaines d’essais sans saturer votre machine.
- MiniMax Music 3 : à réserver si sa couleur acoustique spécifique vous intéresse, en gardant en tête sa forte consommation de VRAM et son temps de calcul élevé. Pour comparer ces coûts d’infrastructure matérielle face aux services distants, n’hésitez pas à consulter mon dossier modèle IA local ou API : le coût réel.
Foire aux questions
Quelle quantité de VRAM ACE-Step 1.5 nécessite-t-il ?
Sur ma RTX 4090, le pic d’allocation globale s’est situé entre 10,7 et 20,0 Go selon l’état du cache de ComfyUI. D’après le dépôt officiel, la version 2B Turbo sans planificateur fonctionne dès 6 Go de mémoire vidéo avec quantification int8 et déchargement CPU. Une enveloppe de 8 à 16 Go permet d’utiliser le modèle Turbo ou SFT avec un planificateur de 0,6B à 1,7B, tandis que la déclinaison XL sans déchargement requiert entre 20 et 24 Go.
Quelles sont les différences entre les versions Turbo, Base et SFT ?
L’édition Turbo exécute sa synthèse en seulement 8 étapes d’échantillonnage, privilégiant une rapidité extrême idéale pour la génération itérative locale. Les déclinaisons Base et SFT s’appuient sur 50 étapes afin d’affiner la précision audio au détriment de la vitesse. La version SFT bénéficie en outre d’un réentraînement supervisé supplémentaire conçu pour rehausser la qualité générale du mixage.
Peut-on exploiter commercialement les morceaux générés par ACE-Step ?
Oui, les poids d’ACE-Step 1.5 sont publiés sous licence MIT, ce qui autorise une utilisation commerciale sans redevance. Gardez à l’esprit que les plateformes de streaming musical appliquent leurs propres règles quant aux contenus générés par IA, et que le statut du droit d’auteur sur les fichiers purement synthétiques dépend des juridictions locales. En revanche, vos propres paroles demeurent votre propriété intellectuelle.
Le modèle peut-il tourner sans carte graphique dédiée ?
Le dépôt officiel mentionne la possibilité d’un fonctionnement sur processeur, mais avec des temps de génération considérablement plus longs. La distribution prend également en charge l’accélération matérielle Apple Silicon (MPS), AMD (ROCm) et Intel (XPU). Sur les configurations disposant de 6 Go de mémoire ou moins, le système active automatiquement une quantification int8 et décharge une partie des couches vers la mémoire centrale.
Comment structurer ses paroles pour obtenir un chant naturel ?
Privilégiez des vers concis dotés d’un nombre de syllabes régulier pour aider le modèle à caler le rythme naturel des phrases. Séparez distinctement les différentes parties de votre morceau avec des balises en début de ligne telles que [verse] ou [chorus], et évitez autant que possible les amalgames de consonnes trop denses ou les noms propres atypiques.
Sources
- Dépôt officiel ACE-Step 1.5 sur GitHub (licence MIT).
- Fiche de modèle ACE-Step/Ace-Step1.5 sur Hugging Face.
- Fichiers ComfyUI : Comfy-Org/ace_step_1.5_ComfyUI_files.
- Modèle m-a-p/YuE2-3B sur Hugging Face (licence CC BY-NC 4.0).
- Dépôt MiniMaxAI/MiniMax-Music3 (licence MiniMax-Music3 Community).
- Dépôt officiel DiffRhythm 2 sur GitHub.
- Mesures personnelles réalisées sur RTX 4090, 17 octobre 2026, ComfyUI 0.41, évaluation de clarté par Whisper large-v3.
Vérifié le 17 octobre 2026.

More on this from PROMPTIF