rubrique · 207 articles · dernier 10.11.2026 · page 7
Benchmarks
 benchmarks·Claude Opus 5 et 5 autres IA : test sur 8 questions de biologieAnthropic a renforcé ses garde-fous sur les questions à double usage.
 benchmarks·Echelle de confiance IA : 0-20 plus efficace que 0-100
 benchmarks·PIDS-Bench : faiblesses des détecteurs de prompt injection
 benchmarks·GPT-4.1 : la cohérence des agents IA mise à l’épreuve
 benchmarks·Test de 7 modèles d’IA : Claude Opus 5, GPT-6 Astra, Gemini 3.1
 benchmarks·Le modèle refuse de lire le document : test chez trois fournisseurs
 benchmarks·Qwen-Image-2.1 : classement complet de 29 modèles d’images IALe fabricant a publié un graphique comparant 29 modèles d'images IA.
 benchmarks·Qwen-Image-2.1 : test des poids officiels sans modérationLes versions « sans censure » changent les données d'entraînement, pas le filtre.
 benchmarks·Qwen-Image-2.1 : affiches IA testées dans 8 styles graphiquesHuit styles graphiques, un seul texte à afficher. Sept titres corrects, zéro texte lisible en petit.
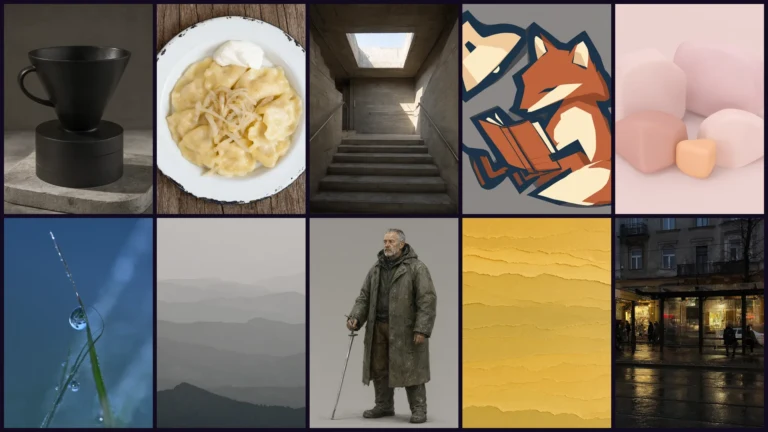 benchmarks·Qwen-Image-2.1 : test sur dix styles d’images différentsDe la photo produit à l'illustration vectorielle.
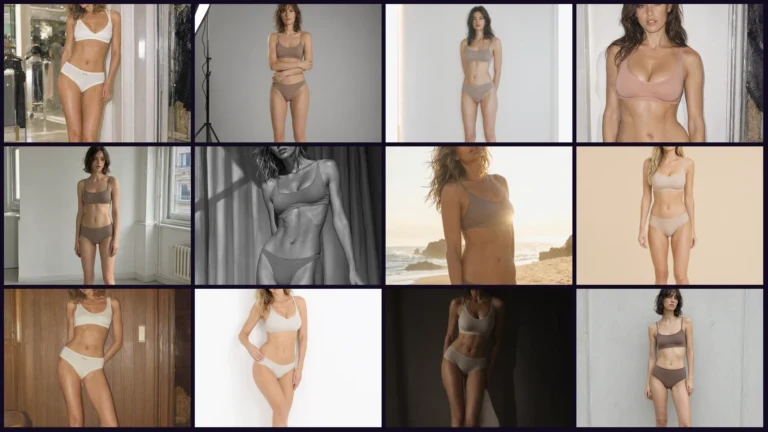 benchmarks·Qwen-Image-2.1 : 12 styles de photographie de mode testésFilm 35 mm, moyen format, polaroid, flash années 90, high key et low key.
 benchmarks·Grok Imagine Image 2.0 : test, prix et performances
 benchmarks·MiMo, Qwen3.8 Max, GLM-5.3 et Muse Spark : test en polonais
 benchmarks·Rebranding de marques : test typographique de Qwen-Image-2.1
 benchmarks·Claude Opus 5.5 benchmarks : tableau complet et notes explicativesTerminal-Bench 66,4%, GDPval-AA 1846 Elo, OSWorld 81,8%.
 benchmarks·Claude Opus 5.5 ou Fable 5.1 : quand payer 2,5 fois plus ?Opus 5.5 surpasse Fable 5.1 dans tous les benchmarks d'Anthropic et coûte 2,5 fois moins cher.
 benchmarks·Claude Opus 5.5 invente-t-il des chiffres ? Test avec piègeNote sans bénéfice, marge ni rotation, mais la direction exige les trois.
 benchmarks·Claude Opus 5.5 : low, medium ou high - test des niveaux d’effortLe niveau d'effort par défaut passe de high à medium.
 benchmarks·GPT-6 Luna : le modèle OpenAI le moins cher testé pour 0,0024 USDGPT-6 Luna coûte 0,10/0,50 USD par million de tokens.
 benchmarks·AI Act : test de 9 chatbots, 8 donnent des dates périméesNous avons posé 8 questions sur l'AI Act à 9 modèles d'IA. Seul Perplexity avec recherche web a tout bon.
 benchmarks·SWE-Flux : les LLM ne comprennent pas le code en exécution
 benchmarks·Midjourney vs Gemini : quel générateur d’images choisir ?Google Gemini 2.5 Flash Image mise sur la vitesse et le prix.
 benchmarks·Test Gemma 4 12B : 7 modèles IA locaux sur RTX 4090Gemma 4 12B obtient 72,3 points sur RTX 4090 face à 6 autres modèles locaux.
 benchmarks·Opus 5.5 génère du SVG : infographie, lama et animationOpus 5.5 crée des graphiques SVG : infographie avec données au pixel près, illustration et animation CSS.
 benchmarks·Test GPT Image 2.5 et 5 générateurs d’images IA méconnus
 benchmarks·ElevenLabs Scribe en français : test avec noms difficilesTest de Scribe v2 en français : interview avec noms propres difficiles et 13 nombres.