rubrique · 207 articles · dernier 10.11.2026 · page 6
Benchmarks
 benchmarks·Step 5 vs Kimi K3, GLM-5.3, Qwen et DeepSeek : le comparatifQue vaut Step 5 face à Kimi K3, GLM-5.3, Qwen3.8 et DeepSeek ?
 benchmarks·Odyssey-3 : que vaut ce modèle de monde interactif ? Notre testOdyssey-3 génère un monde 3D interactif depuis un simple texte en temps réel et gratuitement.
 benchmarks·Vidu Q4 Preview : classement vidéo IA, prix et prise en mainVidu Q4 Preview se hisse à la 3e place du classement vidéo IA d'Artificial Analysis avec 1179 Elo.
 benchmarks·Vidu Q4 vs Seedance 2.0 vs MiniMax H3 : le comparatifVidu Q4, Seedance 2.0 ou MiniMax H3 ?
 benchmarks·Gemma 4 31B en local sur RTX 4090 : performances et VRAM
 benchmarks·Test de Wan 3.0 d’Alibaba : le modèle vidéo n°1 à l’épreuveWan 3.0 d'Alibaba génère 30 s de vidéo avec audio à 0,10 $/s.
 actualités·Gemini 4 Argon vs GPT-6.1 Sol : lequel choisir ?
 benchmarks·Meilleure IA vidéo 2026 : comparatif de 10 modèles via API
 benchmarks·Claude Opus 5.5 : prix, benchmarks et tests complets
 benchmarks·Test de Claude Fable 5.1 : un blocage sur une tâche simpleNous avons testé Claude Fable 5.1 dès sa sortie sur des tâches en polonais.
 benchmarks·Benchmarks GPT-6 Astra : trois tests où il perdNous avons analysé tous les benchmarks de GPT-6 Astra.
 benchmarks·Test GPT-6 Astra : code, contexte long et résultats surprenants
 benchmarks·Imagen 2 vs Imagen Pro vs DALL-E 3 : test comparatif
 benchmarks·Test hallucinations GPT-6 Astra, Claude et GeminiNous avons interrogé quatre modèles sur des personnes, lois et villes inventées.
 benchmarks·GPT-6 Astra vs Claude : 56% de tokens en plus pour le polonais
 benchmarks·GPT-6 Astra programmation : résultats tests et limites
 benchmarks·ChatGPT Images 2.5 vs 2.0 : comparatif des différences
 benchmarks·Édition d’image dans ChatGPT : test de onze correctionsUne correction ne modifie-t-elle que la zone demandée ?
 benchmarks·Qwen3.8 Max : test en polonais, résultats, prix et accès
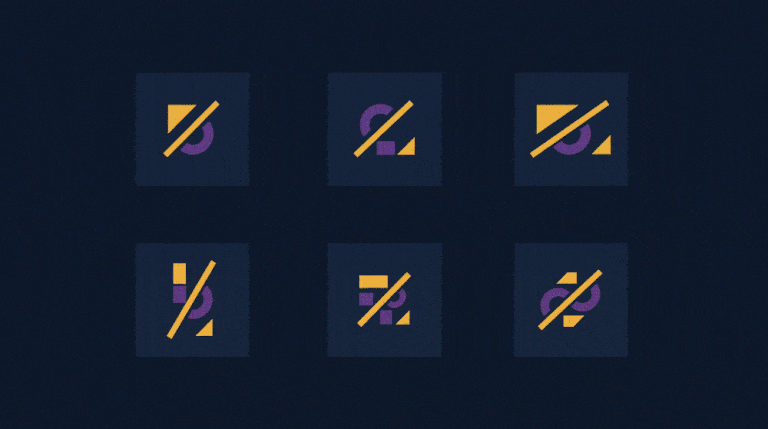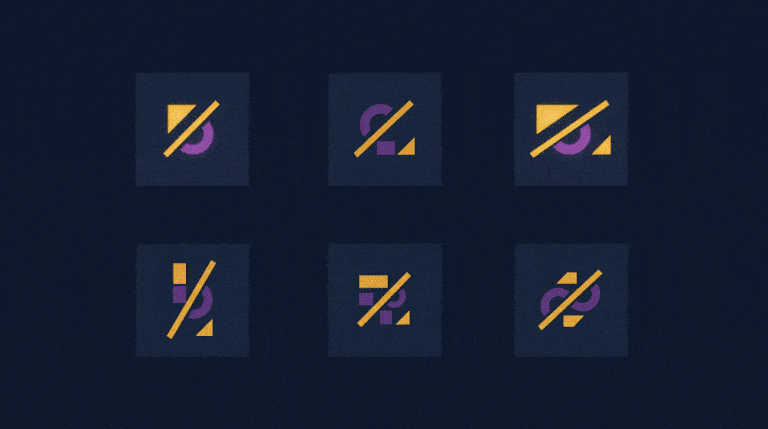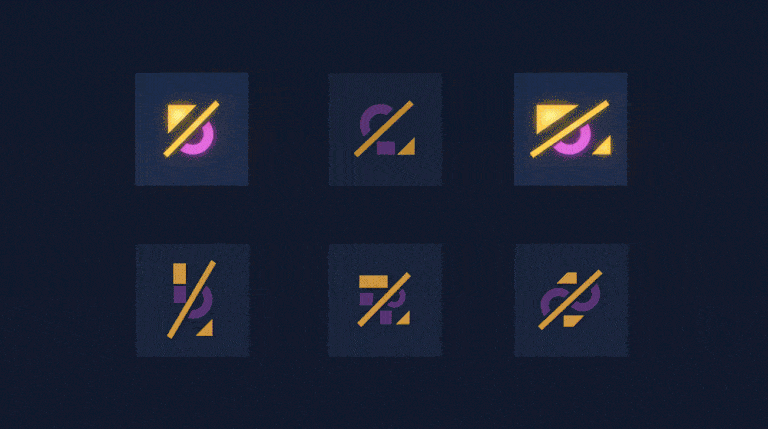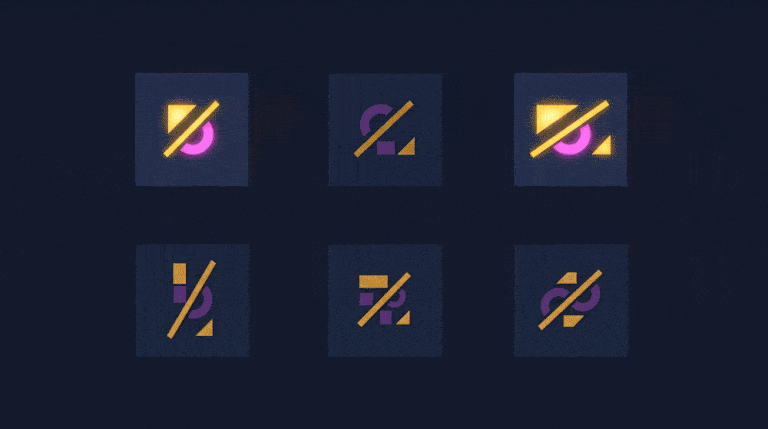 benchmarks·Logo avec IA : six variantes, un problème invisibleSix variantes d'un même logo générées par IA.
 benchmarks·GLM 5.3 : le coût réel de ce modèle bon marché
 benchmarks·OpenRouter : le prix affiché n’est pas celui que vous payez
 benchmarks·Test GPT-6 Astra : 11 modèles IA face à 9 défis de codeNeuf tâches, onze modèles, notation automatique.
 benchmarks·Coût réel d’un article généré par IA : test sur 8 modèlesHuit modèles, un même article de 900 mots : le moins cher coûte 0,00039 USD, le plus cher 0,18913 USD.
 benchmarks·Test fenêtre de contexte IA : Gemini 3.8 Flash vs GPT-6 AstraNous avons caché une phrase dans 90 000 caractères de texte et demandé à cinq modèles de la trouver.
 benchmarks·18 modèles IA testés : 7 imposent le raisonnementSept modèles sur dix-huit refusent de désactiver le raisonnement. Tous sont de dernière génération.