Lip-sync IA : test de Seedance 2.5, Wan 3.0 et InfiniteTalk
Test comparatif de Seedance 2.5, Wan 3.0 et InfiniteTalk sur un chant polonais : synchronisation labiale, coûts et temps de génération.
👁 119 lectures
J’ai testé des outils de lip-sync IA sur un chant polonais, avec le même extrait et le même cadrage du personnage. Seedance 2.5 a produit l’image que je préfère, mais c’est celui qui a le moins bien synchronisé les lèvres avec le chant. Wan 3.0 a permis d’obtenir plus rapidement un résultat exploitable, malgré une limite de durée. InfiniteTalk, exécuté en local, a obtenu le meilleur score de mesure, au prix d’un temps d’attente plus long.
En bref
Sur les 15 premières secondes comparées, InfiniteTalk a obtenu une corrélation de 0,471, Wan 3.0 de 0,419 et Seedance 2.5 de 0,153. Cet indicateur mesure la correspondance entre l’ouverture de la bouche et le volume du chant : il ne représente pas le pourcentage de paroles correctement chantées. Pour un plan axé sur le playback, je choisirais InfiniteTalk. Seedance me servirait plutôt de base visuelle à retravailler.
Même extrait, même personnage
J’ai choisi un extrait de « Quand je joue à ma façon », traduction du titre polonais « Kiedy po swojemu gram », de 14,5 à 34,5 s. Il comprend le deuxième refrain, l’entrée de la batterie et le début du couplet. Je ne me suis donc pas limité à une voyelle tenue et calme. Le passage change d’énergie, ce qui aide à voir si le visage réagit au chant ou s’il se contente d’une animation spectaculaire. Le test a été réalisé en polonais ; le titre traduit ici est celui du morceau original.
Le point de départ était le même cadrage du personnage, préparé en local avec Z-Image Turbo. Pour les variantes API, j’ai utilisé la référence audio via le moteur TAKT. La variante locale reposait sur InfiniteTalk lancé avec WanVideoWrapper, avec Wan 2.1 I2V 14B fp8 comme modèle de base et lightx2v à 6 étapes. Il s’agit d’une comparaison de configurations précises, pas de toutes les possibilités de ces modèles.
Je voulais comparer les 20 secondes complètes, mais Wan 3.0 n’a pas terminé une demande de cette durée. J’ai donc retenu les 15 premières secondes comme segment commun pour les mesures. Je n’intègre pas les résultats du passage plus long au classement commun : les modèles auraient été comparés sur des contenus différents, et le tableau aurait donné à la méthode une apparence de fiabilité excessive.
Comment j’ai mesuré le lip-sync avec MediaPipe
Dans le script lipsync_pomiar.py, j’ai comparé l’ouverture de bouche détectée par MediaPipe au volume du chant isolé avec demucs. J’ai recherché un décalage dans une plage de ±0,5 s. Avec la méthode retenue, une corrélation plus élevée indique une meilleure correspondance entre ces deux courbes. Cela permet de distinguer la réaction générale du visage à la voix de la simple impression que le personnage « chante quelque chose ».
Cette mesure a ses limites. Le volume ne décrit pas la forme exacte que doivent prendre les lèvres pour chaque son polonais. La fermeture des lèvres, l’articulation des consonnes et le naturel des expressions nécessitent une évaluation visuelle complémentaire. Je n’interprète donc pas la corrélation comme une évaluation automatique de la prononciation ni comme une preuve que le public croira à l’interprétation de toute la chanson.
J’ai aussi relevé la détection des visages. Elle était de 100 % pour InfiniteTalk et Wan, et de 69 à 76 % pour Seedance. Une détection moins fréquente limite la complétude de la mesure et rend les conclusions directes plus difficiles. Le rapport ne permettant pas d’établir la cause des détections manquantes, je n’en avance aucune. Je combine cet indicateur avec le visionnage des séquences au lieu de le traiter comme un verdict suffisant à lui seul.
La recherche d’un décalage signifie également que le résultat décrit la correspondance des courbes après leur alignement. Il ne prouve pas que le fichier téléchargé depuis le générateur démarre d’emblée avec une piste parfaitement synchronisée. Pour monter le plan final, je vérifie donc séparément le décalage fixe et le maintien de la synchronisation au fil des phrases. Décaler toute la piste audio peut améliorer le début, mais ne remplace pas une animation labiale adaptée pour la suite du chant.
Résultats, coûts et temps d’attente
| Variante | Lip-sync, 15 s | Coût relevé pendant le test | Durée |
|---|---|---|---|
| InfiniteTalk en local | 0,471 | 0 € de frais de génération, hors électricité | 1284 s |
| Wan 3.0 via API | 0,419 | 0,945 € (1,0594 USD) | 330 s |
| Seedance 2.5 via API | 0,153 | 4,762 € (5,3365 USD) | 316 s |
Les durées concernent les clips obtenus : 20 s en local et avec Seedance, 15 s avec Wan. La durée commune ne s’applique qu’à la colonne de mesure de synchronisation. Ces montants correspondent aux coûts de ce test, pas à un tarif valable à tout moment. Les montants en euros sont des estimations converties, et non des prix de paiement locaux. Je n’ajoute pas le coût de l’électricité, que je n’ai pas mesuré.
Les paramètres d’image différaient aussi. InfiniteTalk a produit une vidéo en 832×480 à 25 images/s, Wan en 1280×720 à 30 images/s et Seedance en 1280×720 à 24 images/s. Il faut tenir compte de ces différences au montage. Dans cette comparaison, une résolution supérieure ne s’est toutefois pas traduite par une meilleure synchronisation des lèvres avec le chant.
Note sur la conversion : les montants en USD sont convertis à titre indicatif au taux de référence de la BCE du 22 octobre 2026, selon 1 EUR = 1,1205 USD. Source : BCE.
Seedance : la plus belle image, mais un problème avec l’audio d’origine
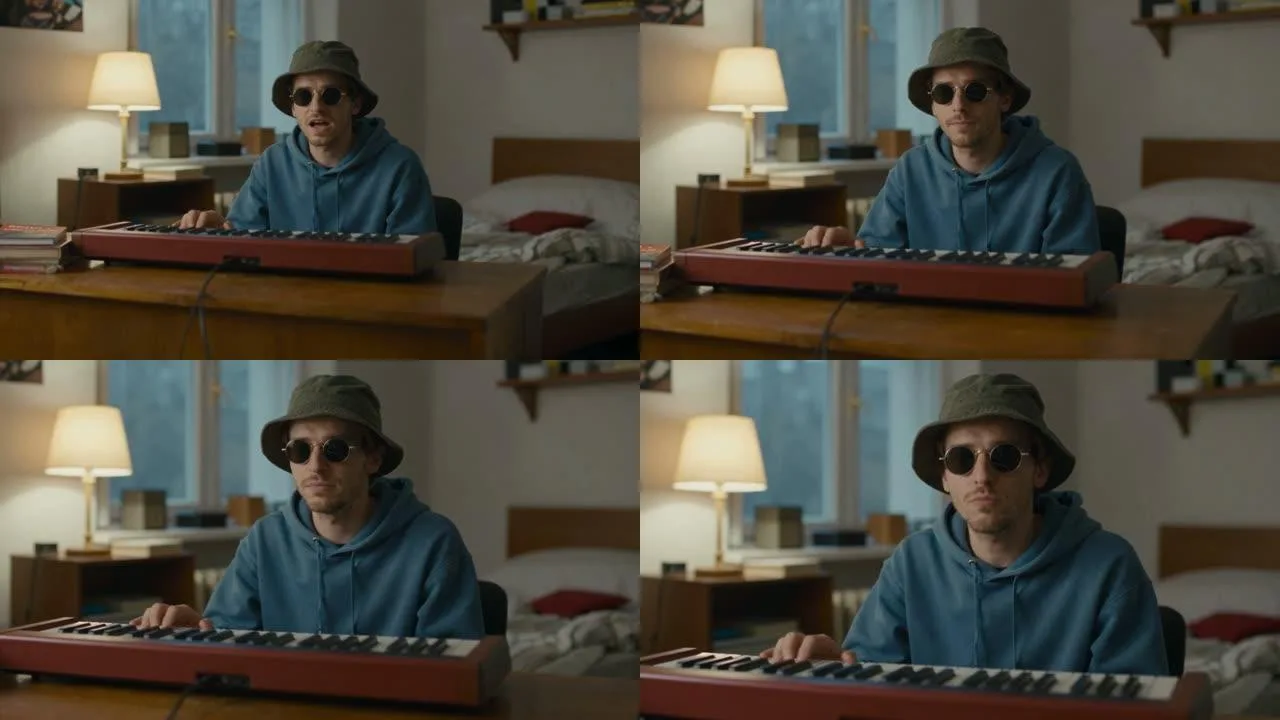
J’ai préféré la lumière, la composition et l’impression générale de plan abouti de Seedance. C’est une appréciation visuelle que je distingue de la mesure de synchronisation. Un beau cadrage peut facilement détourner l’attention des lèvres, surtout quand on le regarde sans la chanson d’origine. Une fois l’image comparée au chant original, l’avantage esthétique ne suffisait plus.
Le modèle a renvoyé sa propre version de la piste audio. Sa corrélation avec l’original était de 0,12. Pour cet extrait, il était nécessaire de remplacer l’audio par l’original, en tenant compte du décalage d’environ 47 ms consigné dans les notes. Je n’appliquerais pas automatiquement ce décalage à d’autres clips. La piste générée par le modèle ne doit pas remplacer le master de la chanson simplement parce qu’elle accompagne l’image.
Wan 3.0 : un playback exploitable, mais 15 s maximum dans ce test
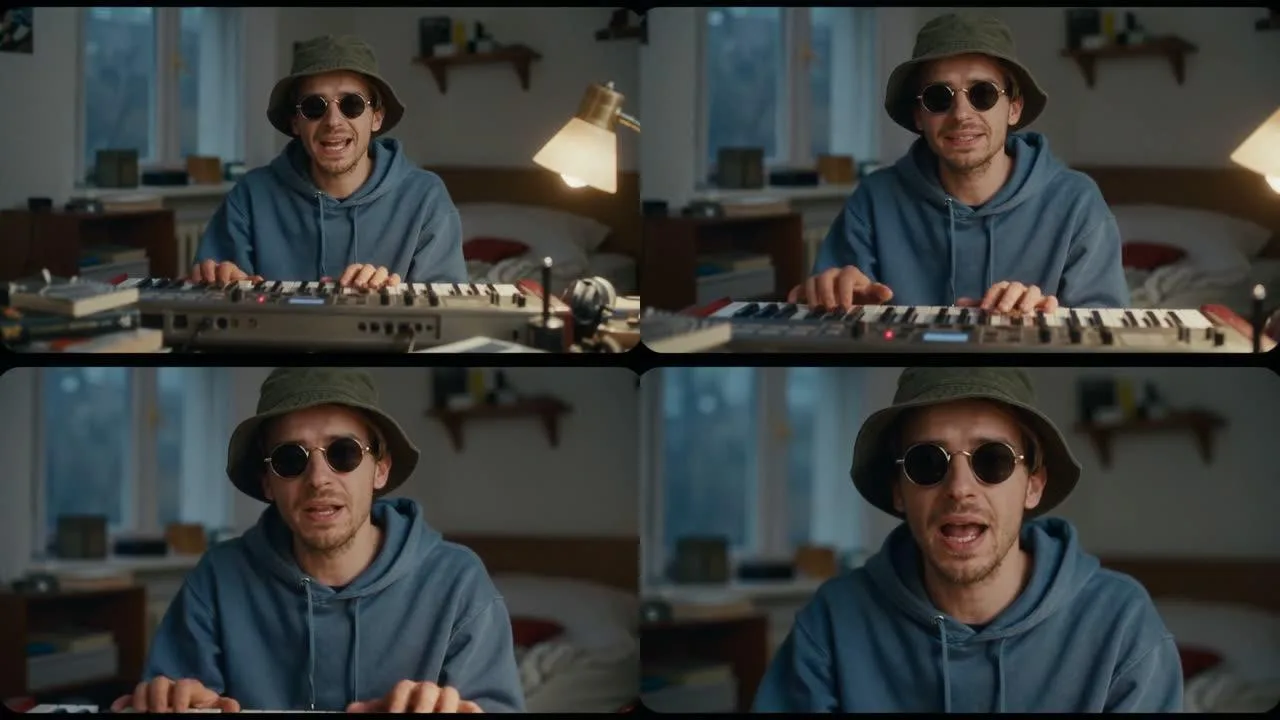
Wan a obtenu une meilleure corrélation que Seedance et coûté moins cher pour ce test. Le principal problème pratique est apparu avant même l’évaluation de l’image : la demande de 20 s s’est soldée par le message generation_failed, sans frais. Seule la durée de 15 s a fonctionné. C’est ce que j’entends ici par limite : une restriction constatée sur le parcours API testé, et non une preuve concernant toutes les intégrations possibles.
Pour préparer un clip musical, je prévoirais donc des segments plus courts et des points de coupe au montage. Je ne partirais pas du principe qu’une phrase plus longue fonctionnera au seul motif que le champ de durée accepte la valeur demandée. Générer l’image avec succès et faire coïncider les limites du clip avec la musique sont deux tâches distinctes, à prendre en compte avant d’envoyer une nouvelle demande.
InfiniteTalk en tête de la mesure, avec une option V2V
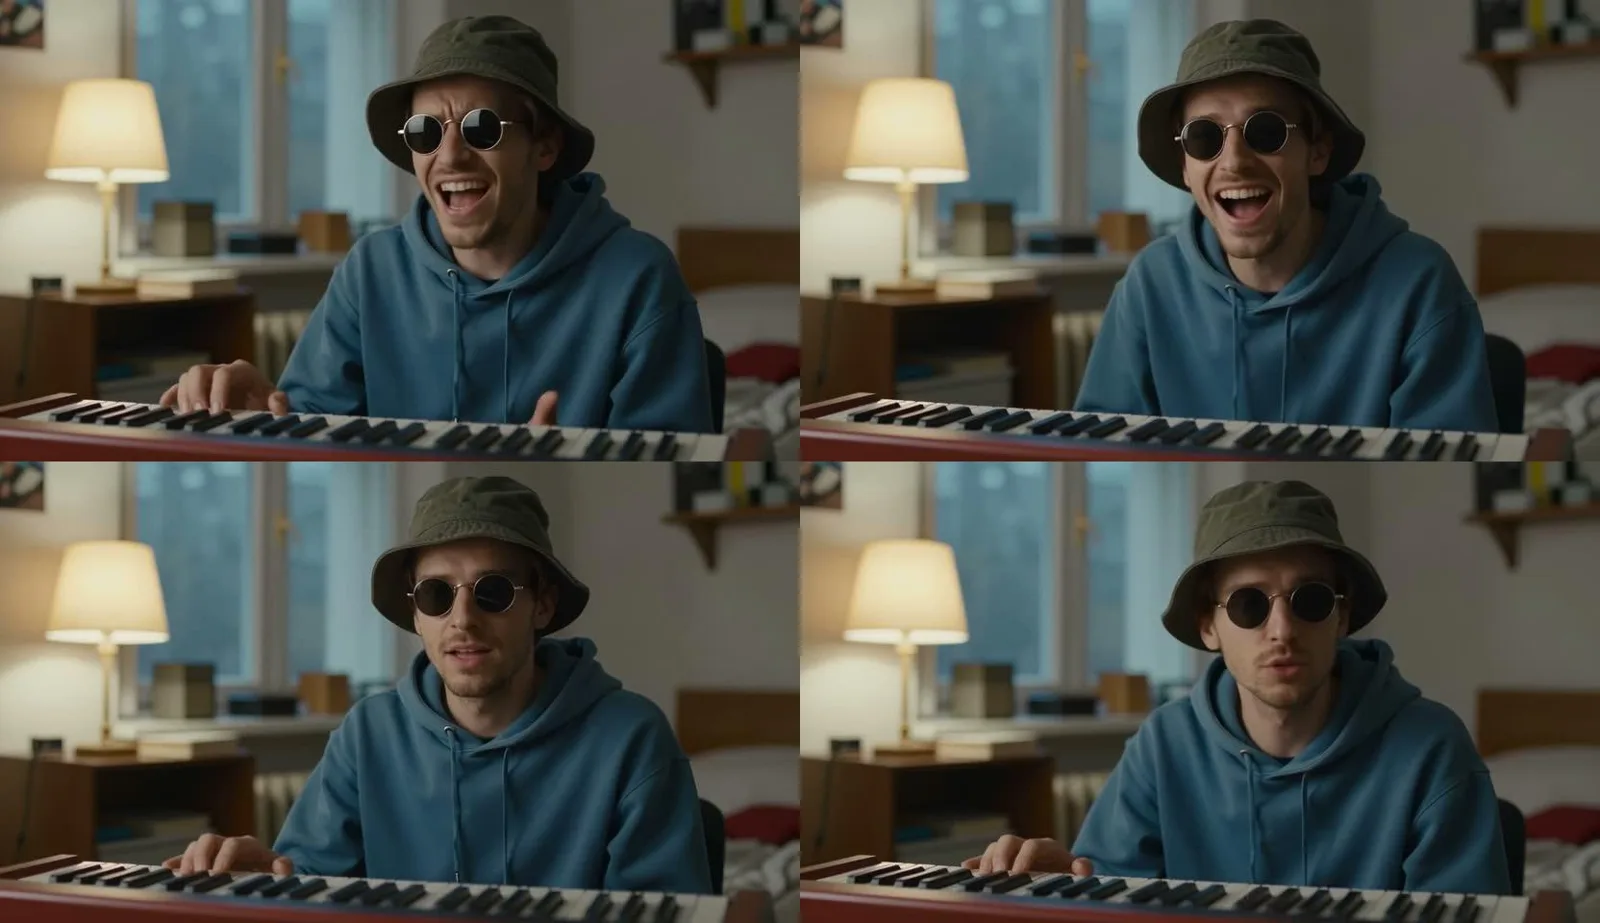
InfiniteTalk en local a obtenu la corrélation la plus élevée sur le segment commun. Sur les 20 secondes complètes, le résultat était de 0,424. La résolution était plus faible et le calcul plus long, mais c’était un meilleur point de départ pour faire chanter un extrait précis. Cela ne signifie pas que chaque mot était articulé sans défaut.
J’ai également testé l’association de Seedance et d’InfiniteTalk en local en mode V2V. Avec 2 étapes sur 4 et une valeur de audio_scale de 1,5, la corrélation est passée de 0,153 à 0,366. La détection des visages était de 77 %, et cette étape supplémentaire a duré 656 s. Le résultat était en 832×480 : améliorer le playback nécessitait donc d’accepter un changement des paramètres d’image.
Cette méthode n’a pas dépassé InfiniteTalk utilisé seul dans la mesure, mais elle permettait de réutiliser l’image générée auparavant via l’API. Un passage ultérieur dans SeedVR2 7B fp8 l’a mise à l’échelle jusqu’à 1872×1080 en 1034 s supplémentaires. Je vois cette étape comme un moyen de finaliser le plan choisi. L’agrandissement ne prouve pas une nouvelle amélioration de la synchronisation.
Questions fréquentes
Quel modèle choisirais-je pour chanter en polonais ?
Sur la base de ce test, je choisirais InfiniteTalk si le playback est la priorité. J’envisagerais Wan pour des plans plus courts et si je voulais un résultat plus rapide. Je garderais Seedance pour les images qui justifient une correction supplémentaire des lèvres.
La meilleure corrélation signifie-t-elle un lip-sync parfait ?
Non. J’ai mesuré le lien entre l’ouverture de la bouche et le volume du chant, pas l’exactitude de chaque son. Le résultat aide à comparer les variantes de ce test, mais ne remplace pas le visionnage du clip avec le mix original.
La génération en local est-elle gratuite ?
Le rapport indique qu’aucuns frais de génération n’ont été facturés. L’électricité, le matériel et le temps de préparation de l’environnement restent à prendre en compte. Sans mesure de la consommation électrique, je ne donne pas de coût total ni ne promets d’économies quel que soit le nombre de clips.
Pour en savoir plus sur les prix et l’accès aux modèles, consultez mes articles sur Seedance et Wan 3.0. Pour préparer les plans d’un clip entier, lisez aussi mon article sur Kling 4.0 pour les clips musicaux.
Sources et date de vérification
Mesures, durées et coûts : relevé du test klipy-ai-test/WYNIKI.md. Configurations : opus-wideo/KLIPY-AI-REPO.md et fiche infinitetalk.md. Les illustrations proviennent du même test. Documentation des projets : InfiniteTalk et WanVideoWrapper. Les conclusions portent sur le contenu et les paramètres décrits.
Vérifié le 21 octobre 2026.
More on this from PROMPTIF