HappyHorse 1.1: 7 tests vidéo avec prompts et avis
7 clips générés avec HappyHorse 1.1: mouvement de caméra, cut, image-to-video et voix. Prompts complets, scores détaillés et limites du modèle testées.
👁 119 lectures
J’ai généré 7 clips avec le modèle HappyHorse 1.1 via OpenRouter, chacun d’une durée de 5 s en 720p pour environ 0,44 EUR (0,494 USD). Trois résultats se sont révélés très concluants (8,5/10): la continuité d’un même personnage après un cut, un dialogue en anglais et l’animation image-to-video avec un mug. En revanche, deux tests ont nettement échoué: un texte sur tableau noir (3/10) et une phrase testée en polonais (4,5/10). Voici chaque clip avec son prompt détaillé et son évaluation. Le comparatif global, les tarifs et l’accès sont détaillés dans le guide HappyHorse 1.1.
En résumé (11 octobre 2026)
- Points forts: mouvements de caméra, constance du personnage, image-to-video, voix anglaise.
- Points faibles: incrustation de texte dans l’image, langues autres que l’anglais, physique des liquides.
- Moyenne sur les 4 scènes de mon comparatif standard (hors voix): 6,1/10. Wan 3.0 avait obtenu 9,1.
- Coût du banc d’essai: environ 3,09 EUR (3,46 USD) pour 7 clips plus environ 0,027 EUR (0,03 USD) pour l’image de départ (taux BCE du 12/10/2026: 1 EUR = 1,1181 USD; source: https://www.ecb.europa.eu/stats/eurofxref/eurofxref-daily.xml).
Protocole de test
Tous les clips ont été générés le 11 octobre 2026 via l’API OpenRouter (alibaba/happyhorse-1.1), en 720p, format 16:9, durée de 5 secondes, avec le même seed 20261008. La génération a pris de 96 à 112 secondes par extrait. Chaque fichier affiche 1280×720 pixels à 24 images par seconde et comprend une piste audio. Les cinq premières scènes reprennent mot pour mot les prompts de mon comparatif vidéo du 8 octobre, permettant une confrontation directe avec six autres modèles. La méthode d’évaluation reste identique: analyse de quatre arrêts sur image (à 8, 35, 62 et 92% du clip) en plus du rendu complet, sur une échelle de 0 à 10. La parole est analysée via faster-whisper large-v3 pour calculer le WER (taux d’erreur de mots).
| Exemple | Usage type | Note | Meilleur score le 08/10 |
|---|---|---|---|
| 1. Orbite autour d’une moto | plans produits, spots publicitaires | 8 | Wan 3.0 et Kling 3.0: 8,5 |
| 2. Voix en langue étrangère (testée en polonais) | dialogue face caméra | 4,5 | MiniMax H3 Max: 9 |
| 3. Texte sur tableau | écrans de titre, enseignes, logos | 3 | Wan 3.0 et H3 Max: 10 |
| 4. Liquide versé jusqu’au débordement | culinaire, boissons | 5 | Wan 3.0: 9 |
| 5. Personnage sur 2 plans raccordés | courts métrages, fictions AI | 8,5 | Wan 3.0: 9 |
| 6. Voix en anglais | vidéos courtes en anglais | 8,5 | scène hors comparatif initial |
| 7. Animation d’image (image-to-video) | animation de visuels e-commerce | 8,5 | scène hors comparatif initial |
La barre pleine correspond à 10 points.
Analyse des 7 clips de test
1. Mouvement d’orbite autour d’une moto
Usage type: vue produit à 180 degrés, plan d’introduction, transition de clip musical.
A smooth 180-degree camera orbit around a vintage red motorcycle parked on a wet cobblestone street in an old European town at blue hour. The camera circles steadily from the front of the motorcycle to its back at a constant speed. Street lamps reflect in the puddles, light drizzle. The motorcycle keeps its exact shape and details. Realistic cinematic footage, real-time motion, no text, no logos.
Traduction du prompt: la caméra tourne de manière fluide à 180 degrés autour d’une moto rouge sur des pavés mouillés à l’heure bleue, les réverbères se reflétant dans les flaques.
Note: 8/10. La trajectoire démarre de trois-quarts avant pour finir de trois-quarts arrière, respectant le demi-tour demandé. La moto conserve sa géométrie et ses détails mécaniques; les flaques et les reflets sont convaincants. Le rendu équivaut à celui de MiniMax H3 Max (8) et talonne Wan 3.0 (8,5). Lors du même test, Seedance 2.5 avait fait apparaître une bâche parasite sur la selle, tandis que Veo 3.1 Lite n’avait presque pas bougé.
2. Dialogue face caméra testé en polonais
Usage type: pastille vidéo avec dialogue face caméra, publicité incarnée.
Medium close-up of a woman in her thirties sitting at a kitchen table, looking straight into the camera. She says clearly and calmly in Polish: "W Szczebrzeszynie chrzaszcz brzmi w trzcinie, a ja place trzydziesci dwa zlote." Natural daylight from a window, static camera, realistic, no subtitles, no on-screen text, no music.
Traduction du prompt: une femme assise à une table de cuisine regarde l’objectif et prononce calmement une phrase en polonais comportant des virelangues et des chiffres.
Note: 4,5/10. L’image est propre, la synchronisation labiale fonctionne et le timbre vocal sonne naturel. Toutefois, le test d’élocution mené en polonais a échoué: la transcription automatique Whisper montre une distorsion sévère avec 6 mots erronés sur 12, soit un taux d’erreur WER de 0,5. Pour comparer, MiniMax H3 Max atteignait un WER de 0 sur la même réplique, Wan 3.0 affichait 0,167 et Seedance 2.5 grimpait à 0,583. Retrouvez plus de mesures dans l’article sur les tests vocaux de HappyHorse 1.1.
3. Écriture à la craie sur tableau
Usage type: cartons de titre, enseignes, intégration typographique dans le décor.
Close-up of a green school chalkboard in a sunlit classroom. A hand finishes writing with white chalk. The chalkboard clearly shows exactly two lines of text in capital letters: first line "ARENA WIDEO 2026", second line "ZOLTA LODZ". Static camera, realistic, chalk dust in the light, no other text.
Traduction du prompt: une main termine d’écrire à la craie sur un tableau vert deux lignes en lettres capitales, avec des caractères diacritiques spécifiques testés dans la version originale.
Note: 3/10. Le mouvement de la main est fluide, l’éclairage et la poussière de craie sont très bien rendus. Le texte, lui, est illisible ou tronqué: une lettre saute sur la première ligne et les caractères accentués ou diacritiques sont remplacés par des glyphes incohérents. Seuls Wan 3.0 et MiniMax H3 Max avaient réussi ce test sans aucune faute d’orthographe. Pour intégrer du texte avec HappyHorse 1.1, ajoutez-le en postproduction.
4. Verre rempli jusqu’au débordement
Usage type: spots publicitaires de boissons, cuisine, simulation de fluides.
Static close-up on a wooden kitchen table in daylight. Water is poured from a glass pitcher into an empty clear drinking glass. The stream splashes, bubbles rise, the water level rises steadily until the glass overflows and water spills onto the table and spreads into a puddle. Real-time speed, no slow motion, realistic physics, no text.
Traduction du prompt: de l’eau est versée d’une carafe dans un verre vide, le niveau monte jusqu’à déborder et former une flaque sur la table.
Note: 5/10. Le jet et les bulles sont visuellement réalistes. Le problème vient de la chronologie physique: la flaque apparaît sur le bois dès la deuxième seconde, alors que le verre est encore à moitié vide. Veo 3.1 Lite avait commis la même erreur d’anticipation (noté 5 également). Wan 3.0 avait obtenu 9 grâce à une montée progressive et un débordement temporellement exact.
5. Continuité d’un personnage sur deux plans coupés
Usage type: fiction, séries générées par IA, publicités scénarisées.
Two shots separated by one hard cut. Shot 1: wide shot of a young woman with short red hair, round black glasses, a yellow raincoat and a black backpack walking along a rainy city street at night with neon reflections on the wet pavement. Hard cut. Shot 2: close-up of the same woman with the same short red hair, the same round black glasses and the same yellow raincoat as she stops under a shop awning and looks up at the rain. Realistic, cinematic, no text.
Traduction du prompt: deux plans avec raccord franc, d’abord une femme en imperméable jaune marchant de nuit sous la pluie, puis un gros plan sur le même personnage sous un store.
Note: 8,5/10. Le raccord s’exécute pile au moment voulu. Après la coupure, les traits du visage, les lunettes rondes, l’imperméable jaune et les sangles du sac à dos restent parfaitement identiques. Seule variation mineure: la chevelure paraît un peu plus longue en gros plan. C’est nettement supérieur à MiniMax H3 Max (7,5, qui avait changé la coupe de cheveux en carré à frange) et à Seedance 2.5 (6, dont la capuche masquait la tête). Seul Wan 3.0 avait fait mieux (9).
6. Voix anglaise face caméra
Usage type: formats courts anglophones, séquences documentaires caméra à l’épaule.
Medium shot of an elderly fisherman with a grey beard sitting on a wooden pier at sunrise, mending a net. He looks up at the camera, smiles and says in English: "The sea gives you exactly what you have patience for." Gentle waves, seagulls in the distance, warm golden light, handheld documentary style, realistic, no subtitles, no text.
Traduction du prompt: un pêcheur âgé à barbe grise répare son filet au lever du soleil sur un ponton, lève les yeux et prononce en anglais une phrase sur la patience et l’océan.
Note: 8,5/10. L’outil Whisper a transcrit la phrase sans la moindre faute (WER 0), et les lèvres s’alignent avec les phonèmes. Petit bémol sur la mise en scène: l’IA a inséré un court insert non demandé sur les mains avant de passer au plan moyen. Le modèle gère donc très bien la parole dès lors qu’il s’agit d’anglais.
7. Animation d’une photo fixe: tasse et café
Usage type: mise en valeur de fiches produits e-commerce, réseaux sociaux, plans d’ambiance.
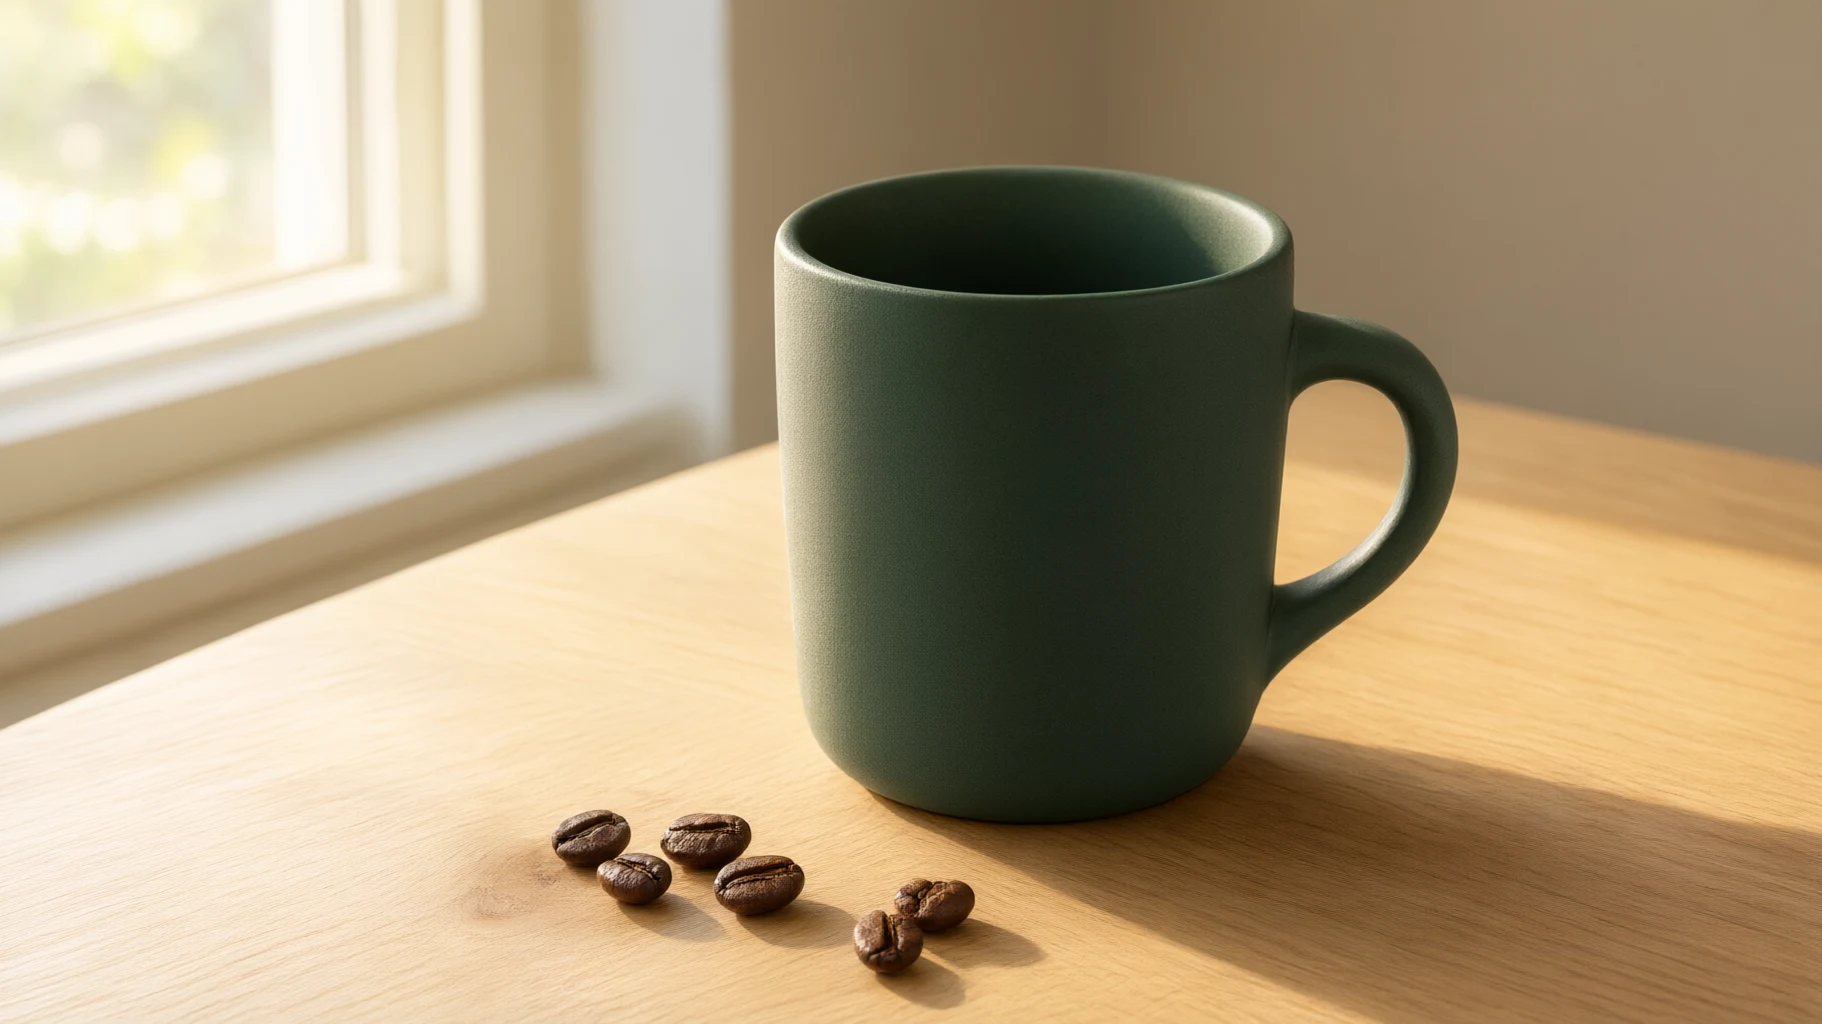
L’image de départ (un mug vert sur une table en chêne) a été conçue au préalable avec le générateur d’images Qwen-Image 3 via OpenRouter pour environ 0,027 EUR (0,03 USD):
Slow camera push-in on the green ceramic mug. Hot black coffee is poured into the mug from above in a thin stream, steam rises and curls in the sunlight, dust particles float in the window light. Sound of pouring coffee and a quiet morning kitchen. Realistic, no text, no logo.
Traduction du prompt: travelling avant lent vers la tasse verte, du café chaud y est versé en filet fin depuis le haut, avec de la vapeur visible dans la lumière et une ambiance sonore de cuisine matinale.
Note: 8,5/10. Le zoom avant est très stable, la tasse conserve la géométrie et la couleur de la photo source, le filet de café est régulier et la vapeur monte naturellement. Seul mouvement prévisible: les grains de café au bord sortent du cadre sous l’effet du travelling optique, ce qui respecte la logique d’un cadrage réel. Ce test illustre bien la supériorité du modèle en mode image-to-video par rapport à la simple génération text-to-video.
Prompts officiels issus de la documentation
Alibaba Cloud ne fournit pas de vidéos brutes téléchargeables accompagnées de leurs prompts complets, se limitant à des extraits animés sans consignes. Les exemples suivants proviennent des guides techniques et supports promotionnels. N’ayant pas généré ces rendus moi-même, je présente uniquement les requêtes.
Ville miniature en carton (documentation officielle text-to-video)
A miniature city built from cardboard and bottle caps comes to life at night. A cardboard train slowly passes through, with small lights dotting the scene and illuminating the way ahead.
Description: une ville miniature faite de carton et de capsules s’anime la nuit, un train en carton avance lentement avec de petites lumières guidant sa route. Source: documentation Alibaba Cloud.
Transition de style en pleine rotation (campagne de présentation)
A girl is dancing gracefully. As she spins around in a full turn, the entire scene seamlessly transforms from a cartoon style into a realistic live-action setting.
Description: une jeune fille danse et tourne sur elle-même; lors de sa rotation complète, l’univers bascule en douceur d’un style dessin animé vers des prises de vues réelles. Source: page de présentation HappyHorse.
Battle de danse entre deux personnages (fal.ai, mode multi-références)
A dance battle between character1 and character2, cinematic lighting, smooth camera movement.
Description: affrontement dansé entre deux protagonistes définis par des visuels d’entrée, lumière cinématographique et mouvement fluide. Les balises character1 et character2 ciblent les images fournies en amont.
Galerie de la communauté
Sur happyhorse.com, plusieurs modèles partagés illustrent les capacités du système: un chiot habillé en abeille filmé sous trois angles distincts, une peluche animée sur 15 secondes avec des actions programmées à la seconde près, ou encore un court métrage d’horreur rétro s’appuyant sur cinq images guides. Ces exemples permettent d’observer l’agencement exact des consignes. Le clip de démonstration officiel «Are You Happy - HappyHorse 1.1 Is Now Available» (2:21, diffusé le 23/06/2026) est visible directement sur la plateforme.
Ce qu’il faut retenir pour vos générations
- Rédigez vos prompts en anglais et conservez des voix anglophones pour éviter les fautes d’élocution.
- Ne comptez pas sur le rendu de texte intégré. Intégrez titres et typographies au montage.
- Partez d’une image fixe quand vous le pouvez: le mode image-to-video offre les rendus les plus nets et constants.
- Découpez vos séquences explicitement via des mentions directives comme «Shot 1», «Hard cut» et «Shot 2». L’algorithme suit très bien ce découpage temporel.
Pour observer comment HappyHorse 1.1 se positionne face à Wan 3.0, Seedance et MiniMax sur ces mêmes séquences, consultez notre comparatif des 4 modèles vidéo. Les autres analyses sont accessibles dans notre comparatif vidéo et notre classement des générateurs vidéo par IA.
Sources et date de vérification
- Clips de test: OpenRouter, modèle alibaba/happyhorse-1.1, 11/10/2026; scores comparatifs issus du protocole de test de l’arène vidéo (08/10/2026)
- Documentation technique Alibaba Cloud (11/10/2026)
- Campagne officielle Alibaba Cloud HappyHorse (11/10/2026)
- happyhorse.com, bibliothèque de modèles utilisateurs (11/10/2026)
More on this from PROMPTIF