LTX-Video en local : test et mesures sur RTX 4090
LTX-Video 13B distilled est le modèle de génération vidéo ouvert le plus rapide exécuté sur mon GPU. Retrouvez les mesures réelles, le workflow ComfyUI pas à pas et le comparatif avec LTX-2.
👁 131 lectures
Le modèle LTX-Video 13B distilled développé par Lightricks est le modèle vidéo ouvert le plus rapide que j’ai exécuté sur ma propre carte graphique : un clip de 5 secondes en 768×512 est généré sur ma RTX 4090 en seulement 18 secondes, et en 37 secondes en 1216×704, le tout en mobilisant environ 16 Go de VRAM. Ce moteur est gratuit et utilisable commercialement si votre entreprise réalise moins de 10 millions USD de chiffre d’affaires annuel. Pour explorer d’autres architectures fonctionnant directement sur votre machine, consultez mon dossier complet sur l’IA locale pour le texte, l’image et la vidéo.
Au 17 octobre 2026
- Modèle testé : LTX-Video 13B 0.9.8 distilled (sorti le 16 juillet 2025), 8 étapes, sans audio. Fichiers fp8 : 15,7 Go pour le modèle et 5,2 Go pour l’encodeur T5, soit 20,9 Go au total.
- Mesures sur RTX 4090 (ComfyUI 0.41) : clip de 5 s en 768×512 en 18-20 s, en 1216×704 en 37 s, premier clip avec chargement disque en 63 s. Pic VRAM global de 15,3 à 16,4 Go.
- Licence LTXV Open Weights : utilisation commerciale autorisée jusqu’à 10 M USD de chiffre d’affaires annuel, sans exclusion de l’Union européenne. Les contenus publiés doivent obligatoirement mentionner une génération par machine.
- Génération LTX-2, 2.3 et 2.5 (2026) : intègrent l’audio natif avec poids ouverts, mais le fichier de base pèse à lui seul 19 à 22 Go, sans compter l’encodeur Gemma.
LTX-Video, LTX-2 et LTX Desktop : comprendre la gamme
Lightricks propose deux familles de modèles ouverts ainsi qu’un outil dédié. Leurs dénominations se ressemblent souvent, mais leurs exigences matérielles diffèrent fortement sur votre configuration matérielle.
| Modèle | Paramètres | Audio | Taille minimale |
|---|---|---|---|
| LTX-Video 0.9.8 2B distilled | 2 milliards | Non | 4,5 Go (fp8) |
| LTX-Video 0.9.8 13B distilled | 13 milliards | Non | 15,7 Go (fp8) |
| LTX-2 (janvier 2026) | 19 milliards | Oui | 20,0 Go (fp4) |
| LTX-2.3 (mars 2026) | 22 milliards | Oui | 21,7 Go (nvfp4) |
| LTX-2.5 (août 2026) | 22 milliards | Oui | 18,7 Go (nvfp4) |
Ces tailles correspondent aux dépôts Lightricks sur Hugging Face vérifiés le 17 octobre 2026. Pour faire fonctionner LTX-Video, il faut ajouter l’encodeur T5 (5,2 Go en fp8). Pour LTX-2 et LTX-2.3, l’encodeur Gemma 3 12B est requis (9,45 Go dans le pack Comfy-Org), tandis que LTX-2.5 réclame Gemma 4 12B (15,4 Go en int8). Le format NVFP4 cible les cartes RTX série 50. De plus, LTX-2.5 exige une connexion Hugging Face et l’acceptation de sa licence avant téléchargement.
La recherche LTX-2 désigne cette seconde génération produisant du contenu audiovisuel complet. Si ComfyUI 0.41 fournit des modèles prêts à l’emploi pour LTX-2, LTX-2.3 et LTX-2.5, je n’ai pas téléchargé ces dizaines de gigaoctets supplémentaires : mes mesures ici portent sur LTX Video local dans sa déclinaison 13B.
L’application LTX Desktop
LTX Desktop constitue la solution logicielle officielle de Lightricks sous licence Apache 2.0 (version 1.3.0 du 9 octobre 2026). Elle orchestre les modèles LTX-2.x sur Windows, Linux et macOS :
- En local, le système charge par défaut LTX 2.5 Fast (LTX 2.3 Fast restant sélectionnable), tandis que LTX 2.5 Pro s’exécute uniquement via leur cloud payant.
- Sous Windows, une carte graphique Nvidia disposant d’au moins 15 Gio de VRAM est imposée, avec 16 Go de RAM (32 Go recommandés) et environ 72 Go d’espace disque disponible pour le kit LTX 2.5 Fast.
- Les poids du 2.5 demandent un compte Hugging Face, et l’application encode initialement le texte via une clé d’API LTX gratuite avant qu’on n’active l’encodeur local dans les réglages.
J’ai installé LTX Desktop dans une version plus ancienne (1.0.5), mais je n’y ai pas exécuté de génération en raison des 72 Go de téléchargements requis. Pour tester le modèle 13B, un environnement ComfyUI classique reste beaucoup plus léger.
Mes mesures sur RTX 4090 pour LTX-Video
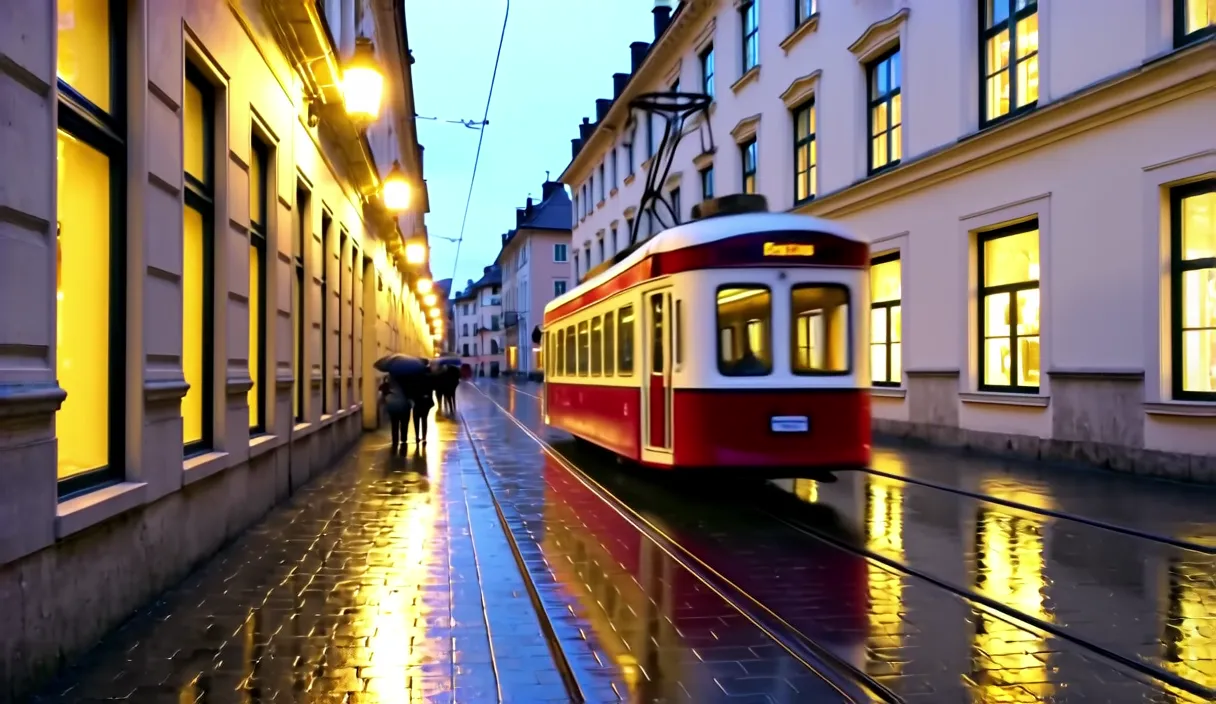
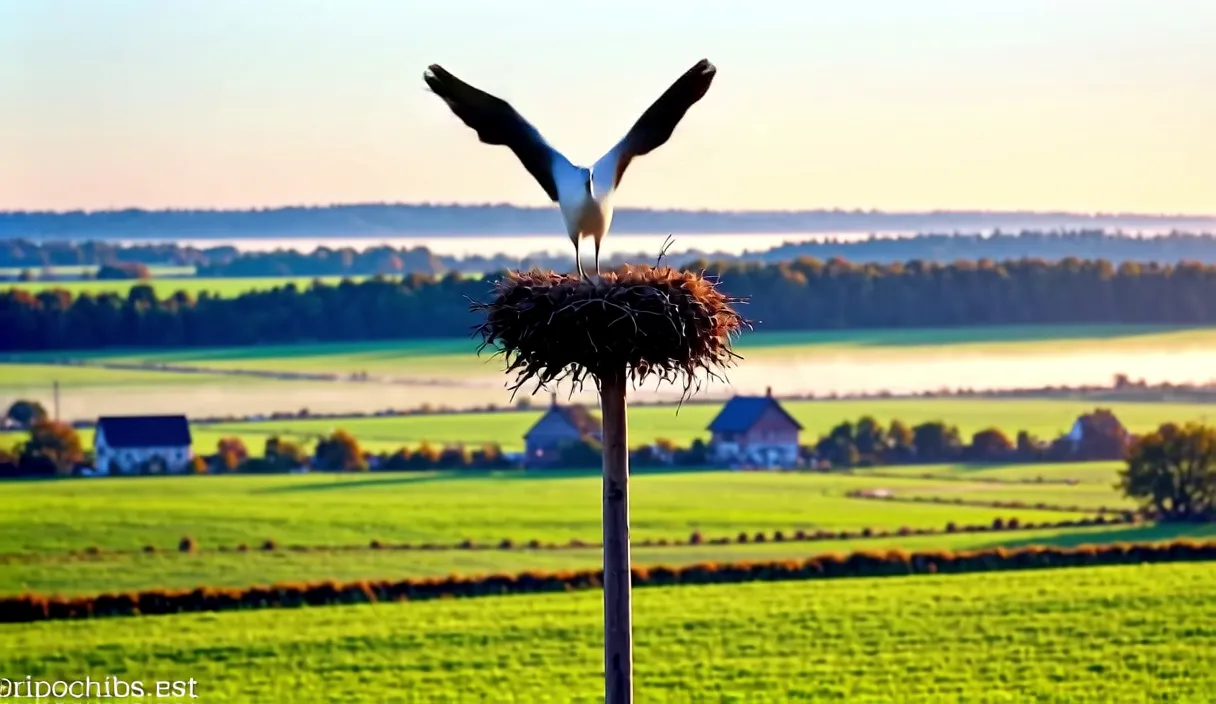
Configuration de test : RTX 4090 24 Go, 64 Go de RAM, processeur i9-14900KF, Windows 11, ComfyUI 0.41.0, modèles stockés sur SSD connecté en USB. J’ai utilisé le fichier ltxv-13b-0.9.8-distilled-fp8 associé à l’encodeur t5xxl fp8. Paramètres retenus : 8 étapes avec le calendrier inscrit dans le modèle, CFG fixé à 1, échantillonneur Euler, 24 images par seconde et décodage VAE par tuiles. Mes invites en anglais ciblaient deux rendus : un tramway sous la pluie dans une vieille ville, puis un atterrissage de cigogne. Le chronomètre démarre à l’envoi de la tâche jusqu’à l’écriture du MP4, et la VRAM indique la crête lue via nvidia-smi toutes les 0,5 seconde.
| Clip 5 s (121 images) | Résolution | Durée totale | VRAM totale |
|---|---|---|---|
| Tramway (premier lancement) | 768×512 | 63,2 s | 15,6 Go |
| Tramway (modèle en cache) | 768×512 | 18,0 s | 15,5 Go |
| Cigogne | 768×512 | 20,2 s | 15,3 Go |
| Cigogne | 1216×704 | 37,1 s | 16,4 Go |
| Tramway | 1216×704 | 36,5 s | 16,4 Go |
La phase d’échantillonnage pur (8 étapes) n’a pris que 8 secondes en 768×512 et 22 secondes en 1216×704. La balance du temps est consommée par l’encodage textuel et le décodage VAE, additionnés lors du premier essai au chargement des 20,9 Go de fichiers depuis le SSD externe. Mon instance ComfyUI tournait avec le drapeau --disable-smart-memory, le système occupant préalablement environ 1,7 Go de VRAM. Pour des besoins textuels couplés à ces scripts, vous pouvez étudier le déploiement d’Open WebUI avec Ollama.
Analyse visuelle des rendus
Le tramway offre un résultat très convaincant : les pavés humides reflètent la lumière des réverbères, les passants portent des parapluies et le véhicule s’éloigne au loin pendant qu’un travelling fluide l’accompagne. En revanche, le panneau indicateur du tramway affiche une bouillie de lettres incohérente, écueil classique de ces algorithmes.
La scène de la cigogne illustre les limites du modèle. Alors que l’instruction spécifiait un atterrissage, l’oiseau se trouve déjà installé sur son nid dès la première image et se contente d’agiter les ailes. L’église demandée en arrière-plan est absente, et un artefact textuel illisible semblable à un filigrane apparaît en bas à gauche de l’écran. Ce comportement montre que la rapidité de LTX impose parfois de multiplier les tirages pour obtenir une mise en scène complexe.
Installation pas à pas de LTX Video local dans ComfyUI
Pour reproduire fidèlement mon protocole de test sans passer par des scripts opaques, procédez étape par étape :
- Installez ou mettez à jour ComfyUI. Si vous êtes sous Windows, lancez l’application avec la variable
PYTHONUTF8=1. - Dans le dépôt
Lightricks/LTX-Videosur Hugging Face, téléchargezltxv-13b-0.9.8-distilled-fp8.safetensors(15,7 Go) dans le dossierComfyUI/models/checkpoints. Si votre carte dispose de 8 à 12 Go de VRAM, téléchargezltxv-2b-0.9.8-distilled-fp8.safetensors(4,5 Go). - Sur le dépôt
comfyanonymous/flux_text_encoders, récupérezt5xxl_fp8_e4m3fn_scaled.safetensors(5,2 Go) et glissez-le dansComfyUI/models/text_encoders. Le VAE se trouve déjà encapsulé au sein du checkpoint principal. - Dans ComfyUI, ouvrez Workflow, puis Browse Templates, et sélectionnez le modèle nommé « LTXV Text to Video ». Dans le nœud Load Checkpoint, sélectionnez la déclinaison 13B distilled, et dans Load CLIP indiquez le fichier t5xxl fp8 avec le type
ltxv. - La variante distillée requiert 8 étapes et un CFG de 1 : remplacez LTXVScheduler par le nœud ManualSigmas relié à SamplerCustom, en renseignant exactement la liste suivante :
1.0, 0.9937, 0.9875, 0.9812, 0.975, 0.9094, 0.725, 0.4219, 0.0 - Définissez des dimensions en multiples de 32, et un nombre d’images suivant la formule 8n+1 (par exemple 121 images correspondent à 5 secondes à 24 i/s). Lightricks préconise de ne pas excéder 1280×720 et de rester sous le seuil des 257 images.
- Rédigez une invite descriptive détaillée en anglais, en précisant les sujets, l’action, l’éclairage et les mouvements d’appareil, car les requêtes laconiques dégradent le rendu.
- Si vous rencontrez une saturation de VRAM au décodage final, permutez le nœud VAE Decode standard avec VAE Decode (Tiled).
Si vous envisagez ensuite d’optimiser d’autres éléments de votre chaîne locale de traitement, notre guide sur la quantification GGUF offre des repères utiles pour maîtriser la mémoire vidéo.
Licences commerciales : les règles de LTX-Video
Depuis la version 0.9.6, LTX-Video relève de la licence LTXV Open Weights, examinée sur leur dépôt officiel le 17 octobre 2026 :
- Elle permet d’exploiter, d’altérer et de redistribuer le modèle librement, y compris pour des projets commerciaux, sous réserve du respect des restrictions d’usage énumérées dans l’annexe A.
- Les entités dépassant 10 millions USD de chiffre d’affaires annuel ont l’obligation de négocier une licence commerciale dédiée sous peine d’indemnités majorées.
- Condition stricte : tout contenu généré et diffusé publiquement doit comporter une mention claire signalant sa création par une machine.
- Cette licence ne comporte aucune restriction géographique, ce qui autorise pleinement son usage sur le territoire européen.
Pour la gamme LTX-2 et 2.3, c’est la LTX-2 Community License qui prévaut, tandis que LTX-2.5 adopte la LTX-2.x Community License. Le plafond des 10 millions USD reste identique. Pour évaluer la rentabilité d’une machine dédiée face aux offres hébergées, lisez notre étude comparative sur le coût réel d’un modèle local face aux API.
Comparatif : LTX-Video face à Wan 2.2 et Kandinsky 6
Pour choisir le moteur adapté à votre flux de travail, plusieurs critères techniques s’opposent selon la nature du projet visé :
- LTX-Video 13B distilled : Idéal pour le prototypage rapide de plans ou la recherche d’ambiance visuelle. Lors de mon test du 3 octobre, les étapes de calcul ont pris 20 secondes, soit environ 6 fois moins que Wan 2.2 5B, mais l’adhérence aux mouvements complexes est moindre.
- Wan 2.2 5B : La référence pour une utilisation commerciale sans contrainte de revenus grâce à la licence Apache 2.0. Un clip de 5 secondes en 1280×704 a demandé environ 4 minutes sur ma RTX 4090, avec une grande stabilité sur les décors statiques.
- Kandinsky 6 : La solution si l’intégration sonore simultanée est indispensable (licence MIT). La version Lite réclame 2 à 2,5 minutes par clip de 5 secondes. Attention toutefois : le décodeur VAE emprunté à HunyuanVideo possède des clauses floues pour l’Union européenne.
Si vous vous intéressez également à la génération vocale ou musicale sur GPU local, parcourez notre comparatif sur les voix IA en TTS ou les tests de l’outil ACE-Step 1.5.
Foire aux questions
Quelle est la différence entre LTX-Video et LTX-2 ?
LTX-Video (versions 0.9.x en 2B ou 13B) génère exclusivement de la vidéo muette à l’aide de l’encodeur de texte T5. La famille LTX-2 regroupe des modèles de 19 à 22 milliards de paramètres capables de synthétiser le flux vidéo et l’audio simultanément grâce à l’encodeur Gemma, ce qui demande une quantité de mémoire vive et vidéo bien plus conséquente.
Combien de mémoire VRAM nécessite LTX-Video en local ?
Sur ma machine, la version 13B en précision fp8 a mobilisé entre 15,3 et 16,4 Go de VRAM totale en résolutions 768×512 et 1216×704. Sur un GPU de 16 Go, l’exécution est très serrée compte tenu des besoins de Windows, tandis que pour une carte de 8 à 12 Go, il est recommandé de se tourner vers la version 2B fp8.
Peut-on exécuter LTX-2 entièrement sur son propre PC ?
Oui, les poids sont disponibles sur Hugging Face et ComfyUI 0.41 propose des modèles préconfigurés. L’éditeur propose également l’application LTX Desktop, mais celle-ci réclame au bas mot 15 Gio de VRAM dédiée, 16 à 32 Go de RAM système et environ 72 Go d’espace disque pour les modèles de base.
Le modèle comprend-il les invites formulées en français ?
L’encodeur T5 a principalement été entraîné sur des banques de données anglophones. Il est nettement préférable de saisir vos descriptions en anglais pour préserver la précision de la mise en scène, car les termes non anglais amènent souvent des contresens ou des artéfacts visuels indésirables.
Quelle est la durée maximale d’un clip avec LTX-Video ?
J’ai mesuré le comportement du modèle sur des clips standards de 5 secondes, soit 121 images. La documentation de Lightricks mentionne un mode étendu pouvant monter jusqu’à 60 secondes sur la version 13B 0.9.8, mais cela demande des extensions spécifiques comme ComfyUI-LTXVideo que je n’ai pas testées ici.
Sources
- Lightricks/LTX-Video sur Hugging Face (fiches techniques et dépôts des versions distillées).
- Licence LTXV Open Weights (conditions d’exploitation commerciale et seuil de chiffre d’affaires).
- Dépôt GitHub Lightricks/LTX-Video (code source et historique des versions).
- Lightricks/LTX-2.5 sur Hugging Face (poids du modèle vidéo et audio).
- Dépôt GitHub LTX Desktop (prérequis matériels et documentation technique v1.3.0).
- Comfy-Org/ltx-2 (encodeur Gemma 3 pour ComfyUI).
- Mesures directes sur configuration RTX 4090 24 Go (Windows 11, ComfyUI 0.41, relevés nvidia-smi).
Vérifié le 17 octobre 2026.
More on this from PROMPTIF

 guides·Higgsfield Canvas, Relight et Angles en 2026 : le guide completAu-delà de la simple génération vidéo, Higgsfield propose des outils de post-production avancés.