InfiniteTalk dans ComfyUI sur RTX 4090 : installation
Installation d’InfiniteTalk dans ComfyUI sur RTX 4090 : modèles fp8, durée de génération, V2V et solutions aux erreurs rencontrées.
👁 116 lectures
J’ai testé InfiniteTalk dans ComfyUI sur une RTX 4090 avec un extrait de chanson polonaise. Le clip local durait 20 s et le calcul a pris 1 284 s, soit plus de 21 minutes. J’ai rencontré des problèmes avec transformers, torchaudio et la fusion des LoRA. Je décris la configuration testée et les fichiers nécessaires pour la reconstituer, en distinguant les paramètres consignés des réglages proposés pour gérer la mémoire.
En bref
J’ai utilisé WanVideoWrapper, le modèle de base Wan 2.1 I2V 14B fp8, InfiniteTalk et lightx2v avec 6 étapes. Le résultat en 832×480 à 25 images/s a obtenu une corrélation de synchronisation labiale de 0,471 sur les 15 premières secondes. Les principaux correctifs de l’environnement concernaient hidden_states dans wav2vec, la compatibilité entre torchaudio et torch, et le réglage merge_loras=False. Cette configuration a fonctionné sur cette carte, sans garantir une durée identique dans un autre environnement.
Que faut-il installer dans ComfyUI ?
J’ai utilisé InfiniteTalk avec ComfyUI-WanVideoWrapper. Cette extension combine le chargement du modèle vidéo, du module InfiniteTalk et des représentations audio. La configuration décrite repose sur Wan 2.1 I2V : je ne remplace donc pas ce modèle par une autre génération de Wan sans vérifier sa compatibilité. Un nom de fabricant commun ne garantit pas que toutes les pondérations et tous les nœuds soient compatibles.
Pour installer l’extension, placez son dépôt dans le répertoire custom_nodes de votre installation ComfyUI. Installez les dépendances de son fichier requirements.txt avec l’interpréteur associé à cette même installation. Évitez d’utiliser un pip système au hasard : un paquet peut être présent sur l’ordinateur sans être accessible à l’application.
Après l’installation de l’extension et le redémarrage de ComfyUI, chargez le workflow InfiniteTalk d’exemple. Vérifiez les nœuds manquants avant de télécharger d’autres checkpoints. L’exemple de la documentation utilise une autre variante de pondérations : avec fp8, choisissez donc soigneusement le loader et les fichiers. Renommer un checkpoint ne le convertit pas.
Modèles fp8 et taille des fichiers
Voici la configuration décrite dans la fiche de l’outil. Les tailles proviennent des métadonnées enregistrées sur Hugging Face et ne correspondent pas à une mesure de la charge sur la carte graphique. Les Go sont décimaux. Je n’additionne pas ces valeurs pour estimer la mémoire vidéo nécessaire : l’offload, les tampons et l’ordre d’exécution des nœuds modifient l’utilisation de la mémoire pendant le traitement.
| Rôle | Fichier | Taille |
|---|---|---|
| Modèle vidéo de base | Wan2_1-I2V-14B-480p_fp8_e4m3fn_scaled_KJ.safetensors |
16,643 Go |
| Module InfiniteTalk | Wan2_1-InfiniteTalk-Single_fp8_e4m3fn_scaled_KJ.safetensors |
2,714 Go |
| Encodeur de texte | umt5-xxl-enc-fp8_e4m3fn.safetensors |
6,731 Go |
| VAE | Wan2_1_VAE_bf16.safetensors |
0,254 Go |
| Encodeur audio | wav2vec2-chinese-base_fp16.safetensors |
0,190 Go |
| CLIP Vision | clip_vision_h.safetensors |
1,264 Go |
Placez le modèle de base et le module InfiniteTalk dans models\diffusion_models, l’encodeur de texte dans models\text_encoders, le VAE dans models\vae et CLIP Vision dans models\clip_vision. Placez wav2vec selon les indications du loader audio. Ne le rangez pas avec l’encodeur de texte sous prétexte que les deux composants traitent des données d’entrée.
Dans le workflow, vérifiez la présence de WanVideoModelLoader, MultiTalkModelLoader, Wav2VecModelLoader, MultiTalkWav2VecEmbeds, WanVideoImageToVideoMultiTalk, WanVideoSampler et WanVideoVAELoader. Le checkpoint complet de la voie native InfiniteTalk ne remplace pas automatiquement le petit module chargé par MultiTalkModelLoader. Vérifiez les différences de format avant de lancer le graphe.
Lightx2v, voix chantée et durée sur RTX 4090
Lors de l’essai consigné, j’ai utilisé lightx2v avec 6 étapes. Ce nombre n’est pas un réglage universel pour le modèle Wan de base sans autre module. L’échantillonnage réduit doit être envisagé avec l’extension et la configuration adaptées. Le compte rendu ne donne pas le nom complet du fichier LoRA utilisé : je ne présente donc pas un checkpoint précis comme un élément certain de la configuration.
Pour la comparaison, j’ai choisi un extrait de la chanson polonaise « Kiedy po swojemu gram », entre 14,5 et 34,5 s. Lors de la préparation, veillez à faire commencer l’image et la voix au même instant, puis combinez le clip final avec le mixage original. Une voix isolée facilite le contrôle des expressions du visage ; elle ne doit pas remplacer par inadvertance la chanson complète dans le résultat final.
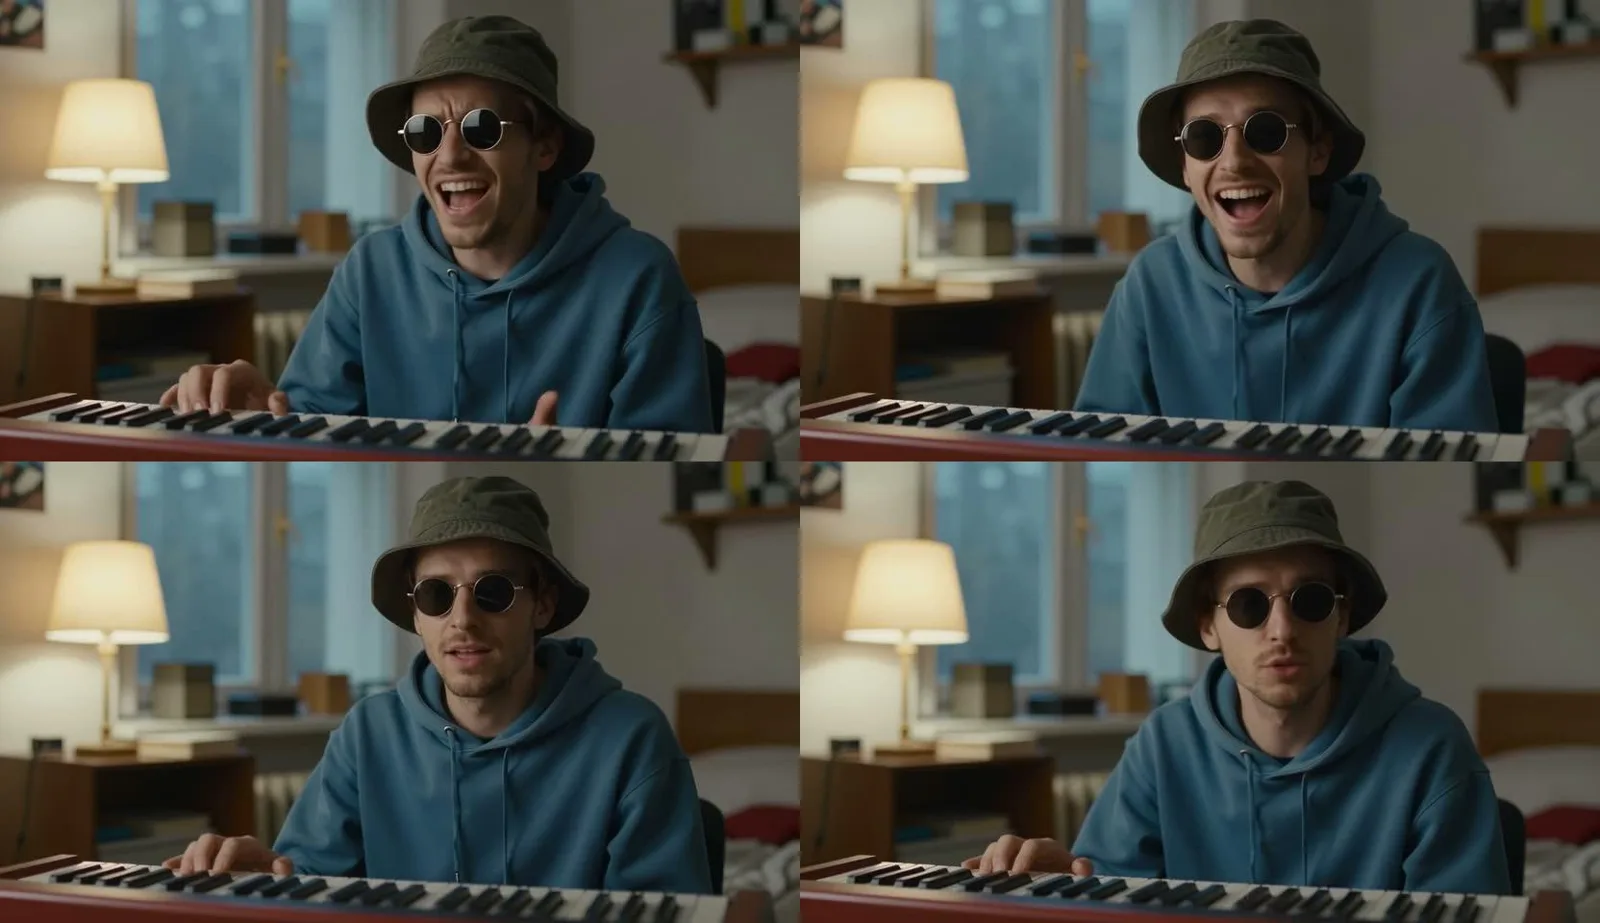
Les 1 284 s correspondent à un clip de 20 s. La corrélation entre l’ouverture de la bouche et le volume de la voix chantée était de 0,471 sur les 15 premières secondes communes et de 0,424 sur l’extrait complet. Un visage a été détecté dans 100 % des cas. Cette mesure utilise MediaPipe et une voix isolée avec demucs ; elle n’évalue pas la prononciation de tous les sons de la chanson polonaise.
La fiche de l’outil propose l’offload de l’encodeur de texte, le block swap et le décodage VAE séparé. Je les considère comme des pistes de gestion de la mémoire, car le compte rendu ne conserve ni préréglage complet ni pic d’utilisation de la mémoire vidéo. Le fait que la configuration ait fonctionné sur une RTX 4090 ne permet pas de garantir que toute durée, résolution ou graphe tiendra aussi facilement.
Transformers 5.x : correctif pour hidden_states
Avec transformers 5.17, le wrapper nécessitait un correctif lié à la prise en charge de hidden_states par le composant wav2vec. Le compte rendu du test conserve le nom de la copie originale : nodes.py.orig-2110. C’est un indice utile pour diagnostiquer un environnement qui charge les modèles, mais s’arrête au traitement audio. Le problème concernait l’interaction entre les bibliothèques, pas les paroles de la chanson polonaise.
La note ne contient pas le diff de ce correctif. Je ne donne donc ni extrait de code inventé ni numéros de ligne à modifier. Pour reproduire cette configuration, il faut disposer du correctif enregistré ou d’une version compatible du wrapper et de transformers. « Tout mettre à jour » ne décrit pas la réparation que j’ai confirmée pendant le test.
Torchaudio, merge_loras et lancement sous Windows
Dans l’environnement fonctionnel, j’ai utilisé torchaudio nightly 2.11 avec torch 2.14 cu132. Ces versions décrivent l’environnement testé ; elles ne constituent pas une recommandation de mise à jour systématique. En cas de problème d’import audio, vérifiez l’interpréteur, la version de torch et le paquet torchaudio correspondant avant de modifier les pondérations du modèle.
La fusion des LoRA a également posé problème. Elle provoquait une access violation sous Windows : j’ai donc utilisé merge_loras=False. La distinction est importante : j’ai désactivé la fusion, pas la LoRA elle-même. Supprimer l’extension tout en conservant l’échantillonnage court modifierait la configuration dont je présente le résultat.
J’ai lancé ComfyUI avec PYTHONUTF8=1. Pour reproduire l’environnement, définissez cette variable avant de démarrer le processus. Notez également les versions des paquets et conservez le workflow fonctionnel : après une modification des dépendances, il peut être difficile de savoir si le problème vient de l’audio, du chargement du modèle ou de l’exécution de l’échantillonneur.
V2V : retoucher la bouche sur un clip existant
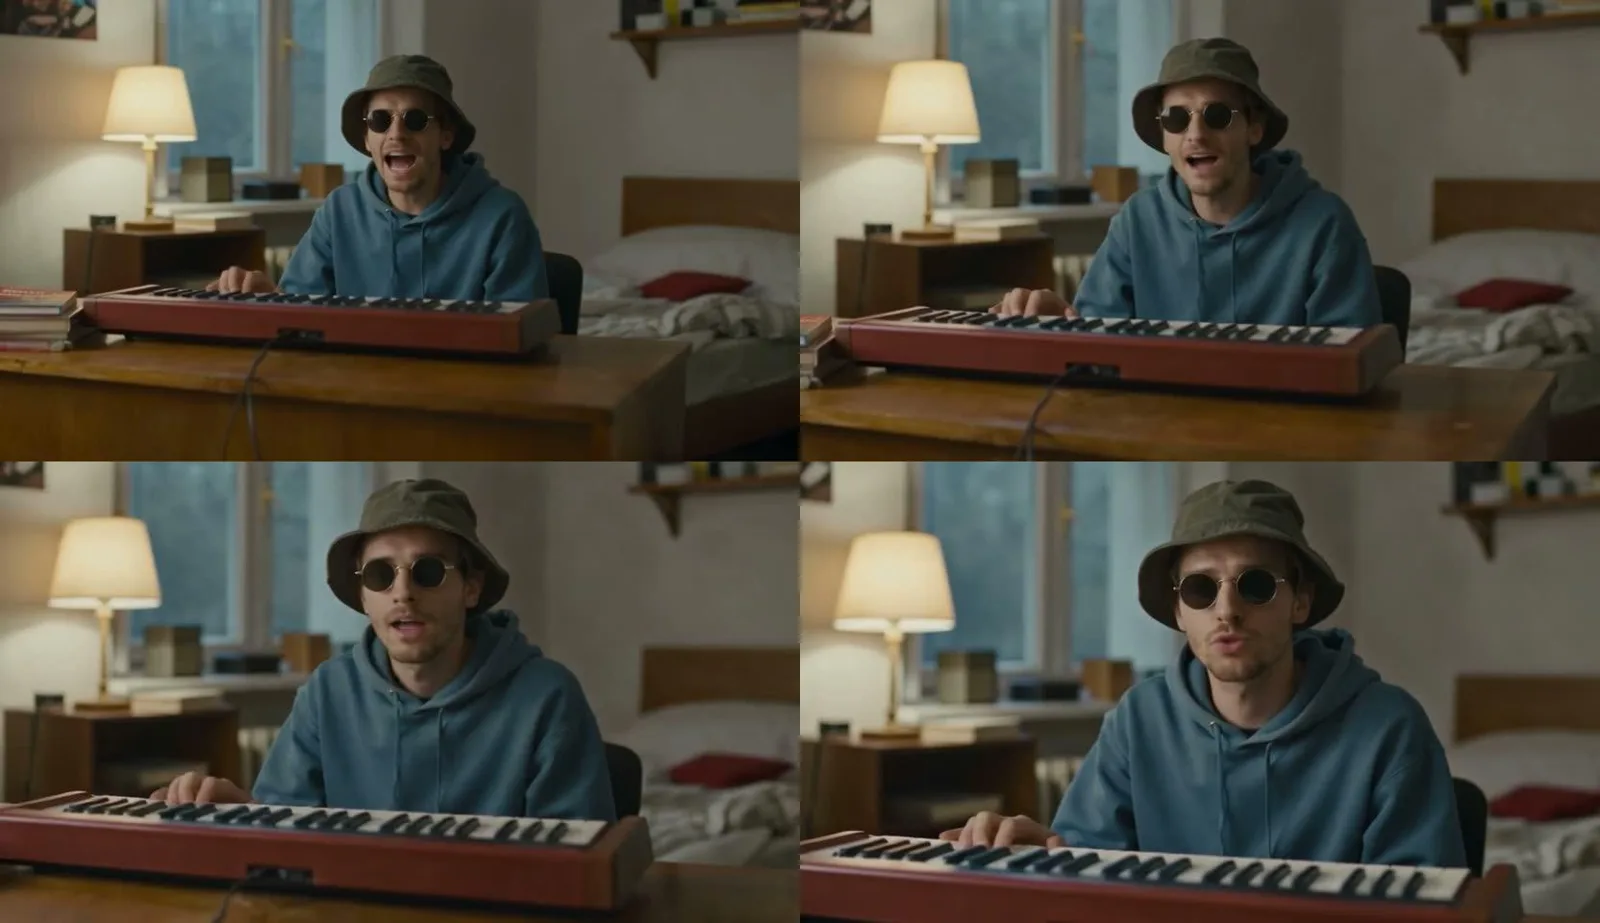
J’ai aussi testé le V2V sur un clip créé avec Seedance 2.5. Avec 2 étapes sur 4 et un audio_scale de 1,5, cette étape a pris 656 s supplémentaires. La corrélation est passée de 0,153 à 0,366 et le visage a été détecté dans 77 % des cas. Le résultat était en 832×480. Il s’agit d’une configuration distincte : je ne mélange pas ses réglages avec ceux de l’essai initial utilisant lightx2v.
InfiniteTalk V2V peut modifier les expressions et les mouvements, et pas seulement la zone de la bouche. Après le traitement, comparez donc aussi l’identité du personnage et le caractère de sa prestation. Une meilleure mesure de synchronisation ne suffit pas si des éléments de l’image qui motivaient le choix du clip d’origine disparaissent. Conserver la version d’entrée facilite cette comparaison.
Licences des composants
Dans la documentation source, InfiniteTalk, WanVideoWrapper et le modèle de base Wan 2.1 sont sous licence Apache-2.0. L’encodeur TencentGameMate et la conversion Kijai indiquée sont sous licence MIT, tandis que ComfyUI est présenté sous GPL-3.0. Vérifiez séparément les conditions applicables au code, aux pondérations et aux extensions. La licence du wrapper ne couvre pas automatiquement chaque modèle chargé.
Le dépôt LightX2V est indiqué sous Apache-2.0, mais l’absence du nom complet de la LoRA utilisée empêche d’identifier le fichier précis. Le séparateur vocal supplémentaire doit lui aussi faire l’objet d’une vérification distincte. Je n’applique pas non plus à l’encodeur wav2vec les restrictions de la famille Hunyuan au seul motif que le nom Tencent apparaît.
Questions fréquentes
InfiniteTalk fonctionne-t-il avec une chanson polonaise ?
J’ai obtenu un résultat exploitable lors de l’essai décrit. J’ai testé un extrait précis : je ne généralise pas ce résultat à toutes les voix, tous les tempos ou toutes les articulations.
Les 21 minutes comprennent-elles l’installation ?
Non. Les 1 284 s consignées correspondent au calcul du clip. Le rapport ne donne pas de mesure distincte pour le téléchargement des pondérations, la préparation de l’environnement ou le diagnostic des erreurs.
Puis-je copier le correctif transformers ?
Le compte rendu partagé ne contient pas son code, mais indique la zone concernée et le nom de la copie originale. Pour reproduire fidèlement la configuration, il faut le diff approprié, pas un remplacement de fichier au hasard.
Si vous débutez, consultez d’abord ComfyUI : installation sous Windows et Wan 2.2 en local. Pour en savoir plus sur les modèles exécutés sur votre propre carte graphique, lisez le guide IA locale.
Sources et date de vérification
- Mesures et erreurs : mon test sur RTX 4090, 21.10.2026
- InfiniteTalk - dépôt et licence
- Pondérations fp8 de Kijai (Hugging Face)
- Workflow du wrapper indiqué plus haut dans l’article
Les données correspondent à l’état consigné pendant l’essai.
Vérifié le 21 octobre 2026.
More on this from PROMPTIF

 actualités·J’ai testé Kling 4.0 sur 10 clipsDix vidéos pour examiner la parole polonaise, les mouvements et la continuité. Les références fonctionnent bien, mais certains accessoires restent indésirables.