Qwen-Image-2.1 : classement complet de 29 modèles d’images IA
Le fabricant a publié un graphique comparant 29 modèles d'images IA. Nous avons extrait les chiffres et les avons croisés avec la taille des modèles.
👁 119 lectures
Le fabricant de Qwen-Image-2.1 a publié lors du lancement un graphique comparant 29 modèles d’images IA - ouverts et fermés. Personne ne l’a présenté sous forme de tableau, nous avons donc extrait les chiffres du graphique et les avons croisés avec la taille des modèles. Le résultat est plus intéressant que la simple position au classement.
Verdict en un paragraphe
Qwen-Image-2.1 occupe la septième place avec un score de 60,28 points dans le classement Qwen-Image-Bench. Devant lui se trouvent uniquement des modèles fermés dont les fabricants ne révèlent pas la taille. Ce qui se passe derrière lui est plus intéressant : il devance Nano Banana 2.0, GPT Image 1.5, Seedream 5 Pro et Nano Banana Pro, ainsi que FLUX 2 Max, qui est quatre fois plus grand, et Hunyuan Image 3.0 - onze fois plus grand. C’est un modèle de 7 milliards de paramètres qui bat un modèle de quatre-vingts milliards de plus de neuf points.
Classement complet Qwen-Image-Bench
Chiffres extraits du graphique publié par le fabricant. La colonne taille est vide lorsque le fabricant du modèle ne la révèle pas - sur le graphique, cela était indiqué par un cadenas.
| # | Modèle | Score | Taille |
|---|---|---|---|
| 1 | GPT Image 2.5 Sunburst | 67,01 | non révélée |
| 2 | GPT Image 2 | 64,69 | non révélée |
| 3 | Grok Imagine 2.0 | 63,47 | non révélée |
| 4 | Qwen Image 3 Pro | 62,36 | non révélée |
| 5 | Muse Image | 62,34 | non révélée |
| 6 | MAI Image 2.5 Pro | 61,02 | non révélée |
| 7 | Qwen-Image-2.1 | 60,28 | 7B |
| 8 | Nano Banana 2.0 | 59,82 | non révélée |
| 9 | GPT Image 1.5 | 59,65 | non révélée |
| 10 | Seedream 5 Pro | 59,53 | non révélée |
| 11 | Nano Banana Pro | 59,45 | non révélée |
| 12 | Grok Imagine Quality | 58,47 | non révélée |
| 13 | Qwen Image 2.0 Pro | 57,84 | non révélée |
| 14 | Seedream 5.0 | 57,22 | non révélée |
| 15 | Seedream 4.5 | 56,78 | non révélée |
| 16 | Seedream 4.0 | 56,21 | non révélée |
| 17 | FLUX 2 Max | 55,33 | 32B |
| 18 | FLUX 2 Pro | 54,57 | 32B |
| 19 | GPT Image 1 | 54,07 | non révélée |
| 20 | Qwen Image 2512 | 52,06 | 20B |
| 21 | Imagen 4.0 Ultra | 51,99 | non révélée |
| 22 | Boogu | 51,40 | 10B |
| 23 | Hunyuan Image 3.0 | 50,81 | 80B |
| 24 | Imagen 4.0 | 50,29 | non révélée |
| 25 | Qwen Image | 49,23 | 20B |
| 26 | Kling Image 2.1 | 48,26 | non révélée |
| 27 | GLM Image | 48,19 | 16B |
| 28 | LongCat | 46,34 | 6B |
| 29 | HiDream O1 | 46,17 | environ 8B |
Réserve qu’il faut poser clairement : il s’agit d’un benchmark publié par le fabricant de l’un des modèles évalués. Traitez-le comme un document du fabricant, car c’en est un. Cela ne signifie pas que les chiffres sont inventés - cela signifie que l’ensemble des tâches et la méthode de notation ont été choisis par une partie intéressée au résultat.
Trois observations visibles uniquement après croisement avec la taille
1. Bond au sein de la propre famille
| Version | Taille | Score |
|---|---|---|
| Qwen Image | 20B | 49,23 |
| Qwen Image 2512 | 20B | 52,06 |
| Qwen-Image-2.1 | 7B | 60,28 |
Un modèle presque trois fois plus petit obtient 8,22 points de plus que son prédécesseur direct. Ce n’est pas une simple mise à jour, mais une architecture différente - couches à flux unique, attention à granularité mixte et réutilisation du cache.
2. La taille a cessé d’être un laissez-passer pour le sommet
Hunyuan Image 3.0 possède 80 milliards de paramètres et un score de 50,81. Qwen-Image-2.1 en a 7 milliards et 60,28. La différence représente onze fois la taille en faveur du perdant.
Conséquence pratique pour quelqu’un qui compte le matériel : le modèle qui donne un meilleur résultat tient sur une seule carte grand public, tandis que le plus grand nécessite une salle serveur. Ceci est une opinion : pour la plupart des applications, cela clôt la discussion sur lequel choisir.
3. Les modèles fermés mènent toujours, mais l’avance a fondu
Il manque 6,73 points au leader, 3,19 à la troisième place. Un modèle ouvert qui peut être exécuté à domicile est aujourd’hui à cinq points du sommet, et non à vingt. Derrière lui restent cependant des modèles pour lesquels on paie à chaque image.
Ce que le modèle a reçu dans cette version
Le fabricant énumère quatre changements :
- Architecture compacte - 32 couches DiT, attention à granularité mixte, réutilisation du cache de clés et valeurs pour plusieurs images d’entrée.
- Transparence native - possibilité de spécifier dans l’invite que l’image doit avoir un canal alpha, et découpage d’objets de photos en tant que calques. Nous l’avons vérifié par mesure.
- Édition - jusqu’à dix images de référence, indication de la zone d’édition par cercle, masquage ou masque, préservation de l’identité des personnes et de l’apparence des produits.
- Textures et typographie - meilleure lumière sur les portraits et disposition des textes tenant compte de la police et de la composition.
En plus, panoramas à partir d’une seule photo, infographies et storyboards à partir d’une feuille de personnages.
Comment nous l’avons vérifié de notre côté
Nous avons installé le modèle localement sur RTX 4090 et lancé six tests. Deux conclusions qui ne figurent pas dans les documents du fabricant :
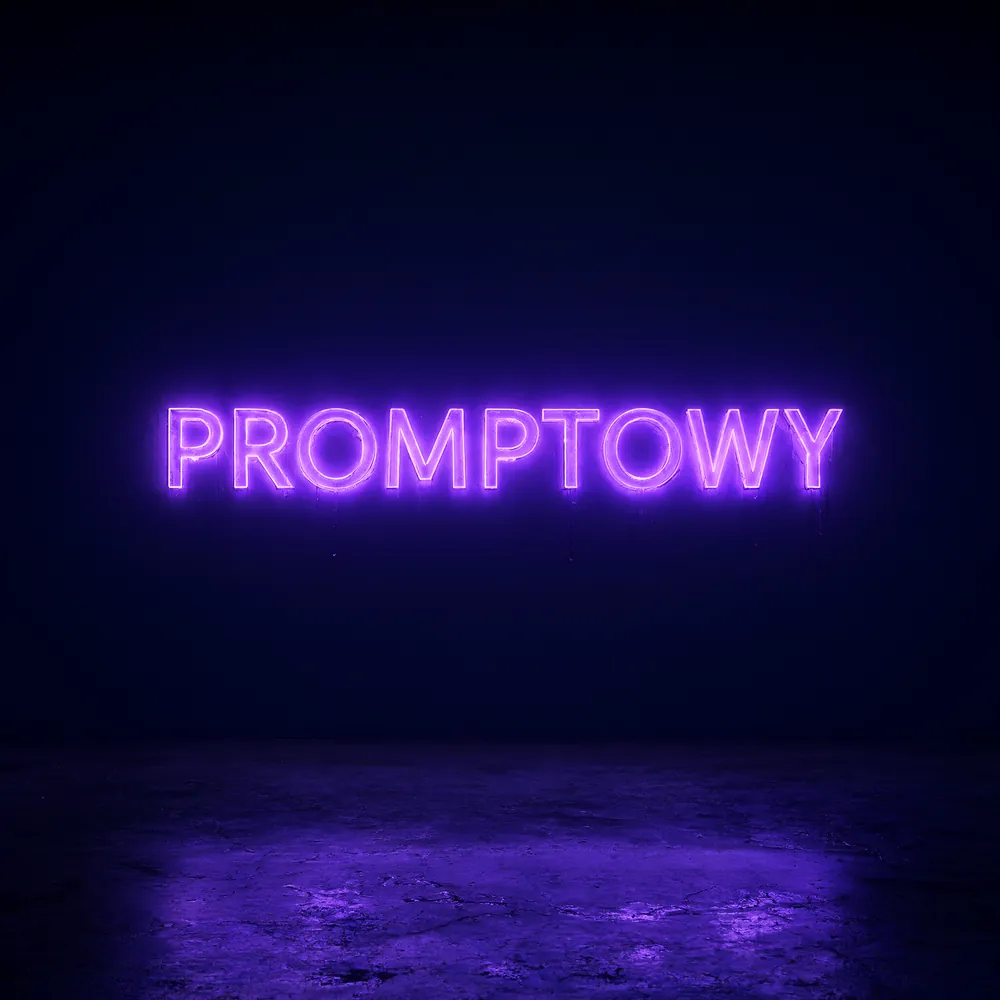
Néon avec le texte [MARQUE] généré localement en résolution 2048×2048 - le texte est sorti sans erreur du premier coup.
- Les textes sont effectivement corrects. Le néon avec le texte [MARQUE] en 2048×2048 est sorti sans erreur du premier coup.
- Les instructions concernant l’âge des personnages sont parfois ignorées. Une demande de portrait de femme dans la trentaine a donné une personne visiblement plus âgée - techniquement excellente, mais non conforme à l’instruction.
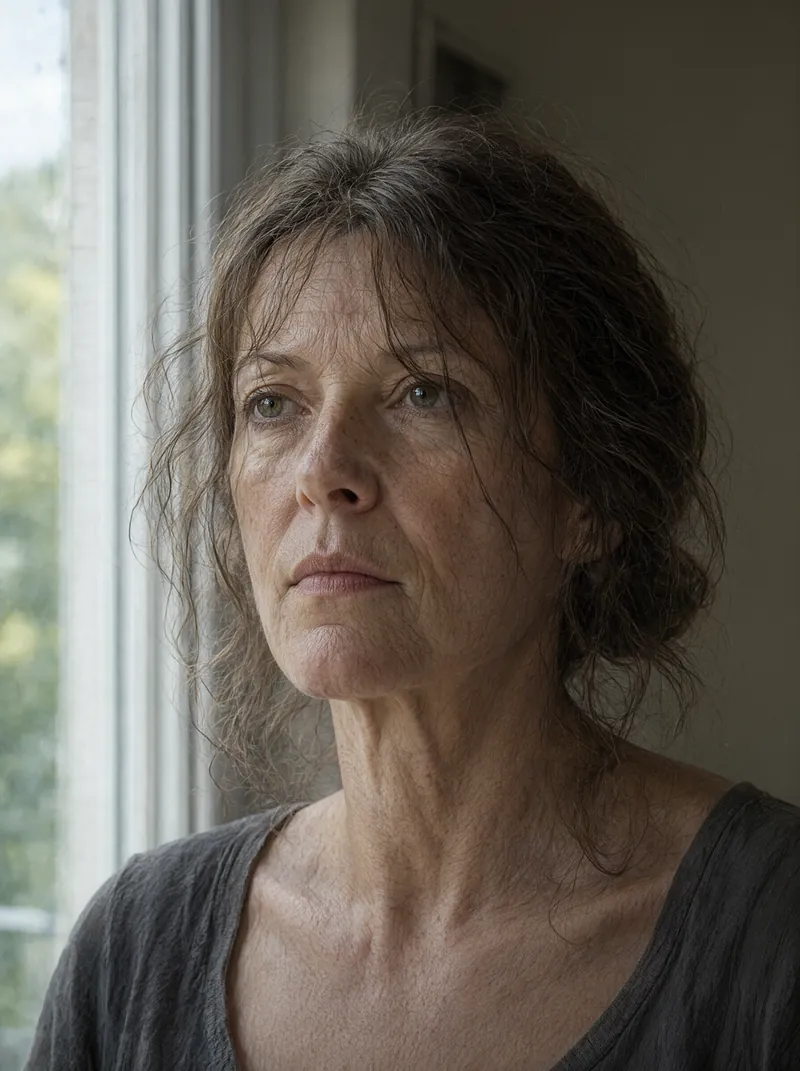
Portrait d’après une instruction pour une femme dans la trentaine. Texture de peau et lumière irréprochables, âge du personnage nettement supérieur à celui demandé.
Les temps, paramètres et script prêt à l’emploi sont dans les instructions d’installation, et nous avons tout rassemblé dans le guide du modèle.
À quoi ressemblent les résultats en pratique
Le classement est un seul chiffre. Ci-dessous trois images de trois catégories différentes, pour voir ce qui se cache derrière ce chiffre.
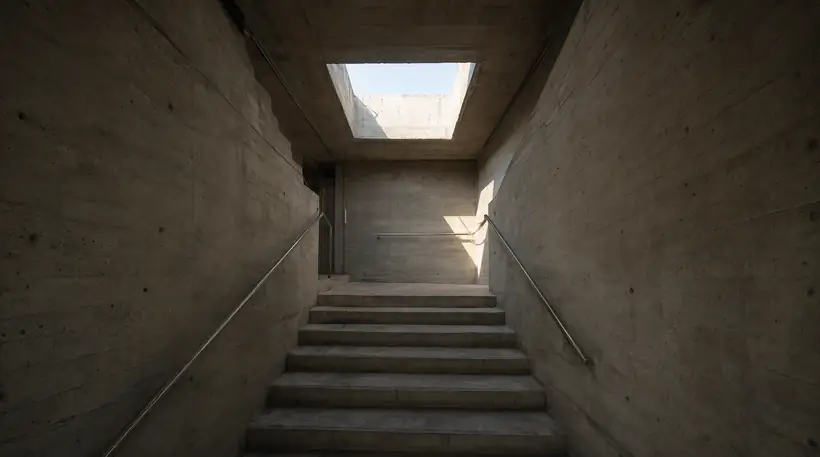
Architecture - catégorie dans laquelle le modèle excelle le plus.
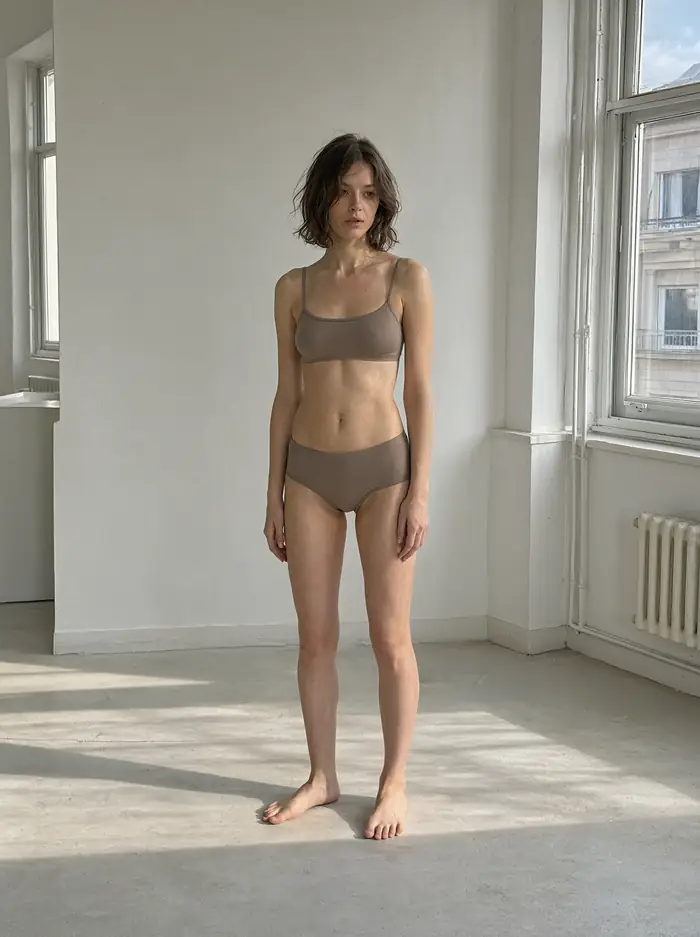
Lumière naturelle - le modèle renonce à l’aspect publicitaire au profit du reportage.
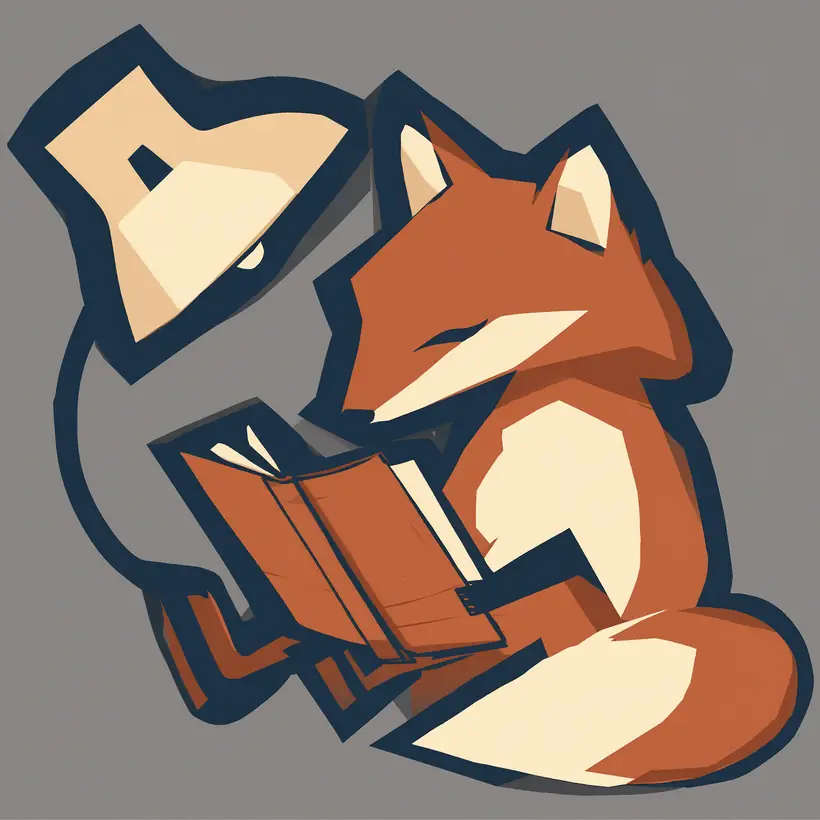
Illustration vectorielle - correcte, mais générique. On voit ici la limite.
Questions fréquentes
Quel est le score de Qwen-Image-2.1 dans le benchmark ?
60,28 points dans Qwen-Image-Bench, septième place parmi 29 modèles comparés.
Est-ce le meilleur modèle d’images ouvert ?
Dans ce classement oui - il devance FLUX 2 Max (55,33), Hunyuan Image 3.0 (50,81) et GLM Image (48,19). Rappelez-vous que le classement provient du fabricant.
Combien de paramètres possède-t-il ?
7 milliards dans la partie générant l’image, en 32 couches DiT à flux unique.
Quel modèle remporte le classement ?
GPT Image 2.5 Sunburst avec un score de 67,01, devant GPT Image 2 (64,69) et Grok Imagine 2.0 (63,47).
Est-il meilleur que Nano Banana ?
Selon ce classement oui : 60,28 contre 59,82 pour Nano Banana 2.0 et 59,45 pour Nano Banana Pro. La différence est cependant faible.
Sources et date de vérification
- Résultats extraits le 22 septembre 2026 du graphique Qwen-Image-Bench publié dans l’annonce de lancement sur qwen.ai
- description de l’architecture et des fonctions du même annonce ainsi que de la fiche du modèle Qwen/Qwen-Image-2.1. Le fabricant a fourni ces données sous forme de graphique
- pas de tableau - les chiffres dans le tableau ci-dessus sont une extraction de la rédaction de ce graphique. Les observations sur les textes et l’âge des personnages proviennent de nos propres tests sur RTX 4090
More on this from PROMPTIF



 benchmarks·Qwen-Image-2.1 : test des poids officiels sans modérationLes versions « sans censure » changent les données d'entraînement, pas le filtre. Nous avons testé les poids officiels : aucun refus sur des visuels commerciaux.