GPT-6 Astra vs Claude : 56% de tokens en plus pour le polonais
Un même texte polonais consomme 2466 tokens chez GPT-6 Astra, mais 3859 chez Claude Fable 5.1. Mesure sur huit modèles et impact sur vos coûts API.
Mise à jour (9 novembre 2026) : Claude Fable 5.2 et Mythos 5.2 sont sortis - prix, accès et benchmarks dans mon guide Claude Fable 5.2.
👁 119 lectures
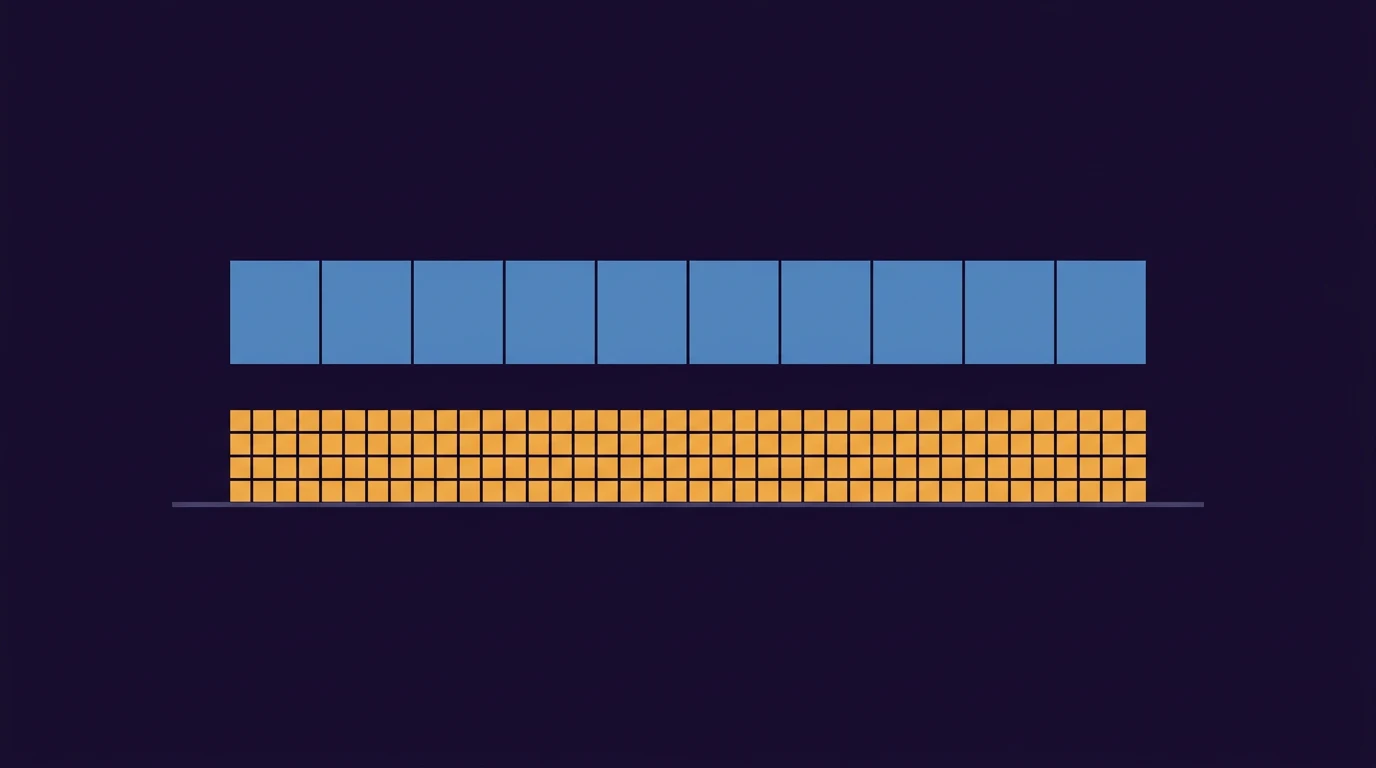
Le tarif d’un modèle indique le coût par million de tokens. Il ne dit pas combien de tokens votre texte va consommer, et cela dépend de la façon dont le modèle découpe le texte en morceaux. Nous avons testé cela de la manière la plus simple possible : nous avons envoyé le même fragment de texte polonais, 7843 caractères et environ 1350 mots, à huit modèles avec une limite d’un token de réponse, puis nous avons lu dans la facturation API combien de tokens d’entrée chacun avait comptabilisés. Coût total du test : quelques centimes.
| Modèle | Tokens pour le même texte | Caractères par token | Par rapport à GPT-6 Astra |
|---|---|---|---|
| GPT-6 Astra | 2 466 | 3,18 | 0 % |
| GPT-5.6 Sol | 2 466 | 3,18 | 0 % |
| Grok 4.6 | 2 489 | 3,15 | +1 % |
| DeepSeek V4 Pro | 2 599 | 3,02 | +5 % |
| Kimi K3 | 3 355 | 2,34 | +36 % |
| Claude Sonnet 5 | 3 857 | 2,03 | +56 % |
| Claude Fable 5.1 | 3 859 | 2,03 | +56 % |
| Gemini 3.8 Flash | pas de données : avec une limite d’un token, l’API n’a pas renvoyé de facturation | ||
Deux familles de tokenizers
Les résultats se répartissent en deux groupes. Les modèles d’OpenAI, xAI et DeepSeek encodent environ 3,1 caractères de texte polonais par token. Les modèles d’Anthropic et Kimi découpent plus finement : Claude nécessite 56 % de tokens en plus pour le même texte, Kimi 36 % de plus. Les deux modèles OpenAI ont donné un résultat identique, ce qui confirme qu’Astra utilise le même tokenizer que la ligne 5.6.
Pour l’anglais, ces différences sont plus faibles, car tous les tokenizers ont été entraînés principalement sur cette langue. Le polonais, avec ses déclinaisons et ses caractères diacritiques, est pour certains d’entre eux une langue de seconde catégorie, et vous payez cette différence à chaque requête.
Impact sur votre facture
GPT-6 Astra et Claude Fable 5.1 ont un tarif identique : 10 dollars par million de tokens d’entrée. Mais pour le même texte polonais, Claude comptabilise 3859 tokens, tandis qu’Astra n’en compte que 2466. À tarif égal, l’entrée chez Fable coûte réellement 56 % de plus. Pour une requête isolée, cela représente une fraction de centime ; pour mille documents longs par mois, c’est une différence visible sur la facture.
Cela fonctionne aussi dans l’autre sens, en faveur des modèles moins chers. Claude Sonnet 5 coûte 2 dollars par million de tokens d’entrée, soit cinq fois moins qu’Astra, mais à cause d’un tokenizer plus dense, l’avantage tarifaire réel sur du texte polonais passe de cinq fois à environ trois fois. Comparer uniquement les grilles tarifaires mène à des conclusions erronées si vous ne tenez pas compte du tokenizer.
Google · Vos sourcesPromptif plus haut dans Google - en un clicAjouter aux sources préférées →Comment le calculer pour vos propres textes
Pas besoin de deviner. Il suffit d’envoyer votre document type au modèle avec une limite d’un token de réponse et de lire le nombre de tokens d’entrée dans la facturation. Le coût d’une telle mesure est une fraction de centime, et le résultat en dit plus sur votre facture qu’un tableau de prix.
Une précision : nous avons mesuré un seul fragment d’un seul texte en polonais. Les proportions entre tokenizers sont stables, car elles découlent de leur construction, mais les chiffres exacts pour vos documents peuvent légèrement varier, surtout pour des textes contenant beaucoup de code, de chiffres ou de noms propres.
More on this from PROMPTIF


 benchmarks·GPT-6 Astra programmation : résultats tests et limitesTerminal-Bench, DeepSWE, FrontierCode : les vrais résultats de GPT-6 Astra face à Claude Fable 5.1 et Opus 5, avec ce qu'ils ne disent pas.