Decision Index : Artificial Analysis évalue les modèles de décision
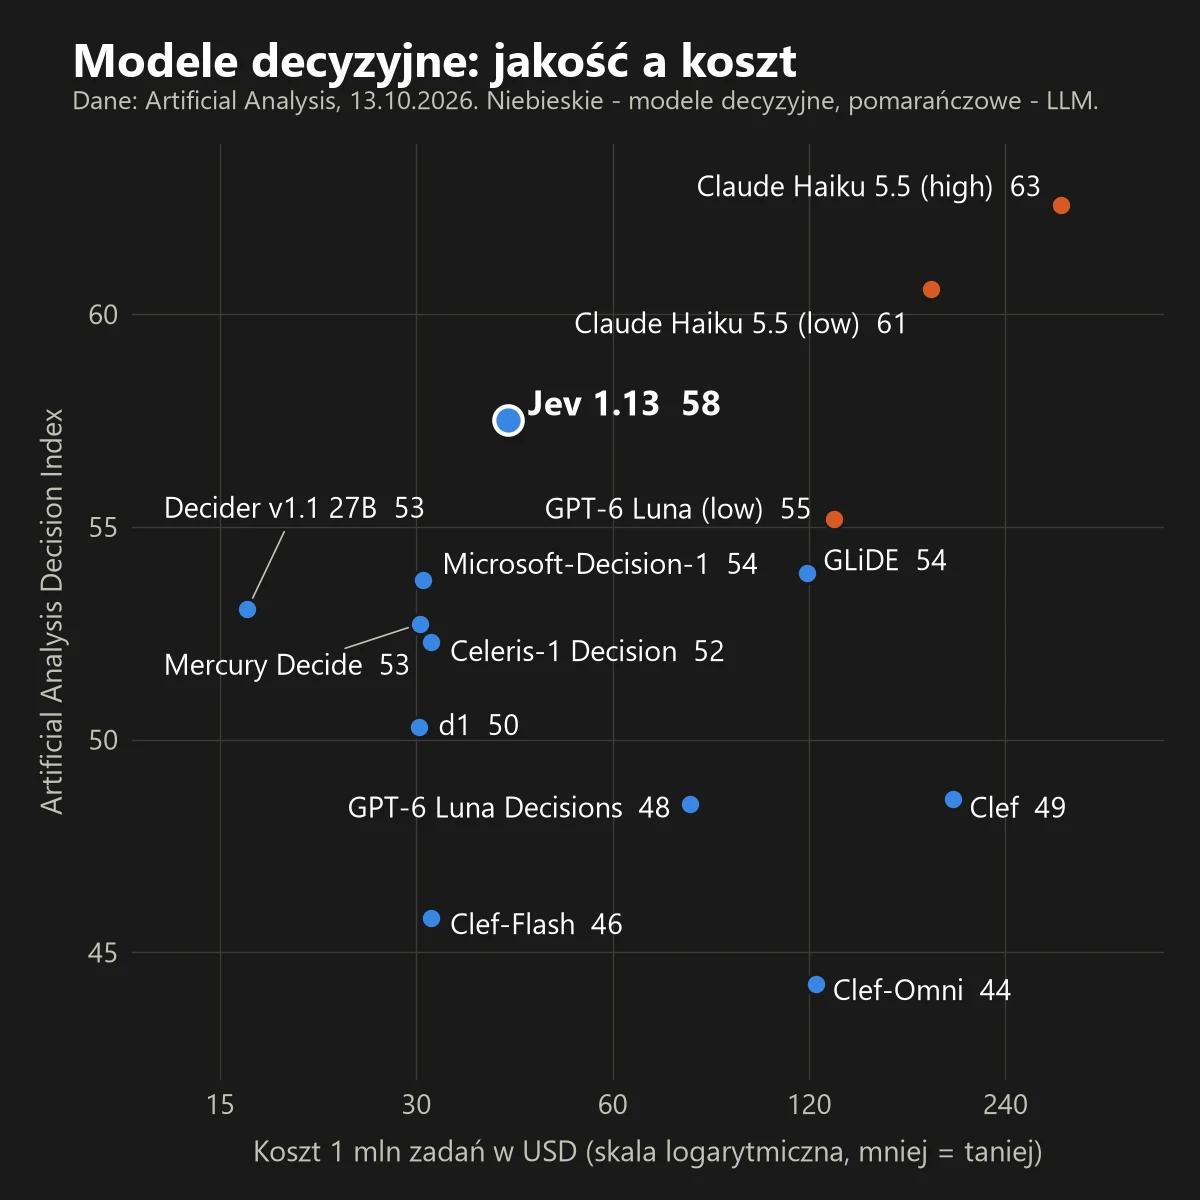
Le Decision Index v1.0 compare les modèles de décision IA : Jev 1.13 mène à 58 points. Coûts dès 15,20 € par million de tâches, face aux LLM classiques.
👁 122 lectures
Le 13 octobre 2026, Artificial Analysis a publié le Decision Index v1.0, le premier classement de modèles indépendant consacré aux modèles de décision, ces architectures d’IA qui ne rédigent aucun texte mais sélectionnent une réponse dans une liste prédéfinie en fournissant la probabilité de chaque option. En tête figure Jev 1.13 de TypeSafe avec 58 points, devant GLiDE (Fastino) et Microsoft-Decision-1 (54 points chacun). L’alternative la plus économique est Decider v1.1 27B de Perplexity : environ 15,20 € (17 USD) pour un million de requêtes. Un LLM traditionnel tel que Claude Haiku 5.5 obtient certes un score supérieur (61), mais les mesures d’AA révèlent qu’il est 11 fois plus lent et 4,4 fois plus coûteux que le leader.
Chiffres clés (Artificial Analysis, 13.10.2026)
- 11 modèles de décision évalués dans l’indice, dont 9 présentés dès l’article de lancement.
- Leader : Jev 1.13 (TypeSafe) - 58 points, env. 37,56 € (42 USD) par million de requêtes, 0,13 s par traitement.
- Coût par million de tâches : d’environ 15,20 € (17 USD pour Decider v1.1 27B) à 177,98 € (199 USD pour Cloudflare Clef).
- Latence par tâche : de 0,06 s (Celeris-1 Decision) à 0,5 s (Mercury Decide).
- Claude Haiku 5.5 (low) : 61 points, env. 164,56 € (184 USD) par million de tâches, 1,4 s par requête.
Les montants en euros sont des conversions estimatives basées sur le cours de référence de la BCE au 12.10.2026 (1 EUR = 1,1181 USD ; source : BCE).
Transparence : je connais déjà le modèle Jev pour l’avoir exploré plus tôt - j’ai développé en septembre un petit client API dédié pour mes propres outils éditoriaux. TypeSafe n’a ni commandé ni rémunéré cet article, et l’analyse de ses performances s’appuie uniquement sur les mesures indépendantes d’Artificial Analysis.
Qu’est-ce qu’un modèle de décision ?
Un modèle de décision reçoit deux éléments en entrée : un contexte (par exemple le texte d’une demande client) et un ensemble de questions accompagnées de réponses fermées. Au lieu de rédiger une réponse textuelle, il calcule la distribution de probabilité associée à chaque option autorisée. Artificial Analysis l’illustre à partir du message suivant (traduit du matériel de test polonais) : « les virements sont bloqués depuis 3 jours, et je dois payer mon loyer demain », auquel sont soumises trois questions simultanées :
- quel service contacter - paiements, support technique ou gestion de compte (choix dans une liste),
- demande urgente - oui ou non,
- niveau d’irritation du client - calme, frustré, très énervé (sur une échelle graduée).
Le modèle de décision traite ces trois points en un seul appel et délivre directement la répartition des probabilités. À l’inverse, un LLM conventionnel doit générer un bloc JSON que votre code doit ensuite analyser, sans fournir d’indice parfaitement calibré sur son degré de confiance. J’ai détaillé ce fonctionnement dans le guide consacré aux modèles de décision IA, accompagné d’un test que nous avions conduit en polonais sur des tickets d’assistance.
Classement : Artificial Analysis Decision Index v1.0
| Modèle (société) | Score Indice | Coût pour 1M tâches | Temps par tâche |
|---|---|---|---|
| Jev 1.13 (TypeSafe) | 58 | ~37,56 € (42 USD) | 0,13 s |
| GLiDE (Fastino Labs) | 54 | ~106,43 € (119 USD) | 0,22 s |
| Microsoft-Decision-1 (Microsoft) | 54 | ~27,73 € (31 USD) | 0,21 s |
| Decider v1.1 27B (Perplexity) | 53 | ~15,20 € (17 USD) | 0,17 s |
| Mercury Decide (Inception) | 53 | ~26,83 € (30 USD) | 0,50 s |
| Celeris-1 Decision (Celeris) | 52 | ~28,62 € (32 USD) | 0,06 s |
| d1 (Liquid AI) | 50 | ~26,83 € (30 USD) | 0,30 s |
| Clef (Cloudflare) | 49 | ~177,98 € (199 USD) | 0,31 s |
| GPT-6 Luna Decisions (OpenAI) | 48 | ~70,66 € (79 USD) | 0,17 s |
| Clef-Flash (Cloudflare) | 46 | ~28,62 € (32 USD) | 0,30 s |
| Clef-Omni (Cloudflare) | 44 | ~110,01 € (123 USD) | 0,17 s |
À titre comparatif, voici les résultats des modèles de langage généralistes soumis aux mêmes épreuves : Claude Haiku 5.5 (low) atteint 61 points pour env. 164,56 € (184 USD) et 1,4 s ; GPT-6 Luna (low) recueille 55 points à env. 117,16 € (131 USD) et 1,5 s. La latence reflète la médiane par tâche, tandis que le coût correspond à la dépense moyenne estimée sur la base des tarifs publics par token multipliée par un million. Les modèles de décision ne facturent que les tokens d’entrée, tandis que les LLM facturent l’entrée et la sortie.
Méthode de calcul de l’indice
Le Decision Index repose sur une moyenne pondérée équilibrée entre quatre bancs d’essai (25 % chacun) :
- AA-Omniscience-Decision (connaissances générales et gestion des hallucinations) : 500 questions non publiques offrant cinq possibilités (quatre propositions de réponses et la mention « je ne sais pas »). Le score combine à parts égales l’exactitude des choix et l’aptitude à admettre l’ignorance plutôt qu’à deviner au hasard.
- HLE-MultiChoice (capacités de raisonnement) : 513 questions à choix multiples issues du Humanity’s Last Exam, considéré comme l’un des benchmarks les plus ardus pour les intelligences artificielles.
- When2Call (sélection d’outils) : protocole développé par NVIDIA dans lequel le modèle analyse un dialogue et une panoplie d’outils disponibles pour trancher : répondre directement, solliciter une fonction précise, demander des précisions ou s’avouer incapable de traiter la requête.
- WildGuardTest (classification et sécurité) : corpus conçu par Ai2 permettant de déterminer si la requête d’un internaute est toxique, si la réplique du modèle constitue un refus et si cette dernière reste saine.
Enseignements des résultats
- Jev s’impose grâce au raisonnement. Sur HLE-MultiChoice, il culmine à 21 points, alors qu’aucun autre modèle de décision ne dépasse la barre des 15. En matière de connaissances brutes, sa précision n’atteint que 35 % (le record revenant à d1 de Liquid AI avec 41 %).
- Microsoft-Decision-1 excelle pour reconnaître ses lacunes, en répondant « je ne sais pas » dans 40 % des situations opportunes (35 % pour Jev, 32 % pour Mercury Decide, sous les 17 % pour le reste). Bien que d1 soit le plus précis en savoir pur, il n’admet quasiment jamais son incertitude (score de 2).
- Sur l’aiguillage d’outils, les modèles de décision distancent les LLM. Au test When2Call, Celeris-1 Decision et GLiDE décrochent 84 points chacun, contre 73 pour Claude Haiku 5.5 (low) et 77 pour GPT-6 Luna (low).
- Avantage confirmé sur la classification. Sur WildGuardTest, GLiDE obtient 95 points, Jev et Decider 94 chacun, surpassant Claude Haiku 5.5 low (93) et GPT-6 Luna low (89).
- Une surconfiance généralisée. Artificial Analysis a confronté les probabilités annoncées à l’exactitude réelle : sur la connaissance et la logique, la réussite effective demeure en deçà du taux de certitude revendiqué. Sur les tâches de classification et d’outillage, le calibrage s’avère néanmoins « relativement solide ».
Pourquoi cette approche est-elle plus économique qu’un LLM ?
Contrairement aux modèles de langage génératifs, un modèle de décision ne produit aucun token en sortie. Il analyse l’entrée une unique fois, évalue la distribution statistique relative à toutes les questions simultanément et s’arrête immédiatement. Il en découle trois atouts majeurs démontrés par les métriques d’AA :
- Une facturation cantonnée aux tokens d’entrée. Aucun coût lié aux tokens de sortie ou de raisonnement intermédiaire.
- Le traitement de plusieurs interrogations en une requête unique, évitant l’écriture séquentielle d’un document JSON terme à terme.
- Des temps de calcul de l’ordre de la centaine de millisecondes. Entre 0,06 et 0,5 s par opération, contre 1,4 à 1,5 s pour les petits modèles de langage en mode basse latence.
L’écart financier se creuse à grande échelle. Sur la seule classification (WildGuardTest), Artificial Analysis a chiffré le million d’exécutions à environ 10,82 € (12,1 USD) pour Decider et 20,39 € (22,8 USD) pour Jev, contre environ 81,84 € (91,5 USD) pour Claude Haiku 5.5 (low).
Quand privilégier un modèle de décision ?
Cette solution est optimale dès lors que le choix dépend d’une liste finie et que le volume de sollicitations est massif :
- tri et routage automatisé des tickets de support, courriels ou documents entrants,
- modération de contributions textuelles et détection d’instructions malveillantes,
- sélection d’outils au sein d’architectures d’agents autonomes (« exécuter ou solliciter un complément »),
- points de contrôle de qualité : valider, corriger ou transférer vers un opérateur humain.
En revanche, la méthode s’avère inadaptée quand l’exhaustivité encyclopédique ou la rédaction textuelle sont requises. Sur les interrogations de connaissances générales, Claude Haiku 5.5 (low) affiche 52 % d’exactitude et GPT-6 Luna (low) 66 %, contre 28 à 41 % pour les modèles décisionnels. Par ailleurs, ces derniers ne rédigeront pas d’argumentaire personnalisé à destination d’un utilisateur : cette charge demeure l’apanage exclusif des LLM.
Perspectives
Artificial Analysis maintient son banc d’essai à jour et invite les éditeurs à lui soumettre leurs nouvelles versions. Vous trouverez les tableaux complets détaillant les quatre épreuves, les tarifications d’accès API, les conditions de disponibilité ainsi que notre retour d’expérience mené en polonais sur des tickets d’assistance au sein de notre dossier consacré aux modèles de décision IA. J’avais également documenté précédemment les particularités de Jev conçu par TypeSafe, de Cloudflare Clef et de Strands Decider 2B développé par AWS.
Google · Vos sourcesPromptif plus haut dans Google - en un clicAjouter aux sources préférées →Sources
- Artificial Analysis : Artificial Analysis Decision Index v1.0 (13.10.2026)
- Artificial Analysis : Decision Index - classement en direct (données relevées le 13.10.2026 au soir)
- Artificial Analysis : méthodologie du Decision Index
- Artificial Analysis sur X (publication du 13.10.2026)
More on this from PROMPTIF



