Open WebUI et Ollama : installer un ChatGPT local sur Windows
Open WebUI transforme Ollama en un véritable clone local de ChatGPT, utilisable sans Docker grâce à uv. Voici mes tests complets sur RTX 4090, de l'analyse PDF aux benchmarks détaillés.
👁 120 lectures
Open WebUI est une interface web qui reproduit fidèlement l’ergonomie de ChatGPT, tout en faisant tourner les modèles localement sur votre machine sans dépendre d’Internet. En connectant Open WebUI Ollama, vous bénéficiez d’un véritable ChatGPT local avec gestion documentaire, historique complet et support multi-utilisateur. J’ai déployé la version 0.12.3 sur Windows sans passer par Docker pour mesurer ses performances réelles sur ma configuration.
Au 17 octobre 2026
- Dernière version : Open WebUI 0.12.3 du 16 octobre 2026 (la branche 0.12 est sortie le 10 octobre).
- Nécessite Python 3.11 ou 3.12 (Python 3.13 n’est pas pris en charge). L’installation se fait via
uvqui gère automatiquement la version adéquate. - Licence : « Open WebUI License », combinant la base BSD-3 avec l’interdiction de retirer le logo ou la marque sans accord (autorisé sans modification jusqu’à 50 utilisateurs sur 30 jours). Utilisation gratuite, y compris en entreprise.
- Espace disque : 1,8 Go (hors modèles). Le serveur consomme environ 800 Mo de RAM sur ma machine.
Présentation de l’interface Open WebUI
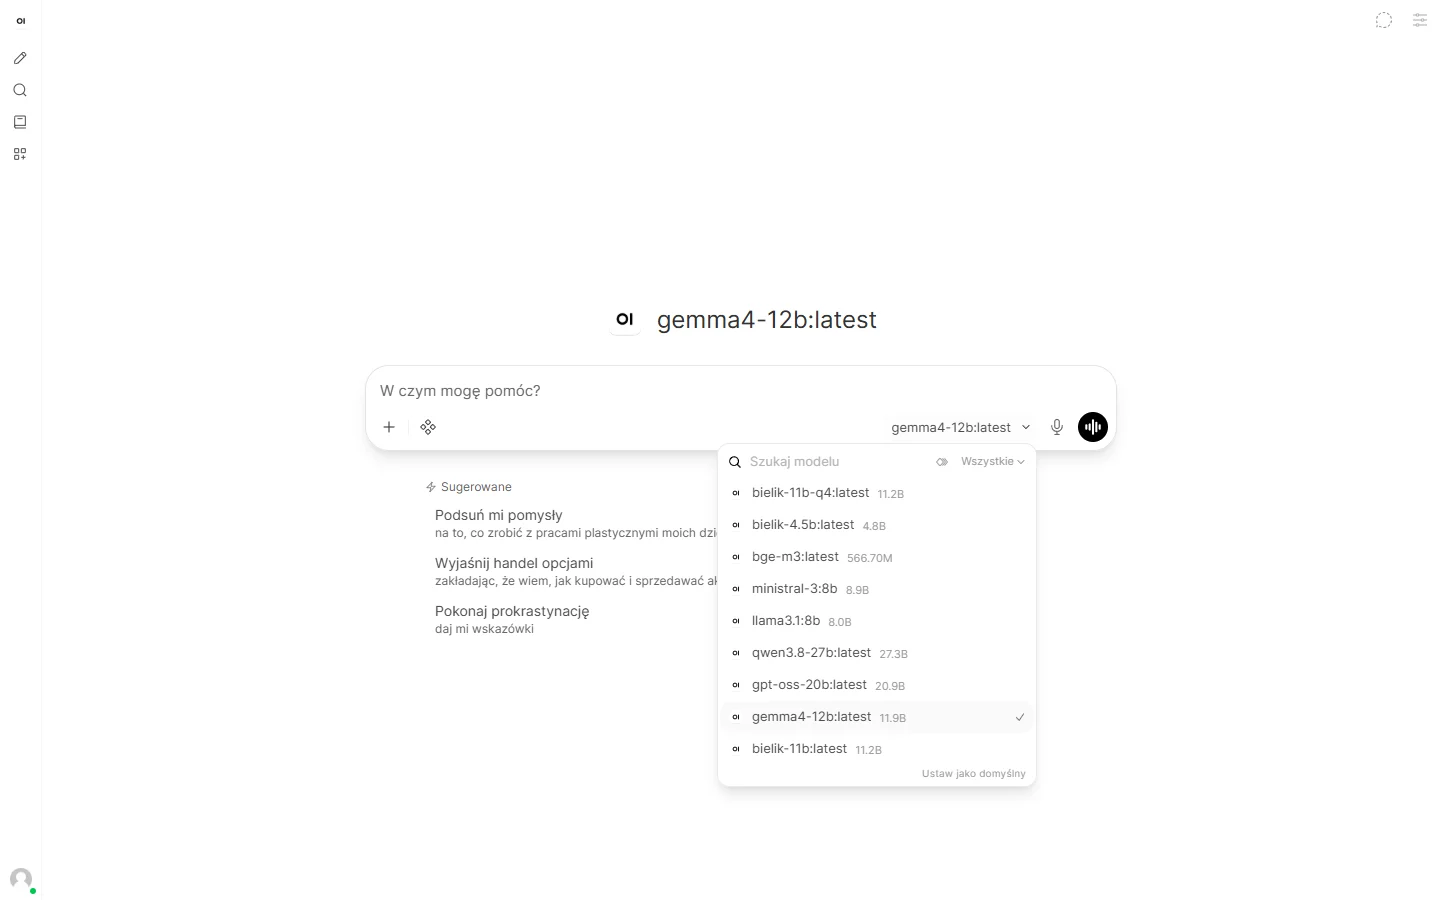
Open WebUI fonctionne comme un serveur web local. Vous lancez le processus sur votre ordinateur et y accédez dans votre navigateur à l’adresse http://localhost:8080. L’application ne génère pas de tokens elle-même : elle délègue le calcul à Ollama ou à une API compatible OpenAI (comme LM Studio ou llama.cpp), tout en enrichissant l’expérience utilisateur par rapport à la simple ligne de commande :
- Historique des échanges, organisation en dossiers, moteur de recherche et export des discussions.
- Sélecteur de modèle direct et comparaison côte à côte de deux modèles sur une même invite.
- Import de fichiers et bases de connaissances pour interroger vos documents (RAG).
- Gestion de comptes multiples avec contrôle des permissions pour un usage partagé.
- Interface multilingue qui s’adapte automatiquement à la langue de votre navigateur.
Installation pas à pas sur Windows sans Docker
L’installation s’effectue sans conteneur grâce au gestionnaire d’outils Python uv. Voici la procédure exacte que j’ai suivie :
- Installer Ollama et charger un modèle. Pour mes bancs d’essai, j’ai sélectionné Gemma 4 12B (fichier Q4_0 QAT, 7,0 Go). Si vous disposez de plus de puissance, j’ai également analysé le comportement de Gemma 4 31B en local sur RTX 4090.
- Installer uv (développé par Astral) via le terminal Windows :
winget install astral-sh.uv. - Installer Open WebUI dans un environnement isolé sous Python 3.11 :
uv tool install --python 3.11 open-webuiLa première installation le 3 octobre a pris 59 secondes sur mon système. La mise à niveau de la version 0.11.4 vers la 0.12.3 via
uv tool upgrade open-webuia duré 1 minute et 55 secondes. - Démarrer le serveur en mode monoposte sans authentification :
$env:WEBUI_AUTH = "False"
$env:DATA_DIR = "$HOME\open-webui-dane"
open-webui serve --host 127.0.0.1 --port 8080
La variable
WEBUI_AUTH=Falsedésactive l’écran de connexion initial,DATA_DIRisole le répertoire de stockage et--host 127.0.0.1limite l’accès à la machine locale. - Si la commande est introuvable, exécutez
uv tool update-shellpuis relancez votre console PowerShell. - Patienter lors de l’initialisation. Avec un dossier de données vierge, le serveur a mis 81 secondes à s’initialiser lors du premier démarrage, contre 31 secondes lors d’un redémarrage ultérieur propre.
- Se connecter. Rendez-vous sur
http://localhost:8080. Si le service Ollama est actif, vos modèles apparaissent instantanément.
Pour un déploiement collectif, omettez la variable WEBUI_AUTH=False pour créer un compte administrateur local, et passez l’argument --host 0.0.0.0 pour ouvrir l’accès sur votre réseau local. Pour référence, la commande Docker officielle reste docker run -d -p 3000:8080 --add-host=host.docker.internal:host-gateway -v open-webui:/app/backend/data -e WEBUI_SECRET_KEY=twoj-klucz --name open-webui --restart always ghcr.io/open-webui/open-webui:main, mais je ne l’ai pas testée car Docker n’est pas installé sur ma configuration.
Test de performance : chat avec Gemma 4 12B
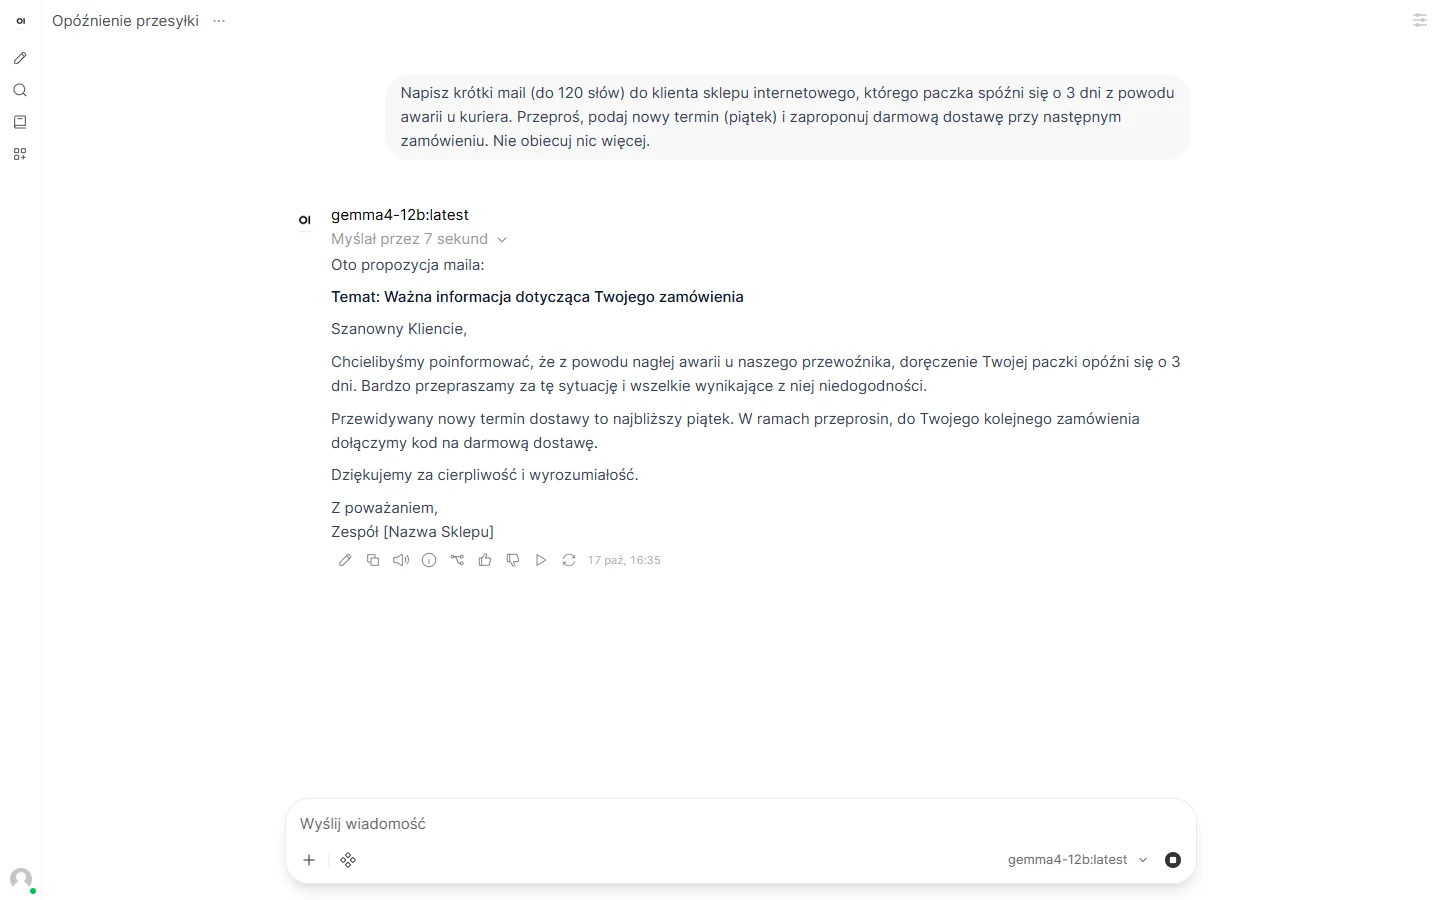
Sur ma station (RTX 4090 24 Go, i9-14900KF, 64 Go RAM, Windows 11, Ollama 0.40.5), j’ai soumis à Gemma 4 12B mon invite standard de rédaction : un message client concernant un colis retardé, exigeant des excuses, un nouveau créneau au vendredi et la livraison offerte sur la commande suivante. Le modèle a réfléchi pendant 7 secondes avant de formuler une réponse intégrant parfaitement les trois consignes.
| Mesure (17.10.2026) | Open WebUI | Ollama seul |
|---|---|---|
| Premier temps de réponse (disque) | 36,8 s | - |
| dont chargement du modèle | 19,9 s | - |
| Temps de réponse suivant | 17,4 s | 12,4 s |
| Vitesse de génération | 80-85 tok/s | 91,3 tok/s |
| Tokens de l’invite | 5694 | 95 |
| Pic de VRAM | 9,7 Go | - |
Le stockage de mes modèles sur disque externe USB explique la durée initiale de chargement. La carte graphique mobilisait 1,4 Go de VRAM avant le test, ce qui situe la charge nette du modèle et du contexte à environ 8,4 Go.
Le point le plus frappant concerne le volume de tokens en entrée : 95 tokens avec Ollama seul contre 5694 tokens dans Open WebUI. La version 0.12 injecte systématiquement le descriptif des outils natifs (mémoire, notes, recherche de messages et de fichiers). Sur une RTX 4090, cet écart entraîne seulement quelques secondes d’attente et 10 % de débit en moins. En revanche, sur un GPU limité à 8 Go de mémoire, cette surcharge peut saturer la VRAM disponible. Ces modules complémentaires peuvent être désactivés dans les paramètres du modèle.
Test RAG : dialogue avec un fichier PDF
Open WebUI fragmente les documents déposés, génère des vecteurs et ajoute les extraits pertinents à chaque requête. Par défaut, le système exploite all-MiniLM-L6-v2, optimisé pour l’anglais. Pour un traitement multilingue adapté, j’ai configuré bge-m3 via Ollama :
- Téléchargement du modèle vectoriel :
ollama pull bge-m3(1,2 Go). - Dans l’interface : icône de profil en bas à gauche, Paramètres, section Administration, onglet Documents. Définir le moteur d’intégration sur Ollama, indiquer
bge-m3:latestpuis enregistrer. - Réindexer vos documents antérieurs pour actualiser les calculs d’incorporation.
J’ai testé l’outil en téléversant un document PDF juridique de 607 Ko, soumis à une série de 10 questions précises, identique à l’évaluation menée le 3 octobre avec mon script dédié. L’indexation du fichier a nécessité 6,6 secondes.
- Open WebUI 0.12.3 (réglages par défaut, bge-m3, Gemma 4 12B) : 8 réponses correctes sur 10 (vérification manuelle). Le système n’a pas localisé le délai de renvoi de marchandise ni le seuil d’exclusion hors établissement, mais a précisé explicitement l’absence d’information trouvée.
- Mon script RAG spécialisé du 3 octobre (découpage par article, même modèle) : 9 réponses correctes sur 10.
- Gemma sans document support (test du 3 octobre) : 5 réponses correctes sur 10.
Le délai de traitement oscillait entre 12 et 39 secondes par question (76 secondes pour la première avec l’initialisation des modèles). L’interface affiche rigoureusement la source documentaire de chaque extrait. L’utilisation conjointe de Gemma et de bge-m3 a atteint un pic de 10,8 Go de VRAM. Pour ceux qui arbitrent entre infrastructure locale et services managés, mon analyse sur le coût réel d’une IA locale face aux API apporte un éclairage budgétaire précieux.
Script de démarrage automatique PowerShell
Le script open-webui-start.ps1 valide la présence d’Ollama, installe au besoin uv, Open WebUI et le modèle bge-m3, applique une configuration monoposte sans télémétrie et ouvre le navigateur dès que l’instance est prête. Testé le 17 octobre 2026 sous Windows PowerShell avec un répertoire vierge, le serveur s’est lancé en 31 secondes. Exécution : powershell -ExecutionPolicy Bypass -File .\open-webui-start.ps1 (arrêt avec Ctrl+C).
# open-webui-start.ps1 - instaluje (jesli trzeba) i uruchamia Open WebUI z Ollama na Windows 10/11.
# Opis:    Stan na 17.10.2026 (Open WebUI 0.12.3, Ollama 0.40).
# Uzycie (PowerShell):  powershell -ExecutionPolicy Bypass -File .\open-webui-start.ps1
# Opcje: -Folder "D:\czaty"  -Port 8081  -BezPrzegladarki
# Zatrzymanie: Ctrl+C w tym oknie.
param(
    [string]$Folder = "$HOME\open-webui-dane",
    [int]$Port = 8080,
    [switch]$BezPrzegladarki
)
$ErrorActionPreference = 'Stop'

function Test-Url($u) {
    try { Invoke-RestMethod -Uri $u -TimeoutSec 3 | Out-Null; return $true } catch { return $false }
}

# 1. Ollama musi byc zainstalowana i uruchomiona
if (-not (Get-Command ollama -ErrorAction SilentlyContinue)) {
    Write-Host 'Brak Ollamy. Zainstaluj ja poleceniem:  winget install Ollama.Ollama' -ForegroundColor Red
    exit 1
}
if (-not (Test-Url 'http://127.0.0.1:11434/api/version')) {
    Write-Host 'Ollama nie odpowiada. Uruchom aplikacje Ollama i sprobuj ponownie.' -ForegroundColor Red
    exit 1
}

# 2. uv (menedzer Pythona od Astral) - sam pobierze Pythona 3.11
if (-not (Get-Command uv -ErrorAction SilentlyContinue)) {
    Write-Host 'Instaluje uv przez winget...'
    winget install --id astral-sh.uv -e
    $env:Path = [Environment]::GetEnvironmentVariable('Path', 'User') + ';' + [Environment]::GetEnvironmentVariable('Path', 'Machine')
}

# 3. Open WebUI jako osobne narzedzie (nie rusza Twojego Pythona)
$exe = Join-Path $HOME '.local\bin\open-webui.exe'
if (-not (Test-Path $exe)) {
    Write-Host 'Instaluje Open WebUI (ok. 1,8 GB, kilka minut)...'
    uv tool install --python 3.11 open-webui
}

# 4. Model do wyszukiwania w dokumentach, ktory zna polski
$modele = @((Invoke-RestMethod -Uri 'http://127.0.0.1:11434/api/tags').models | ForEach-Object { $_.name })
if ($modele -notcontains 'bge-m3:latest') {
    Write-Host 'Pobieram bge-m3 do dokumentow (1,2 GB)...'
    ollama pull bge-m3
}
if (@($modele | Where-Object { $_ -ne 'bge-m3:latest' }).Count -eq 0) {
    Write-Host 'Uwaga: w Ollamie nie ma jeszcze modelu do rozmowy. Jak go pobrac:  -ForegroundColor Yellow
}

# 5. Ustawienia: jeden uzytkownik bez logowania, tylko ten komputer, bez telemetrii
New-Item -ItemType Directory -Force -Path $Folder | Out-Null
$env:DATA_DIR = $Folder
$env:WEBUI_AUTH = 'False'
$env:OLLAMA_BASE_URL = 'http://127.0.0.1:11434'
$env:ENABLE_OPENAI_API = 'False'
$env:RAG_EMBEDDING_ENGINE = 'ollama'
$env:RAG_EMBEDDING_MODEL = 'bge-m3:latest'
$env:ANONYMIZED_TELEMETRY = 'false'
$env:DO_NOT_TRACK = 'true'
$env:SCARF_NO_ANALYTICS = 'true'
$env:PYTHONIOENCODING = 'utf-8'

# 6. Start serwera i otwarcie przegladarki, gdy bedzie gotowy
Write-Host "Startuje Open WebUI na http://localhost:$Port (pierwszy start trwa 1-2 minuty)..."
$p = Start-Process -FilePath $exe -ArgumentList @('serve', '--host', '127.0.0.1', '--port', "$Port") -NoNewWindow -PassThru
$t = Get-Date
while (-not (Test-Url "http://127.0.0.1: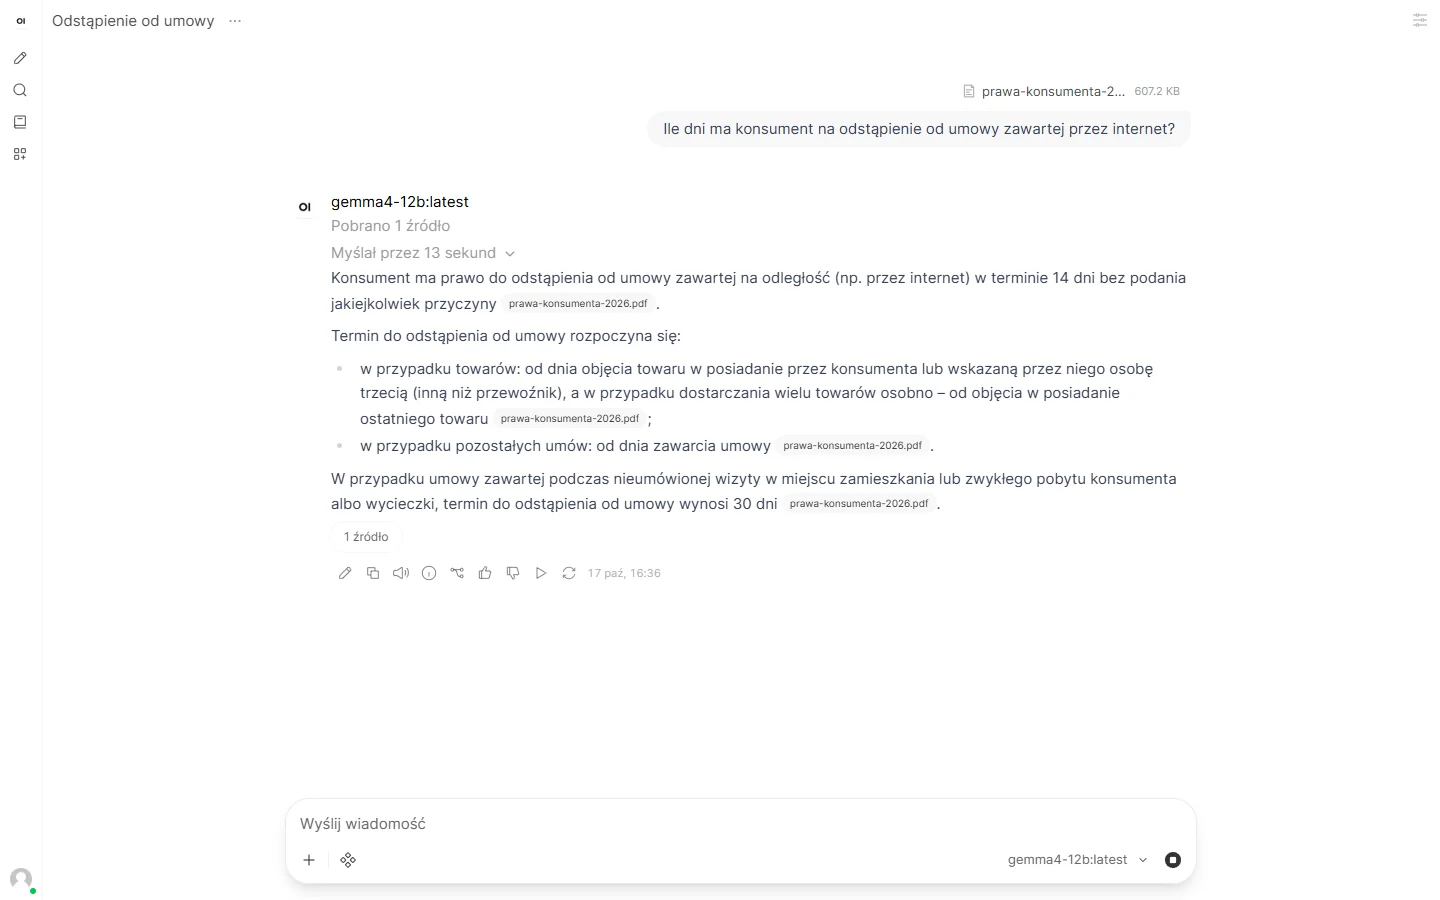
Open WebUI face à LM Studio et Jan
Le choix de votre interface dépend de vos contraintes techniques et du type d’utilisation recherché :
| Caractéristique | Open WebUI | LM Studio | Jan |
|---|---|---|---|
| Format | Interface web | Application bureau | Application bureau |
| Moteur d’inférence | Ollama ou API | Propriétaire | Intégré (llama.cpp) |
| Comptes et réseau | Oui | Non | Non |
| Installation | Ligne de commande | Installateur | Installateur |
| Licence | Open WebUI License | Gratuit, fermé | Apache 2.0 |
À qui s’adresse chaque outil ?
- Open WebUI : à privilégier si vous cherchez l’ergonomie exacte de ChatGPT, l’indexation de documents complexes, ou le partage d’une même carte graphique entre plusieurs postes d’un atelier.
- LM Studio : recommandé si vous préférez une interface graphique autonome intégrant un catalogue de modèles téléchargeables sans console.
- Jan : idéal pour disposer d’un outil open source basique sans dépendance externe ni configuration en terminal.
Résolution des problèmes fréquents
- « Python 3.13 is not supported » : forcez la version adéquate en exécutant
uv tool install --python 3.11 open-webuisans impacter votre installation Python globale. - Liste de modèles vide : vérifiez qu’Ollama fonctionne via la commande
ollama listet contrôlez l’adresse renseignée dansOLLAMA_BASE_URL. - Port 8080 déjà occupé : démarrez l’instance sur un autre port en ajoutant l’argument
--port 8081. - Génération ralentie par rapport au terminal : ce décalage provient des prompts système étendus et des traitements post-génération (étiquetage automatique, génération de titre, suggestions). Ces mécanismes se désactivent dans la section Interface des options d’administration.
Foire aux questions
Open WebUI est-il gratuit ?
Oui, son exploitation est totalement gratuite, y compris dans un cadre professionnel. Seule la suppression du nom et du logo pour plus de 50 utilisateurs nécessite une licence commerciale payante.
S’agit-il d’un ChatGPT hors ligne ?
Oui, l’interface imite ChatGPT mais s’appuie sur votre matériel local. Une fois les paquets récupérés, vos données restent confinées sur votre machine, la variable OFFLINE_MODE=True coupant tout appel extérieur.
Comment connecter Open WebUI à Ollama ?
Sur le même poste, la connexion est automatique vers http://127.0.0.1:11434. Si Ollama réside sur une autre machine du réseau, il suffit de configurer son adresse IP dans la variable OLLAMA_BASE_URL.
L’outil requiert-il obligatoirement Docker ?
Non, l’installation peut être effectuée facilement sous Windows sans conteneur via uv ou pip. La méthode via uv permet d’isoler l’environnement en quelques secondes.
Peut-on connecter des API comme celles d’OpenAI ou d’Anthropic ?
Oui, il suffit de renseigner l’adresse de l’API et votre clé dans les options de connexion. Dans cette configuration, les échanges transitent par le fournisseur distant avec la facturation au token habituelle.
Comment mettre à jour Open WebUI sans perdre ses données ?
Il suffit de saisir la commande uv tool upgrade open-webui. Vos discussions et paramètres restent préservés dans le dossier pointé par DATA_DIR.
Sources et vérification
- Open WebUI sur GitHub : versions (0.12.0 du 10.10.2026, 0.12.3 du 16.10.2026).
- Open WebUI License et historique des licences.
- Documentation officielle Open WebUI : démarrage rapide.
- Paquet open-webui sur PyPI.
- Tests d’installation et bancs d’essai personnels : Windows 11, RTX 4090, Ollama 0.40.5, Open WebUI 0.12.3, 17 octobre 2026.
Vérifié le 17 octobre 2026.
More on this from PROMPTIF