Gemini 4 Argon invente-t-il des sources ? Test de 16 références
Sur 16 références proposées par Gemini 4 Argon, 11 étaient exactes, 3 comportaient des erreurs et 2 étaient inventées. Aucun DOI fictif.
👁 118 lectures
J’ai demandé à Gemini 4 Argon des références pour deux mémoires de licence, puis vérifié chacune des 16 publications proposées. Résultat : 11 références réelles avec des informations exactes, 3 publications réelles comportant des erreurs (prénom d’auteur ou revue incorrects) et 2 références inventées. Les deux faux titres concernaient le budget participatif en Pologne. Point positif : Argon n’a inventé aucun DOI. C’est un net progrès par rapport à Gemini 3.8 Flash, mais un résultat moins bon que celui de tous les modèles haut de gamme d’Anthropic, d’OpenAI et de Meta. Pour en savoir plus sur le modèle, consultez notre guide Gemini 4 Argon.
Résultat du test, 13 octobre 2026
- Modèle : google/gemini-4-argon via OpenRouter, paramètres par défaut, deux sujets et 8 publications par sujet.
- Exactes : 11/16, erronées : 3, inventées : 2.
- Réseaux sociaux et dépression chez les adolescents : 8/8. Budget participatif en Pologne : 3/8 sans réserve.
- DOI inventés : 0. Coût des deux réponses : environ 0,0151 EUR (0,017 USD).
Comment j’ai mené le test
Chaque modèle a reçu le même prompt, une fois sur un sujet de psychologie et une fois sur un sujet consacré aux collectivités locales en Pologne. Voici la version traduite en français du prompt polonais utilisé pour le second sujet ; le test, lui, a été effectué en polonais :
Traduction du prompt polonais testé : Je rédige un mémoire de licence sur le thème suivant : « Le budget participatif dans les villes polonaises : participation des habitants et obstacles ». Donnez 8 publications scientifiques (articles de revues à comité de lecture ou livres) sur lesquelles je peux m’appuyer pour ma revue de littérature. Pour chaque publication, indiquez les auteurs, l’année, le titre, la revue ou la maison d’édition et le DOI, s’il existe. Répondez uniquement au format JSON : une liste d’objets comportant les champs « auteurs », « année », « titre », « source » et « DOI ».
Le premier sujet était : « Influence de l’utilisation des réseaux sociaux sur l’estime de soi et les symptômes dépressifs chez les adolescents ». Cette formulation est la traduction du prompt polonais testé, et non un prompt testé en français. J’ai vérifié chaque référence en trois étapes :
- recherche automatique dans Crossref, par DOI et par titre, ainsi que dans OpenAlex ;
- vérification manuelle des références absentes des bases : CEJSH, sites des éditeurs et des revues, catalogues ;
- contrôle séparé des auteurs, de l’année et de la revue, car un titre peut être réel alors que les autres informations sont erronées.
J’ai classé les résultats en trois catégories : « exacte » (toutes les informations concordent), « erronée » (la publication existe, mais une information au moins est incorrecte) et « inventée » (la publication n’existe pas). J’ai testé Argon le 13 octobre et les modèles concurrents les 12 et 13 octobre avec le même script.
Réseaux sociaux et dépression : 8 références exactes sur 8
Sur le sujet de psychologie, Argon n’a commis aucune erreur. Il a proposé sept articles en anglais avec un DOI et l’édition polonaise d’un livre de Jean Twenge.
| Auteurs | Titre (année) | Verdict |
|---|---|---|
| Woods, Scott | #Sleepyteens: Social media use in adolescence… (2016) | exacte |
| Kelly et al. | Social Media Use and Adolescent Mental Health (2018) | exacte |
| Keles, McCrae, Grealish | A systematic review: the influence of social media on depression… (2020) | exacte |
| Twenge et al. | Increases in Depressive Symptoms… (2018) | exacte |
| Valkenburg, Peter, Schouten | Friend Networking Sites and Their Relationship to Adolescents’ Well-Being… (2006) | exacte |
| Orben, Przybylski | The association between adolescent well-being and digital technology use (2019) | exacte |
| Vogel et al. | Social comparison, social media, and self-esteem (2014) | exacte |
| Twenge | iGen (édition polonaise, Le Goût du Verbe, 2019) | exacte |
Les sept DOI renvoient bien dans Crossref aux titres indiqués.
Budget participatif en Pologne : 3 références exactes sur 8
Le résultat change lorsqu’il s’agit de publications polonaises sur les collectivités locales. Argon s’est trompé sur cinq des huit références.
| Auteurs | Titre (année) | Verdict |
|---|---|---|
| Wojciech Keblowski | Le budget participatif. Petit guide pratique, traduction du titre polonais (2013) | exacte (rapport de l’Institut civique) |
| Piotr Kraszewski, Karol Mojkowski | Le budget citoyen en Pologne, traduction du titre polonais (2014) | erronée : l’auteur s’appelle Dariusz, et non Piotr Kraszewski |
| Dorota Kamrowska-Zaluska | Participatory Budgeting in Poland - Missing Link in Urban Regeneration Process (2016) | exacte (Procedia Engineering) |
| Borys Martela | Le budget participatif en Pologne : mise en œuvre et perspectives, traduction du titre polonais (2013) | exacte (Pouvoir de Juger, traduction de l’original polonais) |
| Beata Guziejewska | Le budget participatif comme instrument de politique locale et de gestion financière, traduction du titre polonais (2014) | inventée : l’autrice a écrit sur les budgets participatifs, mais dans e-Finanse, en 2018 |
| Magdalena Burchard-Dziubinska | Le budget citoyen comme forme participative de gouvernance, traduction du titre polonais (2014) | erronée : le titre et l’année sont exacts, mais pas la revue (il s’agit de Studia i Prace WNEiZ de l’Université de Szczecin) |
| « inscription corrompue dans le test original en polonais » Poniatowicz | Le concept de budget participatif (citoyen) et son application dans les villes polonaises, traduction du titre polonais (2014) | inventée : Marzanna Poniatowicz a publié en 2014 un texte portant un autre titre |
| Anna Sobol | Le budget citoyen comme outil de développement local en Pologne, traduction du titre polonais (2017) | erronée : l’autrice est Agnieszka Sobol et le titre ne comporte pas « en Pologne » |
Le plus trompeur, c’est que tous ces noms sont ceux de chercheurs ayant réellement travaillé sur le budget citoyen. Une recherche portant uniquement sur le nom « Guziejewska » fait apparaître un article sur le budget participatif, ce qui peut donner l’impression que tout concorde. C’est seulement en comparant le titre, l’année et la revue que l’on constate que la référence citée n’existe pas. L’expression « inscription corrompue dans le test original en polonais », quant à elle, n’est pas un prénom : c’est une inscription corrompue dans le test original en polonais à la place de Marzanna.
Point positif : aucun DOI inventé
Pour le sujet du budget, Argon n’a fourni aucun DOI. Dans ce champ, il indiquait « Aucun (je ne peux pas vérifier) » ou précisait qu’il ne pouvait pas vérifier le numéro sans accès aux bases. C’est le bon réflexe : un DOI inventé peut sembler crédible et être recopié dans une bibliographie sans vérification. À titre de comparaison, l’unique référence inventée de Muse Wonder comportait un DOI inexistant, et GPT-6 Astra a donné un DOI incorrect pour un article réel. Dommage qu’Argon n’ait pas fait preuve de la même prudence avec les titres.
Comparaison avec d’autres modèles
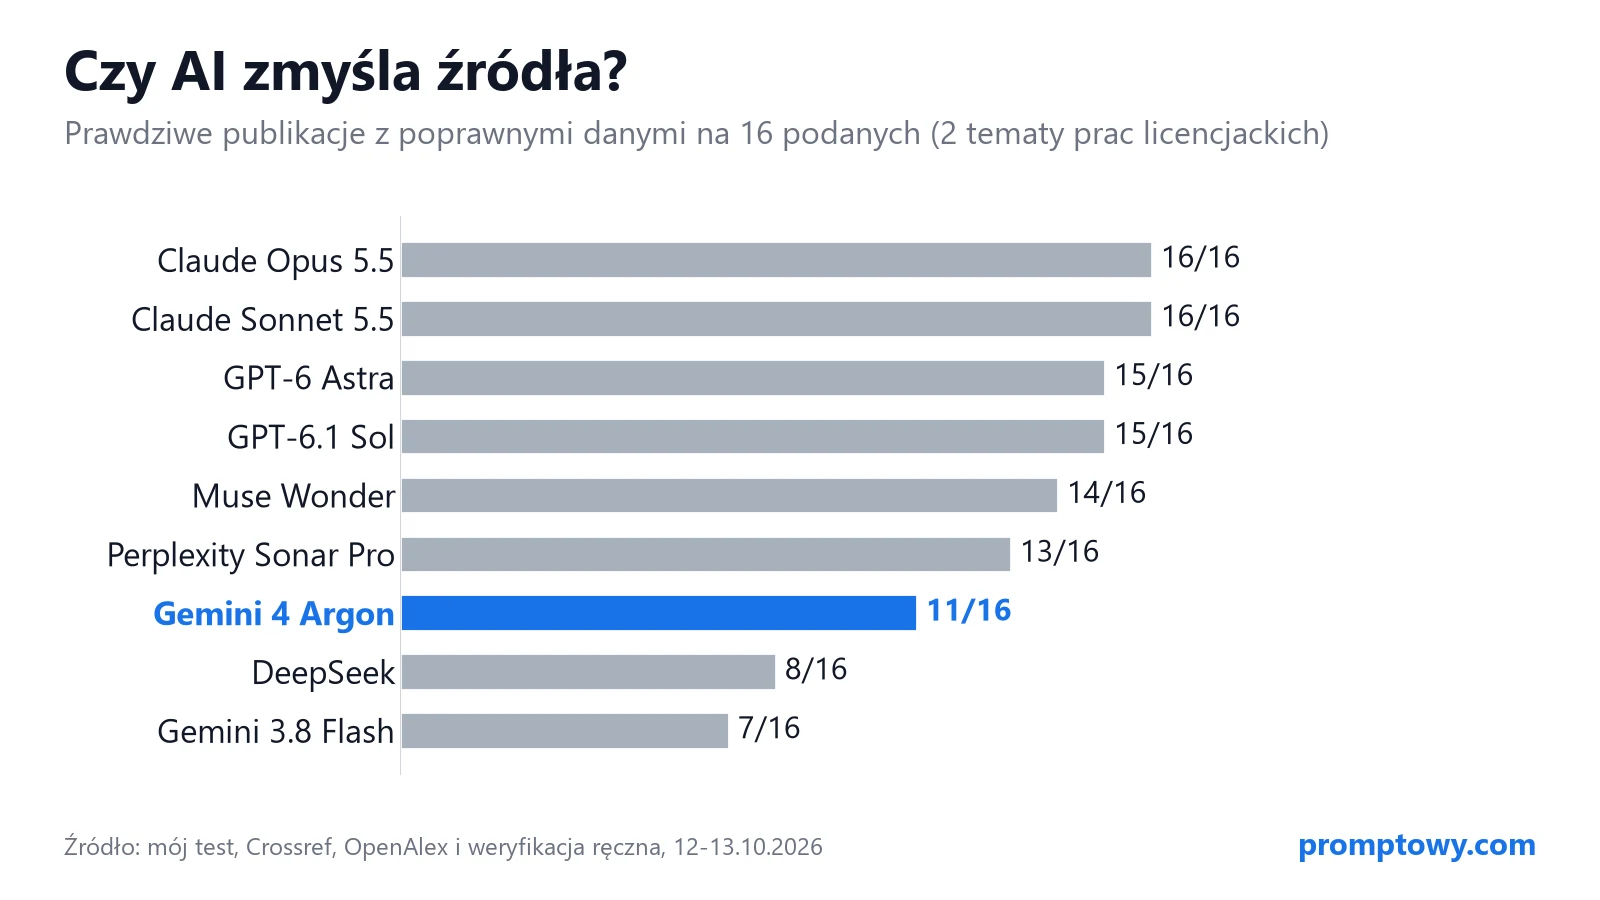
| Modèle | Exactes | Erronées | Inventées |
|---|---|---|---|
| Claude Opus 5.5 | 16 | 0 | 0 |
| Claude Sonnet 5.5 | 16 | 0 | 0 |
| GPT-6 Astra | 15 | 1 | 0 |
| GPT-6.1 Sol | 15 | 1 | 0 |
| GPT-6 Luna | 15 | 1 | 0 |
| Claude Haiku 5.5 | 15 | 1 | 0 |
| Muse Wonder | 14 | 1 | 1 |
| Perplexity Sonar Pro | 13 | 2 | 1 |
| Gemini 4 Argon | 11 | 3 | 2 |
| DeepSeek | 8 | 0 | 8 |
| Gemini 3.8 Flash | 7 | 2 | 7 |
Face à Gemini 3.8 Flash, qui avait inventé 7 références sur 16, Argon marque un progrès net. Mais tous les modèles haut de gamme d’Anthropic, d’OpenAI et de Meta ont obtenu de meilleurs résultats, tout comme Claude Haiku 5.5 et GPT-6 Luna, pourtant moins coûteux. Perplexity Sonar Pro, qui effectue des recherches sur Internet, a lui aussi inventé une référence : la présence d’un moteur de recherche dans un modèle ne dispense donc pas de vérifier les résultats.
Contraste intéressant : selon Artificial Analysis, Argon affiche un faible taux d’hallucination dans le test AA-Omniscience (15 %, contre 51 % pour GPT-6 Astra), car il préfère plus souvent refuser de répondre plutôt que de deviner. Dans mon test, il n’a refusé que pour les DOI, tandis qu’il a fourni avec assurance les titres d’articles polonais. Autre point : OpenRouter n’a détecté aucun jeton de raisonnement pour Argon, alors que Claude Opus 5.5 en a consommé plus de mille pour chaque sujet. Je ne sais pas si cela explique l’écart, mais j’en tiendrais compte au moment de choisir les paramètres.
Comment vérifier les références fournies par une IA
Si vous rédigez un travail universitaire ou un mémoire, considérez la bibliographie générée par l’IA comme une liste de pistes, et non comme une bibliographie prête à l’emploi. Voici comment je vérifie chaque référence :
- DOI : collez le numéro sur doi.org ou dans Crossref Search. Il doit renvoyer exactement au titre indiqué, et non à un autre article.
- Titre : recherchez-le entre guillemets dans Google Scholar. Vérifiez aussi le prénom de l’auteur, l’année et la revue : ce sont les éléments sur lesquels Argon s’est trompé.
- Publications polonaises : Crossref ne les référence pas toujours. Dans mon test, la recherche automatique dans Crossref n’a trouvé aucun des articles polonais proposés par Argon ; OpenAlex a trouvé l’article de Borys Martela, et j’ai vérifié les autres manuellement. Pour les travaux polonais, consultez BazEkon (économie, finance et collectivités locales) et CEJSH (sciences sociales et humaines). Pour les rapports de fondations et d’instituts, consultez leurs sites.
- Contenu : ne citez que ce que vous avez consulté, même s’il ne s’agit que du résumé. Des métadonnées exactes ne prouvent pas que l’article affirme ce que l’IA lui attribue.
Je présente d’autres méthodes dans ce guide : Hallucinations de l’IA : comment s’en prémunir.
Verdict
Gemini 4 Argon invente moins de références que Gemini 3.8 Flash et ne fabrique pas de DOI, mais il s’est trompé sur cinq références polonaises sur huit. Sur le sujet de psychologie, fondé sur des recherches en anglais, il n’a commis aucune erreur. Pour une bibliographie polonaise, je choisirais Claude Opus 5.5 ou Sonnet 5.5, tout en vérifiant chaque référence. C’est mon avis à partir d’un seul passage du test portant sur deux sujets. Je parle aussi de la qualité du polonais d’Argon dans l’article Gemini 4 Argon en polonais, et j’ai décrit le même test de références pour le modèle de Meta dans le test de Muse Wonder.
Questions fréquentes
Gemini 4 Argon invente-t-il des sources ?
Parfois. Dans mon test, il a inventé 2 publications sur 16 et fourni des informations incorrectes pour 3 autres, par exemple un mauvais prénom d’auteur. Toutes les erreurs concernaient la littérature scientifique polonaise.
Argon donne-t-il des DOI exacts ?
Oui. Les sept DOI fournis étaient réels et correspondaient aux titres. Lorsqu’il ne connaissait pas un numéro, il a indiqué qu’il ne pouvait pas le vérifier.
Quel modèle invente le moins de références ?
Dans mon test, Claude Opus 5.5 et Claude Sonnet 5.5 : 16 références exactes sur 16 pour chacun.
Sources
- Mon test de références inventées via OpenRouter, 12-13.10.2026 (google/gemini-4-argon et 10 autres modèles), vérification dans Crossref et OpenAlex, complétée par des vérifications manuelles
- OpenRouter : google/gemini-4-argon
- Artificial Analysis : Gemini 4 Argon
- Crossref Search
- OpenAlex
- CEJSH : The Central European Journal of Social Sciences and Humanities
- BazEkon
More on this from PROMPTIF