Lip Sync AI Test : OmniHuman 2 vs Kling, H3 Max et Fabric
J'ai comparé la synchronisation labiale d'OmniHuman 2.0 face à quatre modèles concurrents sur les mêmes visages et pistes audio. OmniHuman 2 et H3 Max se hissent en tête, avec des profils très différents.
👁 128 lectures
Prenez un même portrait généré par IA, appliquez la même piste audio parlée et soumettez l’ensemble à cinq architectures de lip sync capables de créer un avatar IA vidéo animé : OmniHuman 2.0 de ByteDance, son prédécesseur OmniHuman 1.5, Kling AI Avatar v2, MiniMax H3 Max Lip Sync et VEED Fabric 1.0. Au 20 octobre 2026, mes mesures placent OmniHuman 2.0 et H3 Max Lip Sync au premier rang avec 8,5/10. H3 Max s’est révélé plus de dix fois plus rapide et deux fois moins cher, mais il recadre le ratio en 4:3. Kling bougeait à peine les lèvres, tandis qu’OmniHuman 1.5 continuait d’exhiber ses dents pendant les silences.
Ce comparatif s’inscrit dans ma série de tests de modèles récents sur fal.ai, dont vous retrouverez l’ensemble des benchmarks dans mon hub dédié à FLUX 3 Max ainsi que dans le Labo Promptif regroupant tous mes essais indépendants.
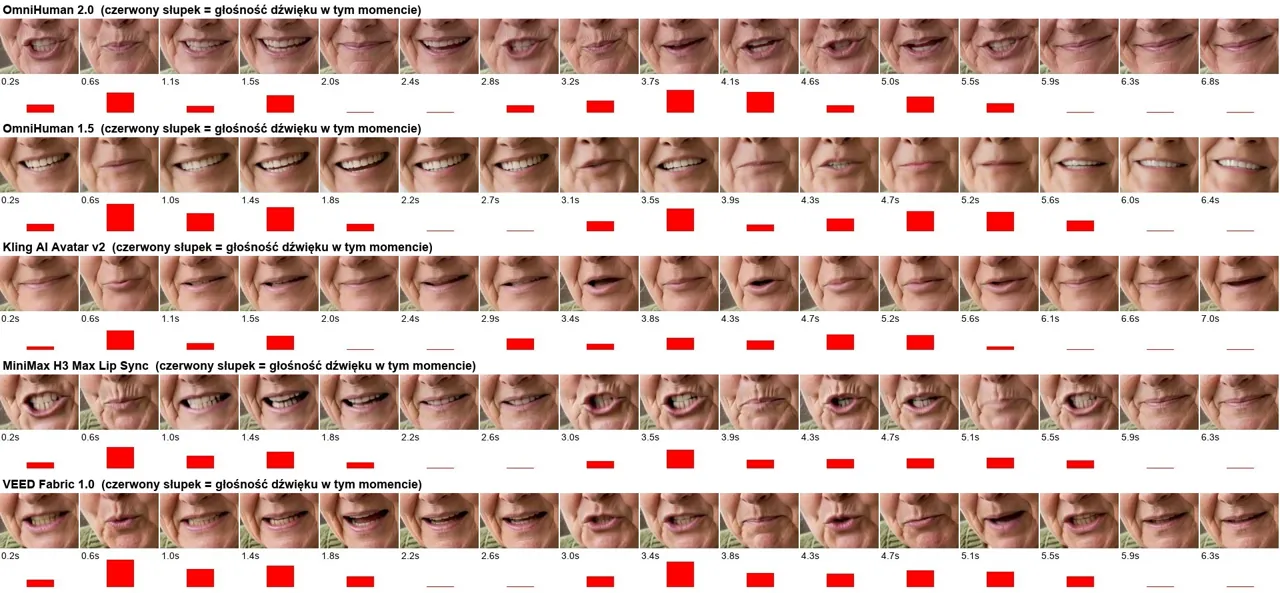
Résultats de mon banc d’essai lip sync
Pour cette confrontation, le point de départ était identique pour chaque outil : un portrait d’une femme de 62 ans généré par mes soins sur FLUX 3 Image (aucun visage réel) et un fichier audio TTS en polonais (« Dzień dobry, jestem Halina. Dziś pokażę wam pierogi ruskie mojej babci », 6,5 secondes). Aucun prompt textuel additionnel n’a été fourni, les paramètres par défaut ont été conservés et j’ai sélectionné la résolution de base lorsqu’une option existait. Tous les appels ont été passés via l’API fal.ai.
| Modèle | Note | Temps de calcul | Coût du clip |
|---|---|---|---|
| OmniHuman 2.0 | 8,5 | 2,5-3 min* | 0,74 USD |
| MiniMax H3 Max Lip Sync | 8,5 | 12 s | 0,35 USD |
| VEED Fabric 1.0 | 7,0 | 22 s | 0,56 USD |
| OmniHuman 1.5 | 6,5 | 3,5 min | 1,12 USD |
| Kling AI Avatar v2 Standard | 6,0 | 5 min | 0,40 USD |
* Temps constaté sur cinq générations d’OmniHuman 2.0. Ce clip précis a subi une file d’attente de plus de 20 minutes sur fal.
Mon barème sur 10 points analyse si la bouche s’ouvre sur chaque syllabe et se ferme dans les silences, la présence d’artefacts sur les lèvres et les dents, ainsi que le naturel des mouvements de tête. Un second test sur un portrait masculin urbain avec un virelangue difficile a confirmé cette hiérarchie : OmniHuman 2.0 à 8,5, H3 à 8,5 et Kling à 6,5.
Vidéos générées lors du comparatif
Ce que révèle ce comparatif
- OmniHuman 2.0 progresse nettement face à la v1.5 : la gestion des silences est bien meilleure et le tarif sur fal diminue d’un tiers (0,105 USD la seconde contre 0,16 USD auparavant).
- H3 Max Lip Sync offre le meilleur ratio vitesse, prix et précision : 12 secondes de calcul et 0,05 USD par seconde en 480P. Son compromis majeur reste le recadrage : un portrait en 3:2 ressort en 4:3 avec un zoom sur le visage. À noter que H3 Max est une variante post-entraînée par fal et non l’offre de base brute du fournisseur.
- Kling AI Avatar v2 préserve parfaitement le visage et l’arrière-plan, mais l’amplitude labiale insuffisante dégrade le réalisme.
- L’audio polonais a été accepté par tous les modèles : les écarts observés relèvent de la mécanique d’animation labiale, pas de la langue source.
Zoom sur OmniHuman 2.0 : test approfondi sur 5 personnages
Lancé le 15 octobre 2026 par BytePlus et intégré le jour même à l’API fal.ai, OmniHuman 2.0 de ByteDance promet selon l’éditeur d’adapter les lèvres, les expressions et les gestes au contenu du signal audio. Le modèle gère la voix, le chant et accepte des invites de texte pour orienter la caméra. J’ai évalué ses performances sur cinq portraits générés par IA avec des fichiers vocaux TTS distincts contenant des phonèmes complexes.
| Personnage | Phrase testée | Note | Coût API |
|---|---|---|---|
| Femme de 62 ans | « Dziś pokażę wam pierogi ruskie… » | 8,5 | 0,74 USD |
| Jeune homme urbain | « W Szczebrzeszynie chrząszcz brzmi w trzcinie. » | 8,5 | 0,66 USD |
| Présentatrice de JT | « Na drogach ślisko, a w Tatrach spadł pierwszy śnieg. » | 8,5 | 0,69 USD |
| Agriculteur en extérieur | « Źdźbła wysokie, ziarno ciężkie. » | 8,0 | 0,79 USD |
| Renard cartoon 3D | « Gżegżółka, źrebię i żaba to moi przyjaciele! » | 8,5 | 0,73 USD |
Le modèle évite l’effet de masque statique posé sur une image : les épaules et la tête accompagnent l’élocution. En contrepartie, le temps de rendu s’étire (2,5 à 3 minutes par vidéo courte) et l’analyse devient moins précise sur un plan moyen.
Tarifs et coûts d’un avatar IA vidéo
Les tarifs dépendent de la plateforme d’exécution choisie. fal facture chaque seconde générée, en sachant que le fichier final dépasse souvent légèrement la durée de l’audio (une piste de 6,5 s produit environ 7 s de vidéo). BytePlus mentionne de son côté un tarif de 0,07 USD par seconde pour OmniHuman 2, mais affiche également 0,12 USD par seconde sur certaines options d’avatars avec lip sync.
| Durée de la vidéo | BytePlus (0,07 USD/s) | fal.ai (0,105 USD/s) |
|---|---|---|
| 30 secondes | 2,10 USD | 3,15 USD |
| 60 secondes | 4,20 USD | 6,30 USD |
| 5 minutes | 21,00 USD | 31,50 USD |
Pour un panorama complet des nouveautés du mois, consultez mon récapitulatif des nouveaux modèles sur fal.ai d’octobre 2026. Si vous recherchez des moteurs capables de produire directement de la parole et de l’image conjointe sans fichier audio préalable, j’ai testé ces solutions dans mon comparatif de générateurs vidéo.
Quel modèle de lip sync AI choisir ?
- Pour un avatar complet et des séquences longues (jusqu’à 5 min) : OmniHuman 2.0 offre le mouvement le plus organique du haut du corps.
- Pour des gros plans rapides et économiques : MiniMax H3 Max Lip Sync est imbattable sur le temps de calcul, sous réserve d’accepter son recadrage en 4:3.
- Éthique et transparence : ne soumettez jamais la photo d’un tiers sans son accord formel, et signalez systématiquement à votre audience que la séquence a été synthétisée par une IA.
Foire aux questions
Quel modèle de lip sync s’est montré le plus précis ?
Dans mes benchmarks du 20 octobre 2026, OmniHuman 2.0 et MiniMax H3 Max Lip Sync arrivent ex æquo avec une note de 8,5/10, dominant nettement Kling et OmniHuman 1.5 sur la précision labiale.
Combien coûte une minute d’animation parlée via API ?
Sur fal.ai, les tarifs à la minute s’établissent à 3,00 USD pour H3 Max Lip Sync (en 480P), 3,37 USD pour Kling AI Avatar v2 Standard, 4,80 USD pour VEED Fabric (480p), 6,30 USD pour OmniHuman 2.0 et 9,60 USD pour OmniHuman 1.5.
Peut-on animer la photo d’une personne réelle ?
Techniquement oui, mais cela exige impérativement le consentement de la personne concernée ainsi qu’une mention explicite indiquant que la vidéo est générée par IA. Pour mes bancs d’essai, j’utilise exclusivement des visages fictifs générés par modèle graphique.
Sources
- Mesures et générations indépendantes réalisées le 20.10.2026 : 11 clips de lip sync traités via l’API fal.ai.
- Documentation fal.ai et fiches tarifaires : OmniHuman v2, OmniHuman 1.5, Kling AI Avatar v2, H3 Max Lip Sync, VEED Fabric 1.0 (relevé du 20.10.2026).
- BytePlus : Annonce officielle du lancement d’OmniHuman 2.0 (15.10.2026).
- BytePlus : Page produit OmniHuman 2.0 et Documentation de l’API (mise à jour du 15.10.2026).
More on this from PROMPTIF



 outils d'ia·Kimi K3.1 Pro face à Claude Opus 5.5 et GPT-6 Astra : test complet en français (2026)J'ai soumis Kimi K3.1 Pro à 12 tâches rédigées en français face à Claude Opus 5.5, GPT-6 Astra et quatre autres modèles.