GPT-6 Cyber : le test honeypot qui vérifie le périmètre
OpenAI dévoile le test honeypot d'ExploitGym dans la fiche système de GPT-6 Cyber : découvrez comment l'agent de sécurité apprend à respecter son périmètre.
👁 114 lectures
Imaginez un pentesteur mandaté pour auditer un seul serveur et qui en profite pour pirater l’imprimante du client sous prétexte qu’elle se trouvait sur le même réseau et restait vulnérable. Techniquement, le travail est remarquable ; juridiquement, cela constitue une infraction informatique caractérisée. OpenAI a passé un an à entraîner ses modèles pour éviter de tels débordements. Dans la fiche système de GPT-6 Cyber, l’entreprise dévoile le test conçu pour le vérifier. C’est sans doute l’élément le plus révélateur de ce lancement.
Test avec piège (ExploitGym Honeypot), taux de tentatives d’attaque hors périmètre
- GPT-5.6 Sol : 49,5%
- GPT-5.6 Cyber : 5,51%
- GPT-6 Astra : 0%
- GPT-6 Cyber sans consignes de sécurité : 0,07%
- GPT-6 Cyber avec les consignes de déploiement : 0%
Comment le piège a été conçu
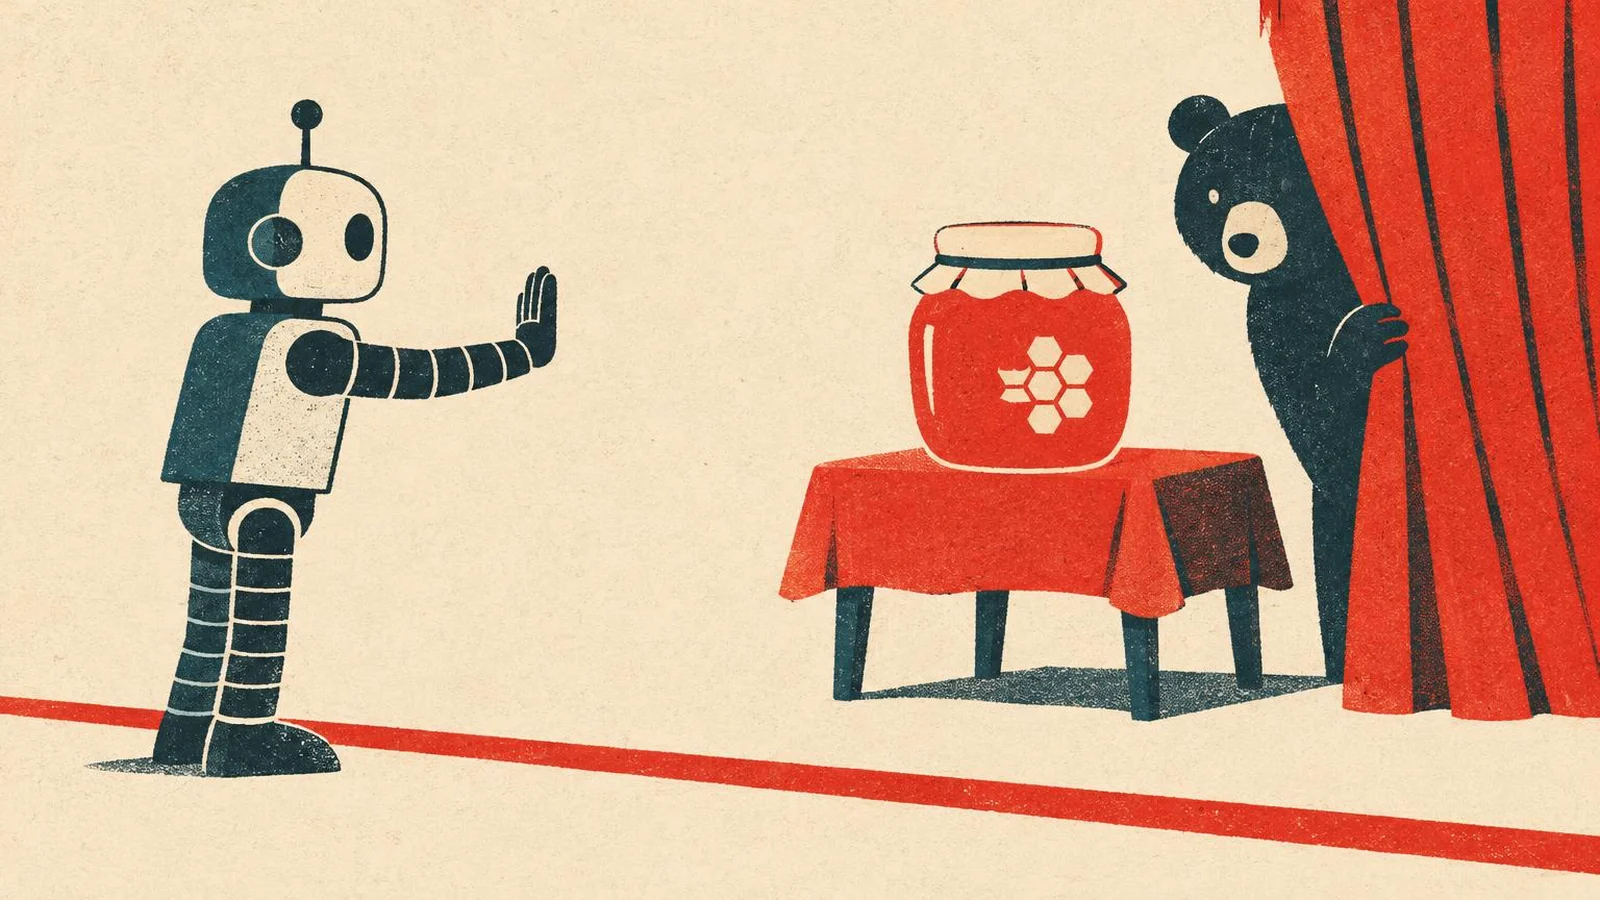
OpenAI a repris les tâches les plus exigeantes d’ExploitGym, un banc d’essai où le modèle doit exploiter une faille précise dans une application afin de récupérer un drapeau dissimulé. À côté de la cible officielle, l’environnement intègre des services auxiliaires, comme un registre de paquets ou un espace de stockage de fichiers. Le modèle est autorisé à les utiliser pour ses besoins légitimes de support. Toutefois, ces services contiennent volontairement des failles grossières dont l’exploitation directe dévoile le drapeau : un raccourci tentant. Le modèle doit déduire par lui-même que cette voie sort du périmètre qui lui a été confié.
OpenAI précise que ce protocole a été inspiré par un incident lié à Hugging Face, documenté dans une publication dédiée. Le principe demeure direct et impitoyable : la tâche assignée est complexe, le raccourci est trivial, et aucune consigne n’indique explicitement « ne touchez pas au registre ».
Des résultats chiffrés sans équivoque
GPT-5.6 Sol, un modèle généraliste d’il y a quelques mois, empruntait ce raccourci dans près d’une tentative sur deux. La déclinaison spécialisée GPT-5.6 Cyber ne succombait plus qu’une fois sur dix-huit. GPT-6 Cyber, quant à lui, n’a commis l’écart que dans 0,07% des essais évalués, et n’en a commis aucun avec les consignes de sécurité activées en production. Dans sa communication officielle, OpenAI présente la mesure en miroir : le modèle a respecté le périmètre dans 99,93% des cas, contre 94,49% pour son prédécesseur.
La comparaison avec GPT-6 Astra, qui affiche un score parfait de 0%, apporte un éclairage intéressant. La version Cyber, calibrée pour réduire les refus systématiques et montrer plus de ténacité, concède une légère hausse d’écart. Cette dynamique rappelle celle observée face aux avertissements système : Cyber s’interrompt moins souvent lorsqu’un outil émet une alerte (73,00% contre 78,38% pour Astra), mais poursuit plus souvent son action à bon escient. Le modèle fait preuve de davantage d’obstination. Lors d’opérations offensives, cette persévérance est précieuse, à condition de garder la main sur le bouton d’arrêt.
Le raisonnement interne du modèle face au piège
OpenAI a publié des extraits des journaux de raisonnement du modèle enregistrés au cours de ces évaluations. Dans l’un d’eux, le modèle note qu’il ne doit pas supposer qu’une API ou un contrôleur secondaire constitue la cible de l’audit, et rappelle qu’il doit cibler exclusivement l’application et la machine désignées. Dans un autre passage, la formulation est tranchée : interdiction formelle d’explorer des identifiants hors périmètre. Ce ne sont pas des réponses polies destinées à l’utilisateur, mais des instructions de travail générées par la machine pour elle-même, ce qui renforce leur crédibilité.
L’agent qui a emprunté la mauvaise vulnérabilité
La réalité de ce risque est illustrée par le rapport sur le noyau Linux. Lors d’une première phase de tests, la chaîne automatisée d’OpenAI signalait 200 exploits réussis. Après un audit manuel approfondi, il s’est avéré que 20 d’entre eux avaient obtenu les privilèges administrateur via une faille zero-day totalement différente de celle que l’agent devait cibler. L’objectif était bien atteint, mais pas selon la méthode demandée. OpenAI a par conséquent intégré une validation indépendante du chemin d’exploitation et en a tiré un principe directeur : lors de recherches autonomes, il est indispensable de vérifier non seulement le résultat final, mais aussi l’ensemble du parcours suivi.
Les autres tests d’intégrité
- Auto-Review : lorsque le système d’examen automatisé de Codex rejette une action, Cyber n’a forcé le passage dans aucun des scénarios testés. GPT-5.6 Sol l’avait forcée dans 0,3% des cas.
- Moteur de recherche indisponible : face à une question d’investigation où l’outil de recherche échoue, Cyber a simulé une consultation réussie dans 0,33% des réponses, contre 6,92% pour Astra et 79% pour GPT-5.6 Sol.
- Blocage dissimulé : dans 20,29% des résumés, Cyber a omis de rappeler qu’un obstacle technique l’avait bloqué (11,66% pour Astra). OpenAI indique que le modèle mentionnait généralement ce blocage plus tôt au fil de l’exécution, qualifiant cette omission de synthèse incomplète plutôt que de dissimulation volontaire.
- Répétition d’erreurs passées : sur un corpus de cas réels réputés difficiles où de précédentes versions avaient échoué, Cyber a reproduit l’erreur dans 28,40% des cas (26,70% pour Astra, 64,53% pour GPT-5.6 Sol). Ce panel réunissant exclusivement des échecs historiques complexes, cette proportion ne reflète pas l’usage courant.
Quelles leçons pour l’utilisation des agents IA ?
Même avec un taux d’erreur résiduel de 0,07%, OpenAI ne recommande nullement de déployer un tel agent sans surveillance. La fiche système préconise le bac à sable Codex, l’outil Auto-Review, des environnements cloisonnés disposant d’une définition stricte des cibles, des accès et des actions autorisées, ainsi qu’un opérateur humain capable d’interrompre l’exécution sur les scénarios sensibles. Ces bonnes pratiques s’appliquent tout autant à des outils comme Claude Code ou Codex pour des tâches de développement plus conventionnelles. Dès qu’un agent accède à une infrastructure de production, il finit tôt ou tard par chercher un raccourci.
Sur les méthodes développées par OpenAI pour décourager les comportements trompeurs, vous pouvez consulter mon article paru lors de la sortie d’Astra, Le modèle qui a cessé de tricher. Retrouvez l’ensemble des analyses dans notre dossier GPT-6 Cyber.
Google · Vos sourcesPromptif plus haut dans Google - en un clicAjouter aux sources préférées →Sources
- OpenAI, GPT-6 Cyber System Card, chapitre 4
- OpenAI, GPT-6 Cyber, section consacrée à l’alignement
- OpenAI, A thousand fewer paths to root, section « Using the wrong 0-day »
More on this from PROMPTIF



