Muse Wonder vs Opus 5.5 et GPT-6 Astra : le comparatif sur 23 tests
Nous avons comparé Muse Wonder à Claude Opus 5.5, GPT-6 Astra et Gemini Flash sur 23 épreuves réelles. Coûts, temps de réponse et résultats détaillés.
Mise à jour (9 novembre 2026) : Claude Fable 5.2 et Mythos 5.2 sont sortis - prix, accès et benchmarks dans mon guide Claude Fable 5.2.
👁 119 lectures
Nous avons soumis Muse Wonder et quatre modèles concurrents aux mêmes 23 épreuves pratiques : comportement d’agent avec outils, génération de code vérifié par des tests unitaires, rédaction administrative (testée en polonais), logique pure et analyse de documents de 47 000 à 88 000 tokens. Les résultats s’avèrent plus instructifs que les benchmarks officiels de Meta : sur ces tâches concrètes, les cinq modèles affichent un taux de réussite quasi parfait de 99 à 100 %. Les véritables écarts se situent au niveau de la facture, de la vitesse d’exécution et de quelques bévues isolées. Muse Wonder s’impose comme le deuxième plus économique et le deuxième plus rapide du groupe. Retrouvez ci-dessous l’ensemble des données, graphiques et analyses, ainsi que la présentation détaillée de l’architecture dans notre guide Muse Wonder.
Conditions du banc d’essai (12 octobre 2026, session du soir)
- Modèles évalués : Muse Wonder, Claude Opus 5.5, Claude Fable 5.1, GPT-6 Astra, Gemini 3.8 Flash. Tous interrogés via OpenRouter, avec un niveau de raisonnement configuré sur « low ».
- 23 tâches exécutées en deux séries, avec notation automatisée (tests unitaires, vérification de la syntaxe des appels d’outils, correspondances strictes), sans intervention d’un juge IA.
- Épreuve dédiée aux hallucinations bibliographiques : 16 références demandées par modèle, recoupées dans Crossref et OpenAlex.
- Coût global du banc d’essai : 5,04 USD. Journaux d’appels et réponses intégrales conservés.
Résultats du comparatif en un tableau
| Modèle | Score global (23 tâches) | Coût API | Temps total | Sources réelles | Erreurs relevées |
|---|---|---|---|---|---|
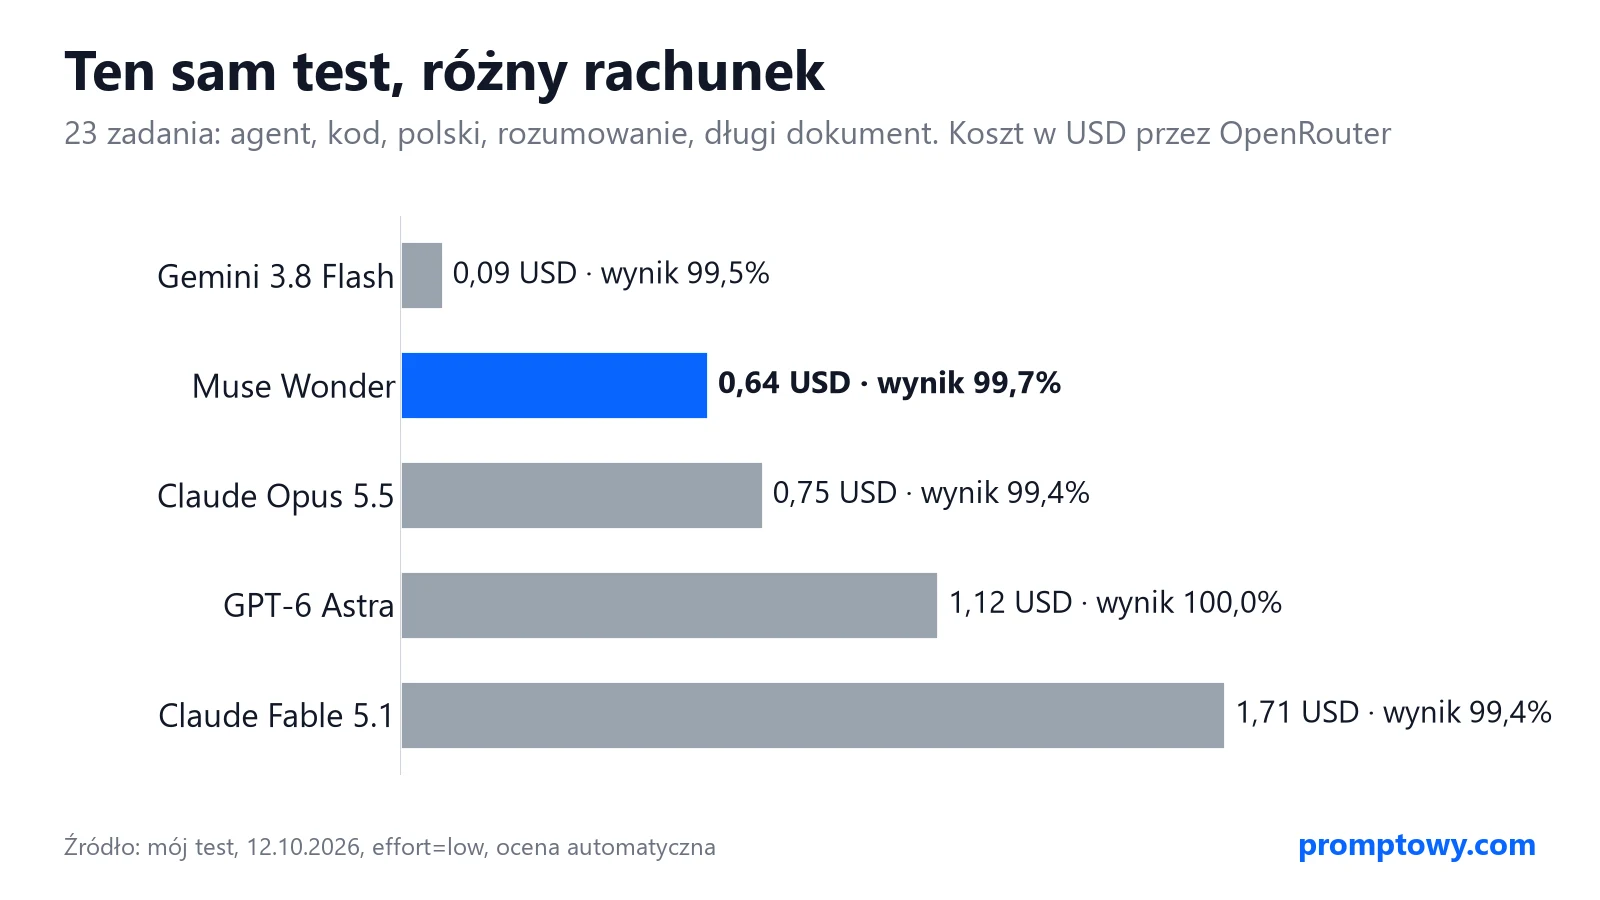
| Muse Wonder | 99,7% | 0,64 USD | 165 s | 16/16 | coquille lexicale dans le code (« trzynadzieście ») |
| Claude Opus 5.5 | 99,4% | 0,75 USD | 222 s | 16/16 | dépassement de la limite de mots sur un résumé |
| Claude Fable 5.1 | 99,4% | 1,71 USD | 263 s | 16/16 | dépassement de la limite de mots sur un résumé |
| GPT-6 Astra | 100% | 1,12 USD | 200 s | 16/16 | aucune |
| Gemini 3.8 Flash | 99,5% | 0,09 USD | 139 s | 7/16* | jour férié appliqué à tort dès 2024 |
Le score représente la moyenne arithmétique des 23 épreuves, à pondération identique (les exercices à critères multiples comptabilisent le pourcentage d’exigences validées). * Le résultat de Gemini 3.8 Flash sur les sources provient de notre mesure antérieure du 12 octobre, réalisée avec la même consigne.
Le protocole de test en détail
| Catégorie | Exercices pratiques | Critères d’évaluation |
|---|---|---|
| Agent autonome avec outils | planification de séjour (3 outils, 4 contraintes, pièges tarifaires), gestion d’un retour client (refus automatique hors délai), conversion comptable de factures avec gestion d’une panne réseau au premier appel | conformité des appels d’outils, sélection logique, justesse des montants calculés |
| Développement logiciel | validation d’identifiant fiscal, fusion d’intervalles, calcul de jours ouvrés incluant de nouveaux jours fériés, transcription d’un montant numérique en toutes lettres | batterie de tests unitaires exécutés localement (8 à 19 cas par problème) |
| Traitement linguistique (testé en polonais) | correction de 10 fautes complexes, synthèse sous contrainte stricte de 60 mots, rédaction d’un recours officiel, accords grammaticaux délicats | grille de contrôle factuelle et respect strict des règles de forme |
| Raisonnement logique | 11 énigmes à issue unique (combinatoire, calculs de dates, logique de menteurs et chevaliers) | exactitude de la réponse |
| Analyse documentaire longue | 80 comptes-rendus de séances de direction, 5 questions ciblées incluant une décision révoquée et une recherche sur un élément absent du texte | justesse documentaire rigoureuse |
Tâches concrètes : les modèles haut de gamme au coude-à-coude
Sur l’épreuve de planification de voyage, les cinq modèles ont exploité les outils en parallèle (4 exécutions réparties sur 2 tours d’échange), ont su rejeter un vol trop matinal programmé à 6 h 05 ainsi qu’un hébergement mal noté (7,4/10), pour converger vers la même estimation financière (environ 445 USD). Concernant la procédure de retour marchandise, aucun n’a validé un dossier expédié après 32 jours. Face aux factures multidevises, tous ont relancé l’appel d’API après l’interruption simulée du service, écarté la créance déjà soldée et restitué le total exact (environ 3 900 USD). Enfin, tous ont relevé que la prétendue campagne TikTok était absente du volumineux dossier d’entreprise, tout en identifiant la révision de superficie d’un entrepôt intervenue dans un compte-rendu plus récent. C’est une excellente nouvelle pour les utilisateurs, mais un défi pour le marketing des laboratoires d’IA : sur des besoins quotidiens, l’écart de prix rémunère souvent l’image de marque plutôt que le gain opérationnel.
Où se sont faites les vraies différences
Coût : Muse Wonder moins cher qu’Opus pour le même prix par token
Muse Wonder et Claude Opus 5.5 affichent une tarification unitaire identique : 4 USD par million de tokens en entrée et 20 USD en sortie. Pourtant, Opus s’avère 18 % plus onéreux à l’usage. La raison tient au découpage en tokens sur les langues d’Europe centrale : le même texte représente 46 929 tokens pour Meta, 53 511 pour Gemini, 55 371 pour GPT-6 Astra, mais grimpe à 87 675 tokens pour les modèles d’Anthropic. Le tokenizer de Claude fragmente le texte bien davantage que celui de Meta. Sur de longs corpus, l’écart pèse lourd sur votre budget API : une simple requête posée sur les 80 comptes-rendus a coûté 0,19 USD avec Muse Wonder, contre 0,35 USD avec Opus 5.5 et 0,88 USD avec Fable 5.1.
| Modèle | Tokens comptabilisés pour le document | Coût d’une requête sur le dossier |
|---|---|---|
| Muse Wonder | 46 929 | 0,19 USD |
| Gemini 3.8 Flash | 53 511 | 0,04 USD |
| GPT-6 Astra | 55 371 | 0,69 USD |
| Claude Opus 5.5 | 87 675 | 0,35 USD |
| Claude Fable 5.1 | 87 675 | 0,88 USD |
Sur des prompts très courts, la dynamique s’inverse : Muse Wonder génère une réflexion interne soutenue même avec le paramètre de raisonnement réglé au plus bas (636 tokens de réflexion sur l’organisation de voyage, contre 46 pour Opus). Sur une requête ponctuelle et isolée, il peut donc revenir légèrement plus cher qu’Opus.
Temps de réponse
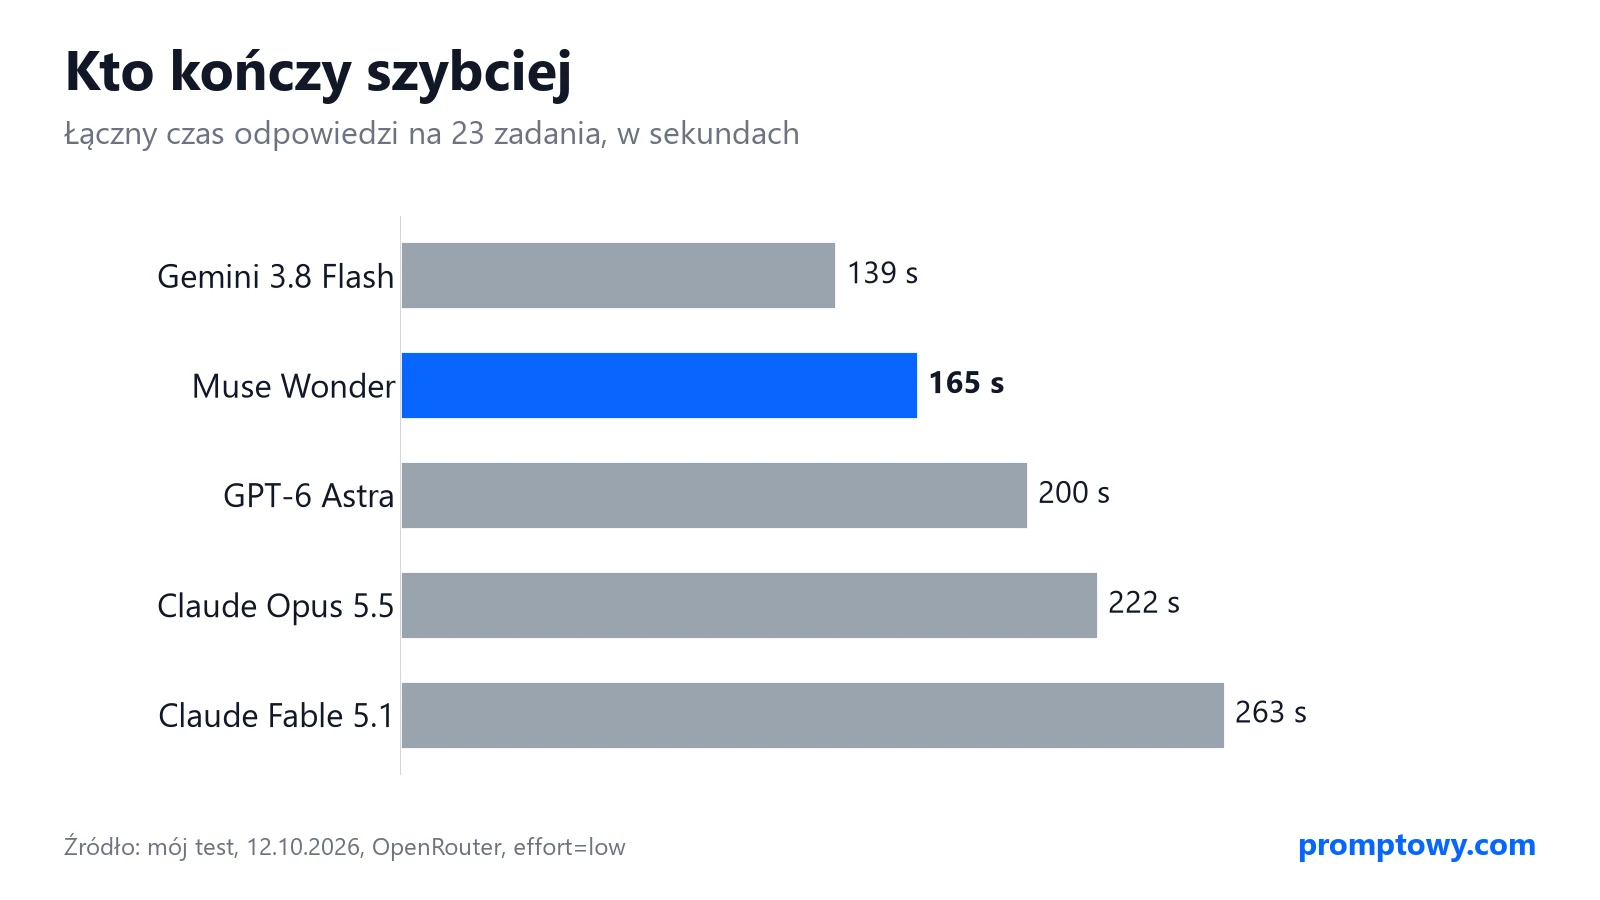
Fable 5.1 s’est révélé le plus lent de notre banc d’essai : il a mis 80 secondes pour rédiger un recours administratif, facturé 0,28 USD. Muse Wonder a rédigé le même document en 12 secondes pour 0,03 USD.
Les erreurs relevées lors des tests
- Muse Wonder : coquille lexicale dans le code. Dans sa fonction de conversion de devises en toutes lettres, le modèle a inséré un terme inexistant dans son tableau (« trzynadzieście » au lieu de « trzynaście » pour treize). 15 tests unitaires sur 16 ont fonctionné, mais un montant décimal s’est retrouvé déformé. Dans un système de facturation en production, l’anomalie ferait mauvais genre.
- Muse Wonder : date présumée dans un courrier. Lors de la rédaction d’un recours officiel, le modèle a inscrit de sa propre initiative la mention « 14 octobre 2026 », sans consigne préalable. Les autres modèles ont correctement laissé un champ vierge à renseigner. Aucun point n’a été retiré pour cela, mais une vérification humaine s’impose avant tout envoi.
- Claude Opus 5.5 et Fable 5.1 : consigne de longueur non respectée. La synthèse demandait un maximum de 60 mots. Ils en ont produit respectivement 62 et 66. Muse Wonder a respecté précisément la limite avec 60 mots, tandis que GPT-6 Astra en comptait 59.
- Gemini 3.8 Flash : confusion sur le calendrier légal. Il a traité le réveillon de Noël comme un jour férié pour l’ensemble des années testées, ignorant que cette mesure législative ne s’appliquait qu’à compter de 2025. Le scénario portant sur décembre 2024 a échoué.
Sources inventées : l’élite ne fabrique plus de références
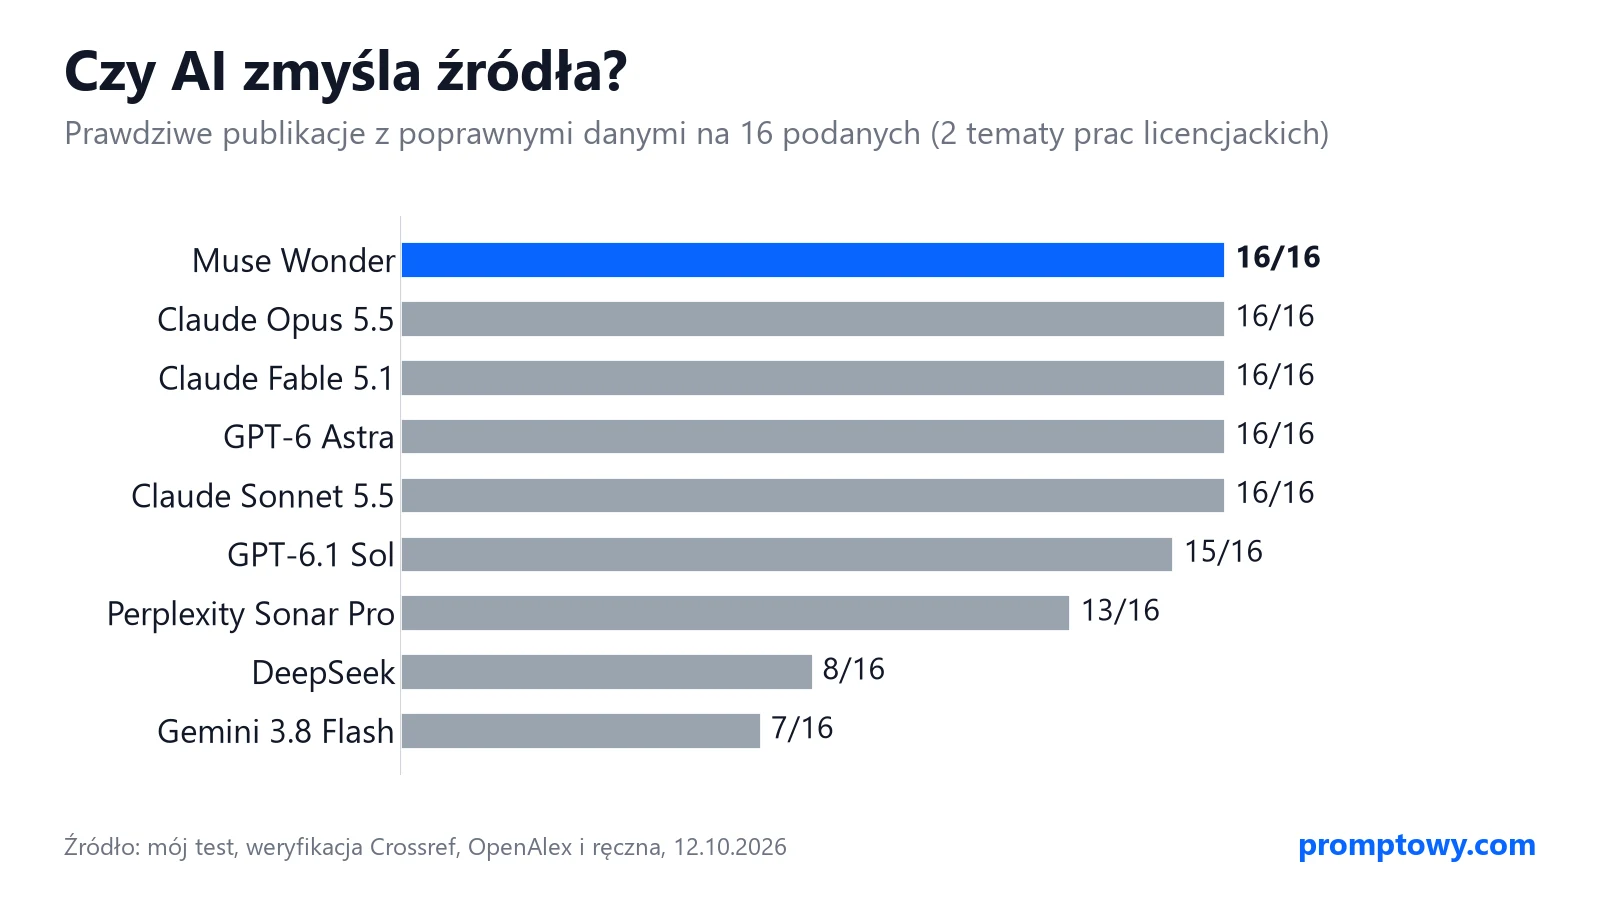
Nous avons demandé à chaque IA de fournir 8 publications scientifiques pour une bibliographie académique sur deux thèmes : l’impact des réseaux sociaux sur les adolescents et les mécanismes de budgets participatifs. Chaque titre a été recherché dans Crossref et OpenAlex. Pour les quatre publications absentes de ces index (deux rapports d’organismes civiques et un article paru dans la revue française Métropoles), nous avons procédé à une vérification manuelle. Toutes existent bel et bien. Muse Wonder, Opus 5.5, Fable 5.1 et Astra ont restitué 16 références véridiques sur 16. En revanche, le même prompt soumis à Gemini 3.8 Flash lors d’un test préliminaire n’a donné que 7 sources réelles, générant 7 hallucinations complètes sur le thème régional. Un modèle ultra-économique reste performant pour l’exécution pratique, mais reste peu fiable pour de la recherche documentaire rigoureuse.
Face aux benchmarks officiels de Meta
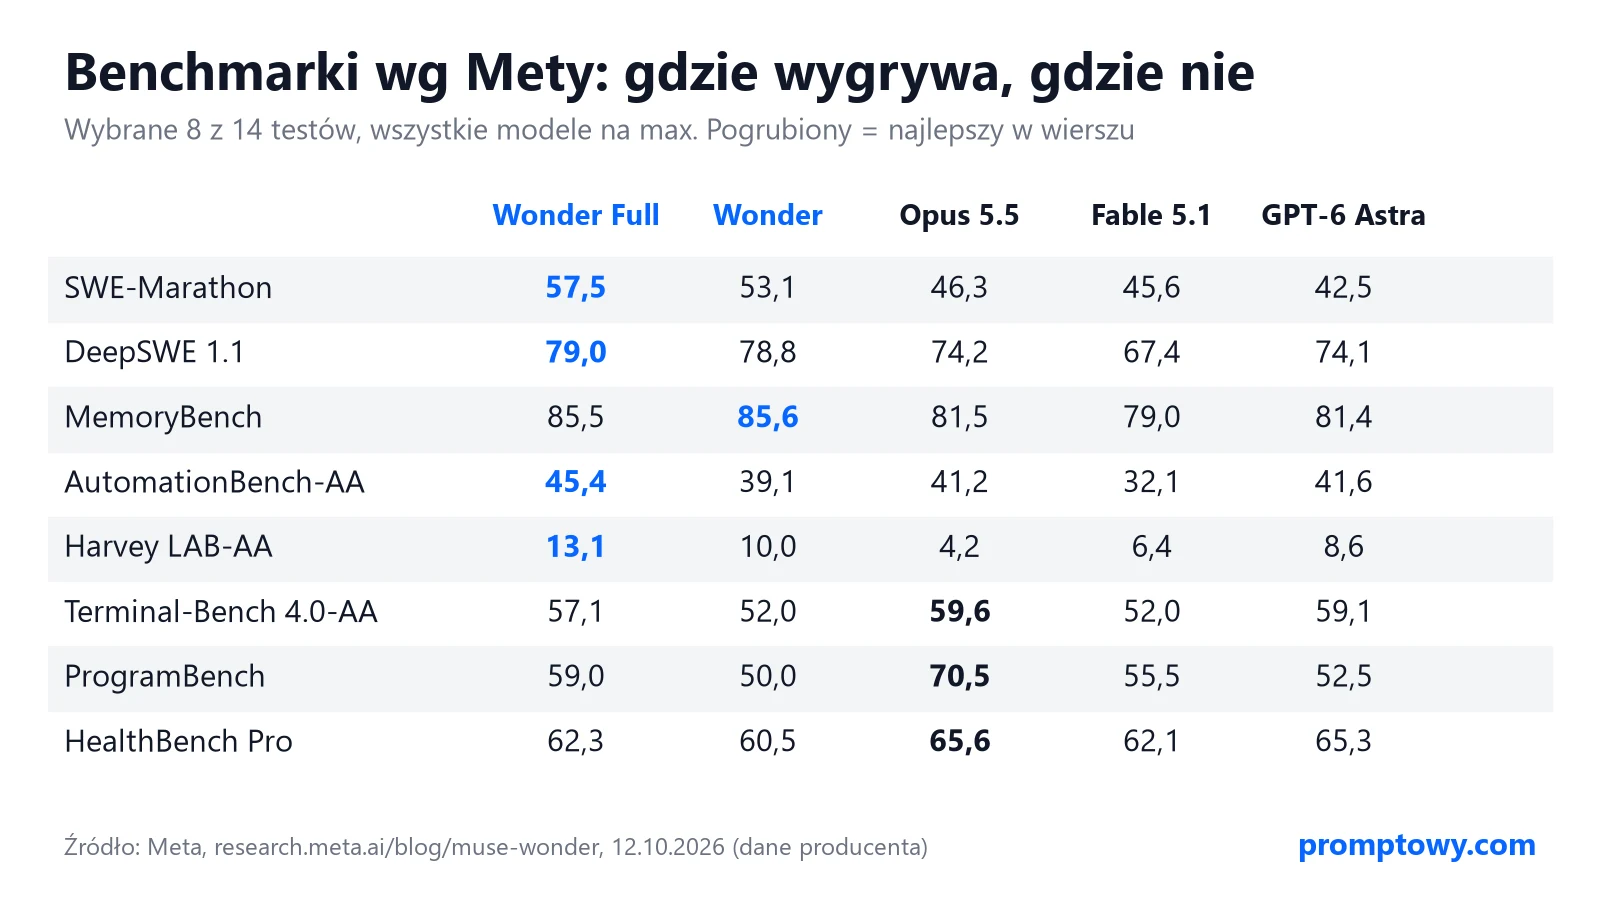
Dans sa documentation, Meta met en avant l’avantage de Muse Wonder Full sur les longs projets d’ingénierie logicielle et les flux d’agents complexes, tout en admettant un léger retrait face à Opus 5.5 sur des benchmarks comme ProgramBench, Terminal-Bench et HealthBench Pro. Notre banc d’essai s’est concentré sur la version standard de Muse Wonder accessible via l’API grand public : sur des épreuves de cette échelle, aucun modèle ne creuse un fossé décisif. En revanche, sur un test stylistique et rédactionnel évalué à l’aveugle, les nuances réapparaissent : Muse Wonder obtient 87,0 points, Opus 5.5 culmine à 90,1, Astra atteint 85,3 et Fable 5.1 reste à 83,9, comme détaillé dans notre banc d’essai dédié à l’écriture sur Muse Wonder.
Les limites de notre évaluation
- Une seule passe exécutée par scénario. Avec des scores compris entre 99 et 100 %, l’échec sur un test isolé relève de la marge d’aléa plutôt que d’une faiblesse structurelle.
- Raisonnement configuré au niveau « low » pour l’ensemble des systèmes afin d’équilibrer les temps de traitement et les dépenses API. En poussant la réflexion au maximum, les équilibres tarifaires évoluent.
- Les exercices reproduisent des cas d’usage métiers standard, sans pousser les modèles à leurs limites théoriques (projets logiciels de plusieurs heures, démonstrations mathématiques formelles). Pour ces analyses extrêmes, référez-vous à des classements indépendants comme Artificial Analysis.
- Notation automatisée : notre protocole sanctionne les faits objectifs et la structure syntaxique, sans juger de l’élégance du style littéraire.
Notre verdict
Si vous mobilisez l’IA via API pour des opérations professionnelles quotidiennes, Muse Wonder délivre un niveau d’exécution équivalent à Opus 5.5, Fable 5.1 ou GPT-6 Astra. Sur le traitement de documents textuels denses, son tokenizer particulièrement sobre permet de réaliser de substantielles économies. Malgré tout, Gemini 3.8 Flash conserve le rapport coût-performance le plus agressif de ce comparatif, pourvu que vous ne lui confiiez pas la recherche de sources bibliographiques.
Questions fréquentes
Quel modèle remporte ce banc d’essai ?
GPT-6 Astra obtient un sans-faute à 100 %, Muse Wonder le talonne à 99,7 %, Gemini 3.8 Flash affiche 99,5 %, tandis qu’Opus 5.5 et Fable 5.1 atteignent tous deux 99,4 %. Ces écarts minimes tiennent à des erreurs isolées et non à une supériorité technique flagrante.
Muse Wonder est-il moins cher que Claude Opus 5.5 ?
Le tarif affiché par million de tokens est identique. Cependant, Muse Wonder découpe certains textes en nettement moins de tokens que le moteur d’Anthropic. Pour exécuter nos 23 tâches, la facture s’élève à 0,64 USD pour Muse Wonder contre 0,75 USD pour Opus 5.5, avec un écart de 0,19 contre 0,35 USD sur une analyse de document volumineux.
Muse Wonder invente-t-il des sources académiques ?
Lors de notre test, aucune hallucination n’a été constatée : le modèle a fourni 16 publications universitaires authentiques et vérifiables sur 16 requêtes.
Sources et méthodologie
- Banc d’essai réalisé via OpenRouter le 12 octobre 2026 : 23 scénarios, effort=low, validation automatisée (scripts de tests unitaires, validation des schémas d’outils, correspondances strictes).
- Validation des références bibliographiques : recoupement sur Crossref et OpenAlex, complété par 4 vérifications manuelles sur les publications institutionnelles.
- Tarification en vigueur sur OpenRouter : catalogue des modèles.
- Données constructeur issues de Meta AI Research : Muse Wonder (benchmarks comparatifs).
- Classements globaux consultables sur Artificial Analysis : classements de performance.
More on this from PROMPTIF



 actualités·Muse Wonder prix : tarifs API et abonnementsDécouvrez les tarifs de Muse Wonder de Meta : prix API au million de tokens, options Muse Code et comparaison avec Claude, GPT-6 et Gemini.