Simon Willison contre le mythe de la réécriture from scratch
Le développeur et chercheur Simon Willison publie le 6 septembre 2026 un retour d'expérience détaillé sur les réécriture logicielles complètes, concluant qu'elles échouent presque systématiquement et que les refactorisations ciblées offrent de meilleures chances de succès.
👁 117 lectures
Simon Willison, développeur et auteur du framework Datasette, publie le 6 septembre 2026 un commentaire remarqué sur le mythe de la réécriture logicielle complète - une pratique qu’il juge rarement couronnée de succès dans sa carrière.
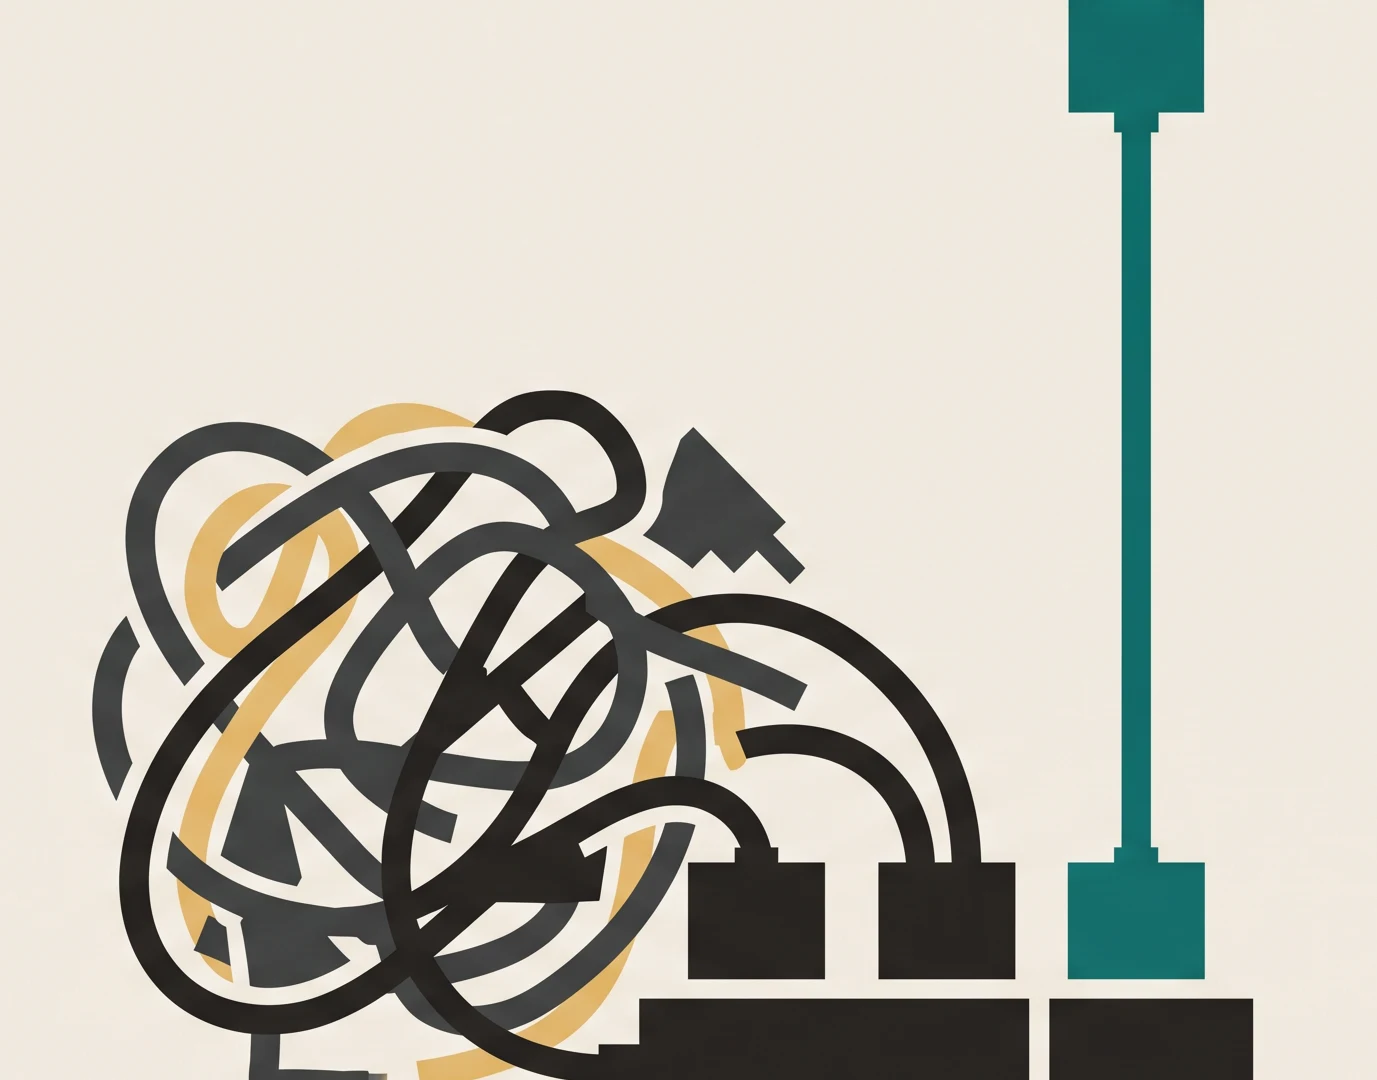
- Willison décrit un schéma récurrent : la réécriture from scratch aboutit souvent à deux systèmes en production au lieu d'un, sans jamais achever le remplacement.
- L'ancien système reste une cible mouvante pendant la réécriture, tandis que la nouvelle base de code accumule du code inactif représentant environ 80 % de sa taille.
- Sa recommandation : consolider l'ancien système avec des tests automatisés et procéder à des refactorisations ciblées plutôt que de tout réécrire.
Le point de départ est une discussion sur Lobsters autour d’un billet intitulé There’s No Limit to How Bad Code Can Get. Willison répond à l’idée répandue qu’il faut parfois «tout brûler et repartir de zéro» quand la dette technique devient écrasante. Son diagnostic est net : cette approche produit presque toujours deux systèmes en production là où il n’en existait qu’un.
Google · Vos sourcesPromptif plus haut dans Google - en un clicAjouter aux sources préférées →Le piège des deux systèmes parallèles
Le mécanisme est bien documenté dans son commentaire. Dès l’annonce de la réécriture, l’ancien système continue de faire tourner l’entreprise et doit donc évoluer. Mais les développeurs qui le maintiennent savent qu’il sera bientôt remplacé - ils n’ont aucune incitation à fournir plus que le minimum syndical pour chaque nouvelle fonctionnalité. La dette technique s’accumule donc encore plus vite.
De l’autre côté, l’équipe chargée du nouveau système part avec enthousiasme sur une base vierge. Puis la réalité s’impose : personne ne comprend vraiment l’intégralité des comportements du système qu’il s’agit de remplacer. Willison note que si ce système était bien documenté et testé, il n’aurait pas besoin d’être remplacé en premier lieu.
Sous la pression de livrer, le nouveau système finit par être mis en production pour couvrir un sous-ensemble des fonctionnalités de l’ancien - ou pour une nouvelle fonctionnalité trop difficile à implémenter dans le code legacy. Résultat : un ancien système bancal que personne ne veut toucher, et un nouveau système dont «80 % du code est inactif» et destiné à remplacer l’ancien, un jour.
Le risque terminal survient si l’opération s’étire trop longtemps : les priorités changent, le travail de remplacement complet est abandonné, et l’entreprise se retrouve avec deux systèmes à maintenir indéfiniment.
Pour ceux qui se retrouvent dans cette situation, Willison recommande la lecture de Migrations: the sole scalable fix to tech debt de Will Larson, qu’il décrit comme le meilleur article qu’il ait lu sur la façon de mener ce processus de manière responsable.
Sa propre recommandation pratique : renforcer l’ancien système avec autant de tests automatisés que possible, puis tenter des refactorisations ciblées pour lui donner la forme souhaitée. «Mon intuition est que dans beaucoup de cas, cela aura bien plus de chances de succès que l’appel des sirènes d’un remplacement greenfield», écrit-il.
More on this from PROMPTIF


 actualités·Un rapport révèle que jusqu’à 20 % des nouveaux domaines gTLD enregistrés en 2025 seraient frauduleux