Édition vidéo conversationnelle dans Gemini Omni 1.2 : notre test
Gemini Omni 1.2 Flash promet d'éditer vos vidéos via un simple prompt. Fonctionnement, limites en Europe et résultats de notre test lors du lancement.
👁 116 lectures
L’édition vidéo en mode conversationnel est l’une des nouveautés phares mises en avant par Google pour le lancement de Gemini Omni 1.2 Flash, aux côtés des séquences de 15 secondes et d’une baisse des tarifs. Le principe est séduisant : vous générez un plan, puis vous donnez vos instructions textuelles comme à un monteur. Changez l’arrière-plan, remplacez un objet, transformez le jour en nuit ou passez au format vertical. Au lieu de recalculer l’intégralité du rendu, le modèle conserve la scène de base et modifie uniquement votre demande. Avec la version 1.2, cette retouche s’applique désormais sur des séquences complètes de 15 secondes.
J’ai voulu mettre cette promesse à l’épreuve sur mes propres créations dès le jour de la sortie, le 5 novembre 2026. L’expérience n’a pas fonctionné comme prévu, et ce retour d’expérience est tout aussi instructif. Voici le détail du fonctionnement théorique selon Google, la méthode testée, les blocages constatés et les restrictions légales qui s’appliquent chez nous.
Comment fonctionne l’édition selon Google
Dans l’application Gemini, Flow ou Google Vids, l’édition prend simplement la forme d’un message supplémentaire dans votre fil de discussion. Dans l’API, l’architecture repose sur ces mécanismes :
- Chaque génération constitue une « interaction » disposant de son propre identifiant. Pour apporter une correction, vous soumettez une nouvelle requête intégrant le paramètre
previous_interaction_id, sans devoir réimporter le fichier vidéo. - Chaque itération produit une nouvelle séquence construite sur la base de la précédente. Vous pouvez ainsi peaufiner votre rendu par étapes : le décor d’abord, puis l’éclairage, puis la météo.
- Si vous désactivez l’enregistrement des données (
store=false), la vidéo ne pourra pas être retouchée ultérieurement. - Google conseille de formuler des consignes courtes et d’ajouter la précision « garder tout le reste à l’identique » (en anglais : « Keep everything else the same »).
- Il est également possible de modifier ses propres enregistrements vidéo, dans la limite de 15 secondes.
Parmi les cas d’usage présentés : remplacer un produit ou un décor, adapter l’ambiance lumineuse, modifier les conditions climatiques ou basculer le ratio d’aspect. L’outil permet aussi de prolonger un plan de plusieurs secondes (jusqu’à 30 secondes cumulées) ou de créer une transition continue entre la première et la dernière image.
Attention : restriction stricte dans l’EEE, en Suisse et au Royaume-Uni
C’est une nuance réglementaire majeure pour les utilisateurs européens. Dans l’Espace économique européen, en Suisse et au Royaume-Uni, l’édition et l’extension de vidéos importées par vos soins sont totalement désactivées. Vous ne pouvez modifier ou prolonger que les séquences générées de toutes pièces par le modèle Omni lui-même. De plus, aucune vidéo montrant des personnes mineures ne peut être importée pour retouche dans notre région.
Concrètement, vous ne pourrez pas transformer une vidéo filmée avec votre smartphone pour la passer en ambiance hivernale ou nocturne via Omni. Un clip synthétique créé de zéro, en revanche, y est autorisé. Cette restriction était déjà en place sur la version 1.1 et reste inchangée.
Mon test : cinq essais, cinq échecs
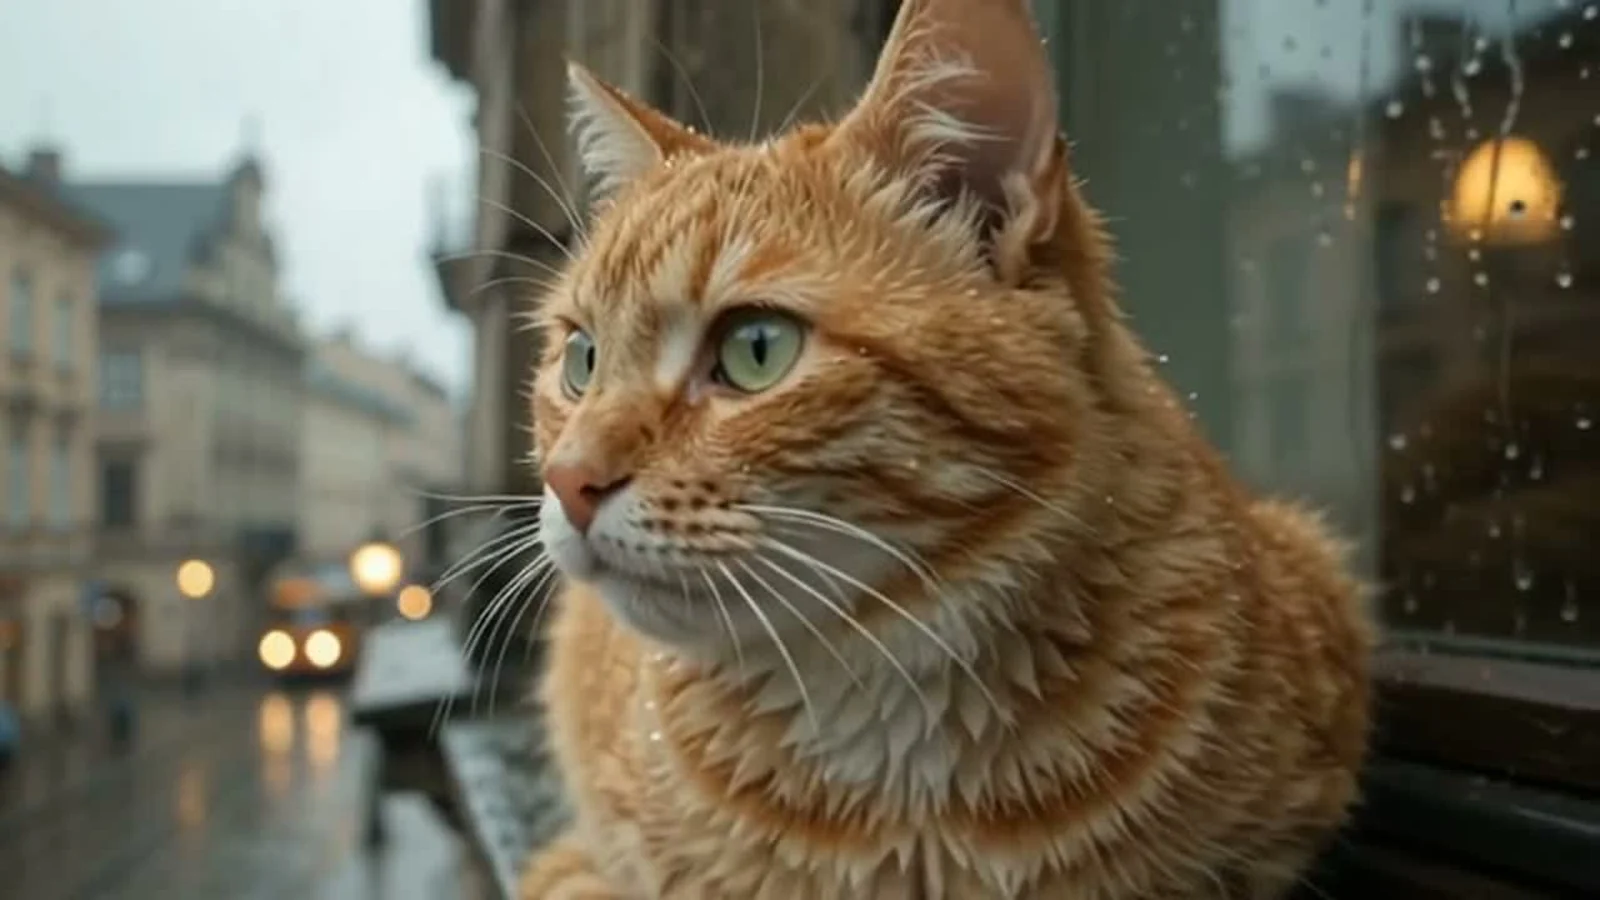
Pour mes tests, j’ai généré les rendus via OpenRouter, qui proposait le modèle google/gemini-omni-1.2-flash dès le jour du lancement le 5 novembre 2026. J’ai d’abord conçu une vidéo de 4 secondes montrant un chat roux sur le rebord d’une fenêtre à Cracovie sous la pluie. J’ai ensuite demandé une modification (requête traduite du test original en polonais) : « change le moment de la journée pour la nuit, un lampadaire jaune éclaire derrière la vitre, la pluie continue de tomber, le chat reste identique ». J’ai soumis la vidéo de cinq manières différentes, en faisant varier les paramètres de tâche et sous forme d’URL publique. Bilan systématique : « Video generation failed ». Heureusement, aucun frais n’a été prélevé.
Ce constat est partagé par d’autres testeurs. L’équipe de Segmind, qui avait également accès au modèle le jour de la sortie, a rapporté que la fonction d’ajustement (« refine ») renvoyait une erreur « not available yet », ce qui les obligeait à réinjecter la vidéo précédente dans un flux d’édition classique. Il apparaît clairement qu’au lancement, l’édition conversationnelle était principalement opérationnelle au sein des interfaces propriétaires de Google et via l’API Gemini directe, les plateformes tierces devant encore finaliser leur intégration.
La solution de contournement par l’image : une fausse bonne idée
J’ai cherché une alternative en détournant la génération par image. J’ai extrait la première image d’un clip existant représentant deux personnes discutant autour d’un barbecue dans un jardin ouvrier. Je l’ai fournie comme image de référence avec cette instruction (traduite du test polonais d’origine) : même scène, mêmes protagonistes, mais en hiver sous de fortes chutes de neige, tous deux portant bonnets et écharpes.
Le résultat montre bien les forces et les faiblesses du moteur. Les personnages, les vêtements, le barbecue et le cadrage sont presque identiques au plan source, et le dialogue en polonais a été prononcé sans interruption. En revanche, aucune trace d’hiver : feuillage vert, lumière chaude estivale, aucun bonnet. Le modèle a privilégié les informations visuelles au détriment de l’instruction textuelle. C’est un atout indéniable pour préserver la cohérence d’un personnage entre deux prises, mais cela rend l’approche inefficace pour une véritable édition de contexte.
Dans quels cas l’édition conversationnelle est-elle pertinente ?
Malgré les soucis techniques rencontrés lors de cette première prise en main, cette fonctionnalité reste sans doute l’évolution la plus prometteuse d’Omni sur le long terme. Avec la plupart des générateurs vidéo, chaque correction vous oblige à relancer un tirage complet, ce qui modifie souvent les visages, le décor ou la dynamique de mouvement. Si les promesses de Google se concrétisent dans les flux de production, cela changera la donne pour les créateurs de publicités ou de formats courts pour les réseaux sociaux. Vous pourrez stabiliser une prise parfaite, puis décliner les versions (nuit, hiver, format vertical) par simple dialogue, sans repartir de zéro.
Pour essayer le modèle dès aujourd’hui :
- Google Vids - clips de 15 secondes sans surcoût pour les comptes Google ou Workspace éligibles ;
- Flow - l’interface de Google dédiée à la mise en scène et à l’ajustement séquentiel ;
- Application Gemini - le support des plans de 15 secondes est déployé progressivement auprès des abonnés Google AI Ultra ;
- API Gemini et Vertex AI - édition complète accessible avec le paramètre
previous_interaction_id.
Je renouvellerai ce test dès que les intermédiaires d’API auront stabilisé la prise en charge de ces paramètres. Pour découvrir les fonctionnalités qui étaient déjà parfaitement opérationnelles le jour de la sortie, consultez mon test complet de Gemini Omni 1.2 Flash, ainsi que notre synthèse globale sur le hub Gemini Omni Flash.
More on this from PROMPTIF


 état de l'ia·Cybersécurité et IA en 2026 : de Mythos à GPT-6 CyberComment l'IA en cybersécurité est passée d'un simple assistant à des usines d'exploits automatisées : retour sur une année charnière jusqu'à GPT-6 Cyber.