Gemini 4 Argon face à Opus 5.5 et GPT-6 Astra : test de 23 tâches
Gemini 4 Argon testé sur 23 tâches pratiques : 99,5 % de réussite pour environ 0,20 € (0,22 USD) et une vitesse record face à Opus 5.5 et GPT-6 Astra.
Mise à jour (9 novembre 2026) : Claude Fable 5.2 et Mythos 5.2 sont sortis - prix, accès et benchmarks dans mon guide Claude Fable 5.2.
👁 123 lectures
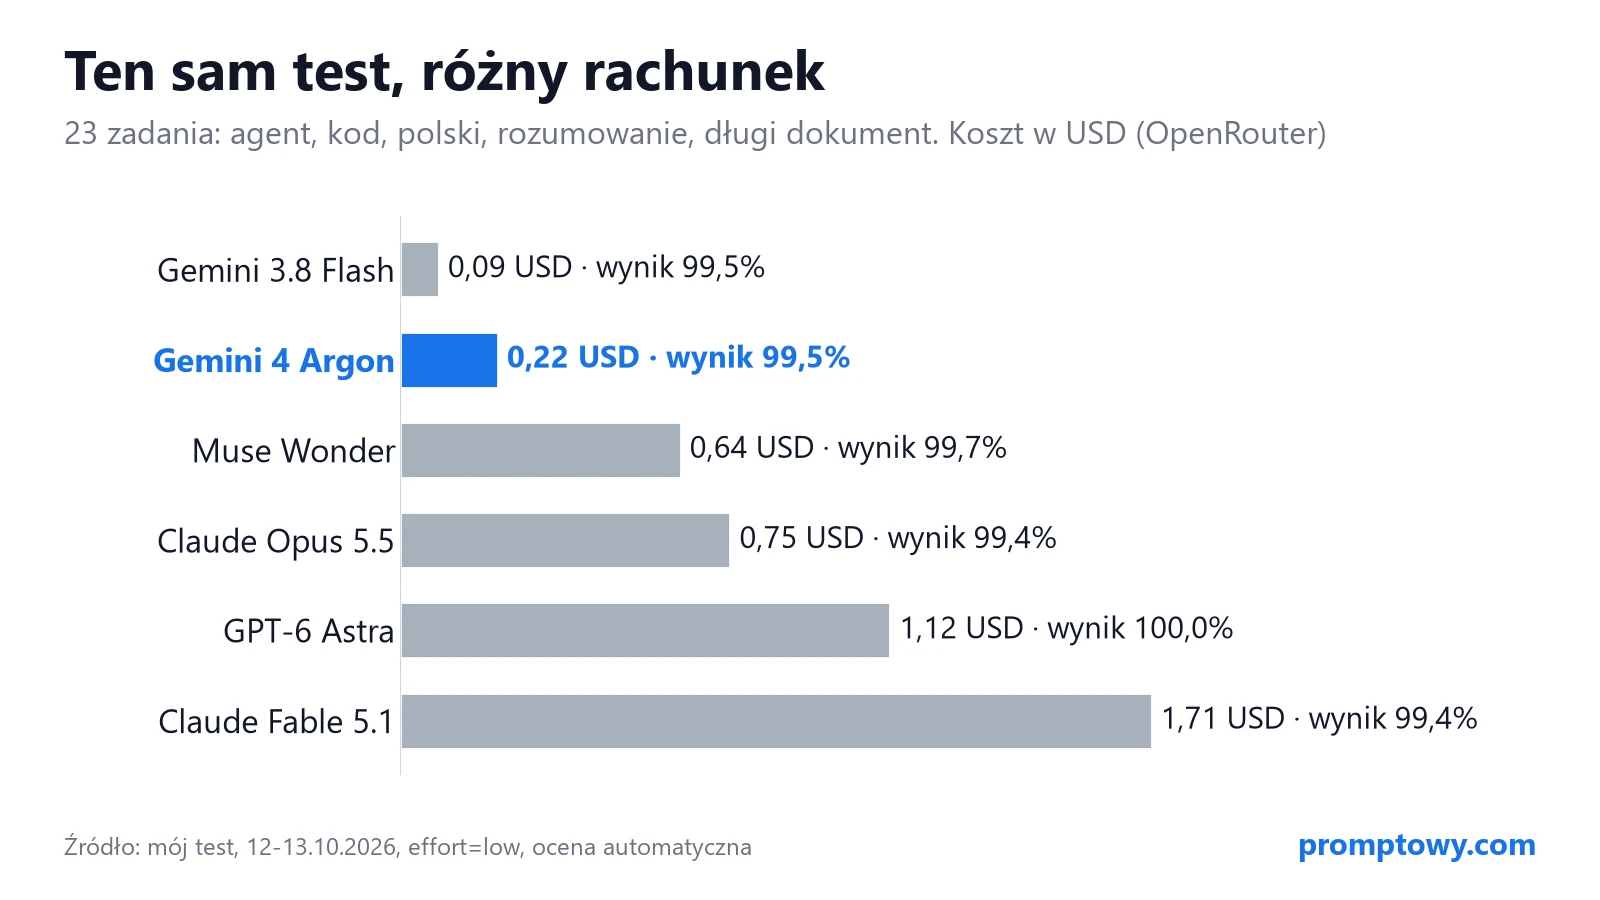
Le 13 octobre 2026 au soir, trente minutes après l’ouverture de l’accès payant à Gemini 4 Argon par Google, je l’ai soumis au même banc d’essai de 23 tâches qu’avaient affronté la veille Muse Wonder, Claude Opus 5.5, Claude Fable 5.1, GPT-6 Astra et Gemini 3.8 Flash. Argon a obtenu un score de 99,5 %, pour un coût d’environ 0,20 € (0,22 USD) et une exécution globale record de 135 secondes. Le seul point perdu s’est avéré être un défaut de mon script d’évaluation, bien qu’un véritable écart rédactionnel se soit glissé quelques paragraphes plus bas. Les détails sur le modèle et sa tarification sont réunis dans le guide Gemini 4 Argon.
Conditions du test du 13 octobre 2026 (soir)
- Modèle :
google/gemini-4-argonvia OpenRouter, niveau de raisonnement réglé sur « low ». - Concurrents : 23 tâches identiques, code et paramètres équivalents exécutés le 12 octobre lors du test de Muse Wonder.
- Évaluation automatique : tests unitaires, vérification des appels d’outils, correspondances exactes, sans juge IA. Chaque point retranché a été contrôlé manuellement.
- Coût d’Argon pour l’ensemble du banc d’essai : environ 0,20 € (0,22 USD) au tarif de lancement (2/10 USD par million de tokens).
Tableau récapitulatif des résultats
| Modèle | Résultat (23 tâches) | Coût | Temps total |
|---|---|---|---|
| Gemini 4 Argon | 99,5% | environ 0,20 € (0,22 USD) | 135 s |
| Muse Wonder | 99,7% | environ 0,57 € (0,64 USD) | 165 s |
| Claude Opus 5.5 | 99,4% | environ 0,67 € (0,75 USD) | 222 s |
| GPT-6 Astra | 100% | environ 1,00 € (1,12 USD) | 200 s |
| Claude Fable 5.1 | 99,4% | environ 1,53 € (1,71 USD) | 263 s |
| Gemini 3.8 Flash | 99,5% | environ 0,08 € (0,09 USD) | 139 s |
Le résultat représente la moyenne non pondérée sur les 23 épreuves. Pour les tâches à critères multiples, la note reflète le pourcentage de critères validés. Parmi les modèles de pointe, Argon se révèle le plus abordable : 3,4 fois moins cher que Claude Opus 5.5, 5 fois moins cher que GPT-6 Astra et 2,9 fois plus économique que Muse Wonder. Seul Gemini 3.8 Flash, un modèle d’entrée de gamme, affiche un coût inférieur. Note sur les devises : conversions estimées selon le cours de référence de la BCE du 12 octobre 2026 (1 EUR = 1,1181 USD ; source : https://www.ecb.europa.eu/stats/eurofxref/eurofxref-daily.xml).
Contenu détaillé du banc d’essai
| Catégorie | Tâches | Méthode d’évaluation |
|---|---|---|
| Agent avec outils (3) | Séjour à Lisbonne avec 3 outils et pièges tarifaires, retour d’article hors délai sur une boutique en ligne, traitement de factures en EUR avec taux bancaire officiel et panne réseau simulée à la première requête | Exactitude des appels d’outils, décisions et calculs numériques |
| Code (4) | Validation d’identifiants fiscaux, fusion d’intervalles, calcul de jours ouvrés incluant des règles de congés spécifiques, conversion de montants en lettres pour facturation | 51 tests unitaires exécutés localement |
| Langue polonaise (4) | Correction de 10 fautes, synthèse en 3 points sous la limite de 60 mots, recours administratif officiel, déclinaisons grammaticales complexes | Grille d’évaluation stricte et correspondance textuelle exacte |
| Raisonnement (11) | Combinatoire, énigmes de calendrier, aiguilles d’horloge, chevaliers et coquins | Réponse exacte attendue |
| Document long (1) | 80 procès-verbaux de conseil d’administration (158 111 caractères en polonais), 5 questions ciblées dont une décision révoquée ultérieurement et une mention absente | Réponses factuelles exactes |
À noter : les épreuves linguistiques, la validation de documents longs et certaines logiques d’affaires ont été testées directement en langue polonaise.
Résultats catégorie par catégorie
| Catégorie | Gemini 4 Argon | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|
| Agent | 100%, 0,022 € (0,025 USD) | 100%, 0,081 € (0,091 USD) | 100%, 0,089 € (0,100 USD) |
| Code | 100%, 0,025 € (0,028 USD) | 100%, 0,074 € (0,083 USD) | 100%, 0,116 € (0,130 USD) |
| Langue polonaise | 97,2%, 0,020 € (0,022 USD) | 96,4%, 0,098 € (0,110 USD) | 100%, 0,097 € (0,108 USD) |
| Raisonnement | 100%, 0,039 € (0,044 USD) | 100%, 0,102 € (0,114 USD) | 100%, 0,075 € (0,084 USD) |
| Document long | 100%, 0,092 € (0,103 USD) | 100%, 0,317 € (0,355 USD) | 100%, 0,622 € (0,695 USD) |
Le meilleur résultat par ligne figure en gras (ou le coût le plus faible en cas d’égalité). Les autres modèles ont flanché sur des points spécifiques : Muse Wonder en programmation (98,4 %, génération d’un terme inexistant en toutes lettres), Gemini 3.8 Flash également en code (96,9 %, erreur de date d’entrée en vigueur de jours fériés), et Claude Fable 5.1 ainsi qu’Opus 5.5 sur le test de langue (96,4 %, dépassement de la limite stricte de 60 mots).
Facture et rapidité : les atouts d’Argon
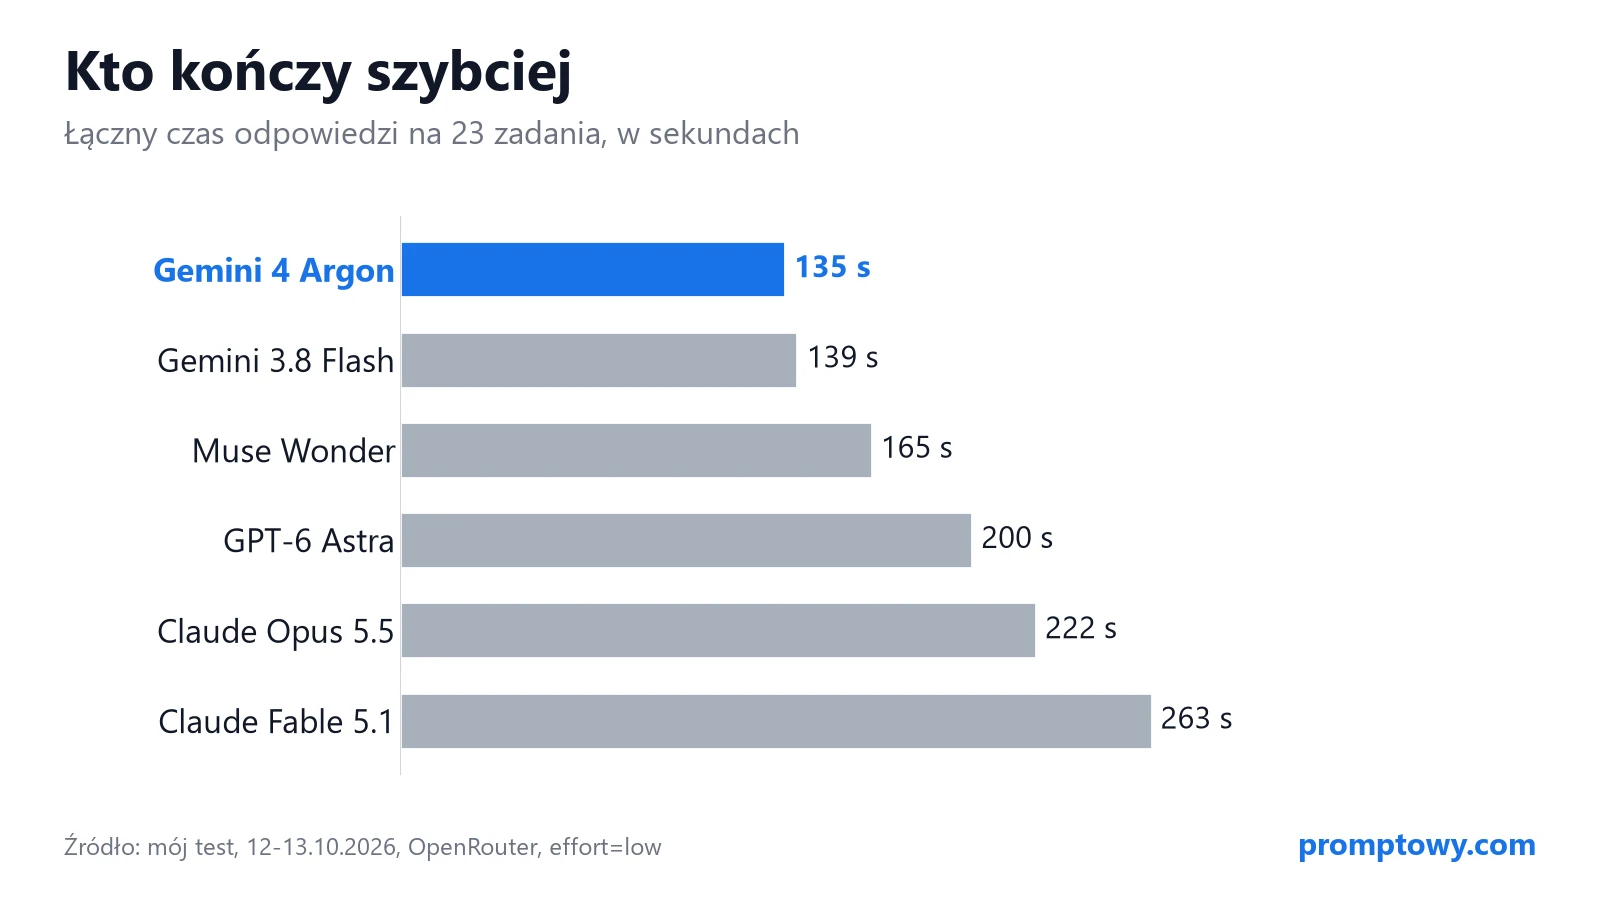
Argon fournit des réponses brèves sans temps mort. Via OpenRouter en mode « low », il n’a reporté aucun token de réflexion explicite sur l’ensemble des 23 tâches, terminant par exemple la correction textuelle de 10 erreurs en 2,6 secondes. À titre de comparaison, Muse Wonder a mobilisé 636 tokens de raisonnement rien que pour structurer l’itinéraire de voyage. Quelques observations clés :
- Planification de voyage : 4 appels d’outils en 2 étapes, évitement des pièges (vol trop matinal et hôtel sous la note minimale), choix judicieux d’un musée face à une probabilité de pluie de 80 %, pour seulement environ 0,010 € (0,011 USD).
- Gestion de retour en e-commerce : identification correcte de la commande, refus légitime de validation du retour en expliquant au client que l’échéance de 30 jours était dépassée (32 jours après livraison).
- Conversion de factures : relance appropriée après réception d’une erreur HTTP 503 du service bancaire, exclusion de la facture déjà acquittée et totalisation exacte.
- Document volumineux : 5 réponses correctes sur 5 délivrées en 4,5 secondes pour environ 0,09 € (0,10 USD). Le modèle a repéré qu’une surface d’entrepôt avait été rectifiée à 6 200 m² dans une séance ultérieure et a retourné l’absence de mention concernant une campagne TikTok. Seul GPT-6 Astra s’est montré plus véloce (3,5 s), mais pour un montant d’environ 0,62 € (0,69 USD).
Sur les textes longs, l’efficacité de la tokenisation joue un rôle déterminant. Les 158 111 caractères du corpus représentent 51 482 tokens pour Argon, contre 87 675 pour Claude, soit 70 % de jetons supplémentaires pour ce dernier. Avec un coût nominal par token déjà plus avantageux, l’analyse des 80 procès-verbaux a coûté environ 0,09 € (0,10 USD) sur Argon, contre 0,17 € (0,19 USD) sur Muse Wonder (pourtant plus dense avec 46 929 tokens, mais facturé 4 USD le million en entrée), 0,32 € (0,35 USD) sur Opus 5.5, 0,62 € (0,69 USD) sur Astra et 0,79 € (0,88 USD) sur Fable 5.1.
Courrier administratif : une pénalité indue et une vraie hallucination
Le script automatisé n’a accordé que 8 points sur 9 à Argon lors de la rédaction d’un recours contre une décision administrative de refus de rente. Le critère manquant portait sur l’intitulé exact de la juridiction de recours. En consultant la réponse, le tribunal était bien renseigné, mais formulé avec une déclinaison grammaticale polonaise au génitif (« Au Tribunal de district… »). Mon script exigeant la forme nominale brute, l’erreur incombait à l’évaluateur et non au modèle. Corrigé à la main, Argon atteindrait 100 %, à égalité avec GPT-6 Astra. Le résultat automatique initial a toutefois été maintenu dans le tableau pour respecter une règle d’évaluation identique entre tous les concurrents.
Sur le fond juridique, le modèle a bien calculé le délai légal d’un mois en décalant l’échéance au premier jour ouvrable suivant en raison du calendrier. La réelle faiblesse réside dans l’argumentation : alors que les données d’entrée mentionnaient uniquement l’omission d’un dossier cardiologique datant de 2026, Argon a extrapolé de sa propre initiative des symptômes médicaux détaillés et une accusation formelle de superficialité envers le médecin examinateur (traduction du texte polonais généré) :
« Les symptômes de la maladie, tels qu’une fatigabilité rapide, des dyspnées d’effort, des variations de tension artérielle ainsi que des douleurs thoraciques, m’empêchent de mener une vie quotidienne normale (…) »
« Le médecin conseil, en rendant sa décision, a procédé à un examen de manière superficielle (…) »
Claude Opus 5.5 avait lui aussi suggéré l’ajout de symptômes, mais les avait placés entre crochets comme éléments indicatifs à compléter par l’utilisateur. Argon les a intégrés directement comme des vérités établies. Devant une juridiction où les pièces écrites sont confrontées aux expertises médicales, une telle invention peut s’avérer préjudiciable : la relecture systématique demeure indispensable.
Évolution tarifaire après la phase de lancement
Le tarif promotionnel de 2 USD par million de tokens en entrée et 10 USD en sortie (environ 1,79 € et 8,94 €) s’applique jusqu’au 30 novembre 2026. À compter du 1er décembre 2026, la tarification d’Argon passera à 4 / 20 USD, s’alignant sur celle d’Opus 5.5 et de Muse Wonder. À volume de tokens identique, le coût de ce banc d’essai doublera approximativement :
| Modèle | Tarif pour 1M de tokens (entrée / sortie) | Coût estimé du banc de 23 tâches |
|---|---|---|
| Gemini 4 Argon (jusqu’au 30.11) | environ 1,79 € / 8,94 € (2 / 10 USD) | environ 0,20 € (0,22 USD) |
| Gemini 4 Argon (dès le 01.12) | environ 3,58 € / 17,89 € (4 / 20 USD) | environ 0,40 € (~0,45 USD) |
| Muse Wonder | environ 3,58 € / 17,89 € (4 / 20 USD) | environ 0,57 € (0,64 USD) |
| Claude Opus 5.5 | environ 3,58 € / 17,89 € (4 / 20 USD) | environ 0,67 € (0,75 USD) |
| GPT-6 Astra | environ 8,94 € / 44,72 € (10 / 50 USD) | environ 1,00 € (1,12 USD) |
| Claude Fable 5.1 | environ 8,94 € / 44,72 € (10 / 50 USD) | environ 1,53 € (1,71 USD) |
| Gemini 3.8 Flash | environ 0,67 € / 3,35 € (0,75 / 3,75 USD) | environ 0,08 € (0,09 USD) |
Même après cette augmentation, Argon demeurera environ 1,7 fois moins cher qu’Opus 5.5 sur cet ensemble de requêtes. Deux raisons l’expliquent : une grande concision sans tokens de réflexion facturés et un tokenizer plus compact. Le coût de la mise en cache (input cache) passera également d’environ 0,09 € (0,10 USD) à 0,18 € (0,20 USD) par million de tokens.
Limites méthodologiques du comparatif
- Effort réglé sur low : l’ensemble des modèles a été sollicité avec un niveau d’inférence minimal pour comparer des requêtes standardisées et abordables. Les chiffres publiés par Google mobilisent un niveau de raisonnement supérieur.
- Échantillon réduit à passage unique : 23 tâches exécutées une seule fois chacune. Un écart d’un seul point n’établit pas une supériorité structurelle.
- Exécutions décalées : les compétiteurs ont été exécutés le 12 octobre et Argon le 13 octobre, peu après son lancement. Bien que le code et les prompts soient identiques, la latence dépend des charges serveurs instantanées.
- Effet de plafond : avec des taux de succès situés entre 99 % et 100 %, l’épreuve discrimine principalement le coût et le temps de traitement, mais ne prétend pas jauger les limites cognitives extrêmes sur des problèmes ultra-complexes.
- Automatisation des scores : le contrôle automatisé vérifie la conformité logique et factuelle, pas l’élégance rédactionnelle.
- Passerelle OpenRouter : les mesures ont été faites via OpenRouter et non sur l’API directe Google Gemini.
En conclusion
Sur des cas d’usage pratiques, Gemini 4 Argon égale le comportement d’Opus 5.5, d’Astra ou de Fable 5.1 tout en réduisant drastiquement les dépenses et le délai de réponse. Durant sa phase tarifaire initiale, il s’impose comme le modèle premium le plus économique testé à ce jour. Ses faiblesses se situent au niveau de l’invention de faits non fournis dans les contextes rédactionnels rigides, et sur la finesse littéraire où Opus 5.5 conserve une avance appréciable (notamment évaluée dans mon comparatif dédié Gemini 4 Argon face au polonais avec un score de 81,8 points contre 90,1 pour Opus). Il s’agit d’une observation indépendante issue d’un banc d’essai mené le 13 octobre 2026.
Foire aux questions
Gemini 4 Argon est-il meilleur que Claude Opus 5.5 ?
Sur mon benchmark de 23 tâches, la justesse globale est quasi équivalente (99,5 % contre 99,4 %). Argon se montre 3,4 fois plus abordable et nettement plus rapide. Opus 5.5 garde l’avantage sur le style et la prudence rédactionnelle sans extrapolation non sollicitée.
Quel est le prix de l’API de Gemini 4 Argon ?
Jusqu’au 30 novembre 2026, l’accès est fixé à 2 USD par million de tokens en entrée et 10 USD en sortie (environ 1,79 € et 8,94 €). Dès le 1er décembre 2026, les tarifs passent à 4 USD en entrée et 20 USD en sortie (environ 3,58 € et 17,89 €).
Comment ce test a-t-il été réalisé ?
Les requêtes ont été soumises via la plateforme OpenRouter (modèle google/gemini-4-argon) lors de son déploiement le 13 octobre 2026.
Sources
- Banc d’essai personnel via OpenRouter : Gemini 4 Argon testé le 13.10.2026, modèles comparatifs le 12.10.2026, 23 tâches, effort=low, validation automatisée et revue manuelle
- OpenRouter : Gemini 4 Argon (tarifs et contexte)
- Gemini API : grille tarifaire officielle
- Google : Gemini 4 Argon: Built to solve your hardest problems (13.10.2026)
- Google DeepMind : rapport d’évaluation technique Gemini 4 Argon
More on this from PROMPTIF